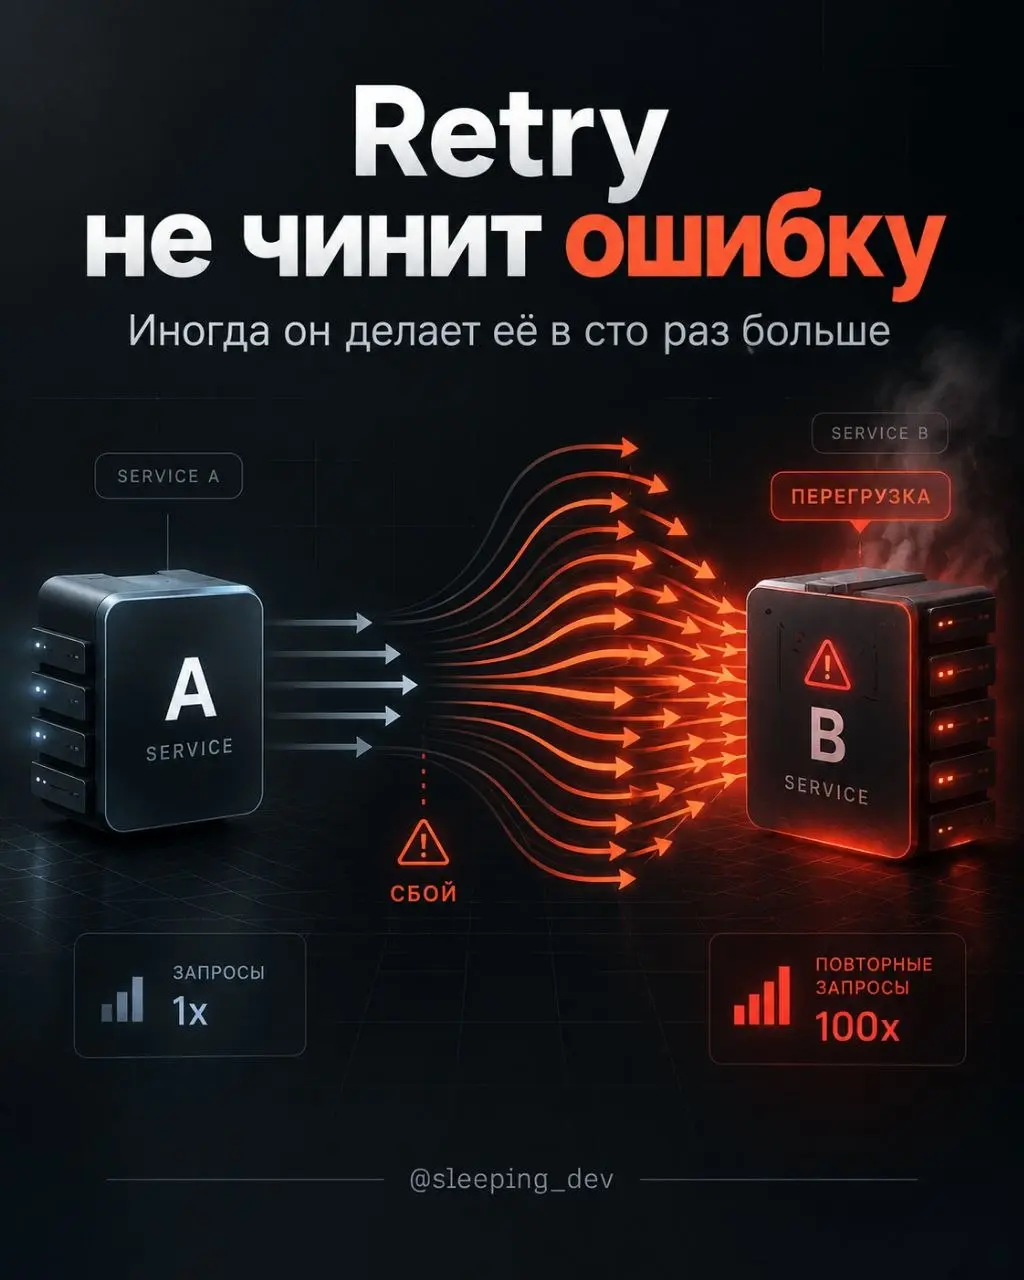
Retry не чинит ошибку. Иногда он делает её в сто раз больше
Сервис B не отвечает. Сервис A делает retry. Потом ещё один. И ещё один.
Таких экземпляров A — сто. У каждого свой поток запросов и своё желание довести дело до конца.
B начинает оживать, но вместе с новыми запросами получает волну повторных.
Теперь он снова лежит.
Формально мы добавили отказоустойчивость. Фактически — организовали дополнительную нагрузку на сервис, который не справлялся даже с обычной.
Зачем тогда нужны retry?
Для временных сбоев. Соединение оборвалось, инстанс перезапустился, балансировщик отправил запрос на уже недоступную машину. Следующая попытка действительно может сработать.
Но если запрос не проходит валидацию, повтор не исправит данные. Если нет прав, настойчивость их не добавит. Если сервис перегружен, немедленный повтор может только ухудшить ситуацию.
Retry нужен не для гарантии успеха. Он нужен для обработки временных сбоев.
Поэтому «повторить при любой ошибке» — плохая политика. Нужны конкретные правила.
1. Разделить ошибки
Сетевой сбой, timeout, некоторые 5xx — кандидаты на повтор, а не автоматическое разрешение.
Для 429 нужно учитывать ограничение частоты и Retry-After, если сервер его передал. Ошибки валидации и доступа бессмысленно повторять без изменения запроса или условий.
Смотреть нужно не только на код ответа, но и на контракт операции: безопасно ли вообще выполнить её ещё раз?
2. Увеличивать паузу
Exponential backoff — это растущая задержка между попытками. После каждого сбоя ждём дольше, но не выше заданного предела.
Смысл простой: дать зависимости время восстановиться, а не проверять её здоровье непрерывным потоком запросов.
3. Добавить случайность
Если все экземпляры A получили ошибку одновременно и ждут одинаковое время, повторять они тоже придут одновременно.
Backoff без случайности может просто перенести пик нагрузки.
Jitter добавляет случайный разброс задержек, чтобы клиенты возвращались не строем.
Иначе возникает retry storm: ошибки вызывают повторы, повторы увеличивают нагрузку, нагрузка вызывает новые ошибки.
4. Не забыть про идемпотентность
Здесь возвращаемся к предыдущей теме.
Timeout означает, что клиент не дождался ответа. Он не означает, что сервер ничего не сделал.
Сервис мог списать деньги, сохранить заказ и потерять соединение до отправки ответа. Повторяем запрос — рискуем повторить действие.
Для такой операции нужен механизм идемпотентности. Например, ключ, по которому сервер распознаёт повтор и возвращает результат уже выполненной операции, не выполняя её заново.
Важно: ключ должен оставаться тем же на всех попытках. Новый ключ на каждый retry — это уже новые операции.
5. Ограничить попытки и время
У повторов должен быть конец: лимит попыток и общий дедлайн, включая ожидание между ними.
И стоит проверить, кто именно повторяет запрос. Если это одновременно делают приложение, SDK и прокси, число реальных обращений может оказаться сильно больше, чем ожидает разработчик.
Даже backoff и jitter не делают бесконечные повторы безопасными.
Хорошая retry-политика отвечает на четыре вопроса: что повторяем, безопасно ли это, сколько ждём и когда останавливаемся.
Но есть следующий уровень проблемы.
Если соседний сервис продолжает лежать, зачем каждому новому запросу заново проходить весь путь из таймаутов и повторов?
В какой момент стоит вообще перестать к нему ходить — и как понять, что уже можно вернуться?
Это уже про circuit breaker.