Продакт учит ML, куда меня завели курсы и любопытство
Последние несколько месяцев я более углубленно разбираюсь в Machine Learning. Цель: хочу понимать, как это работает изнутри, своими руками собирать типовые модели и более продуктивно разговаривать с DS-командой.
Зачем это продакту? Покажу на своём опыте. Я запускал Едем.рф (аналог BlaBlaCar), работал с недвижимостью в Домклик и готовил к запуску тревел продукты в Погнали. И в каждом из этих доменов ML отвечает на конкретные денежные вопросы: 1. Карпулинг: какая цена поездки будет справедливой и для водителя, и для пассажира? Кто из пользователей бросит платформу после первой поездки? 2. Недвижимость: как оценить риелтора по имеющимся данным? Какой лид горячий, а какой просто смотрит красивые карточки? 3. Тревел: как предсказать динамику цен на билеты и отели? Какие листинги в маркетплейсе сконвертируют в бронь, а какие будут просто висеть?
Раньше я отвечал на такие вопросы через метрики, когорты и юнит-экономику. Позже мне помогала DS-команда, теперь хочу типовые кейсы просчитывать своими руками.
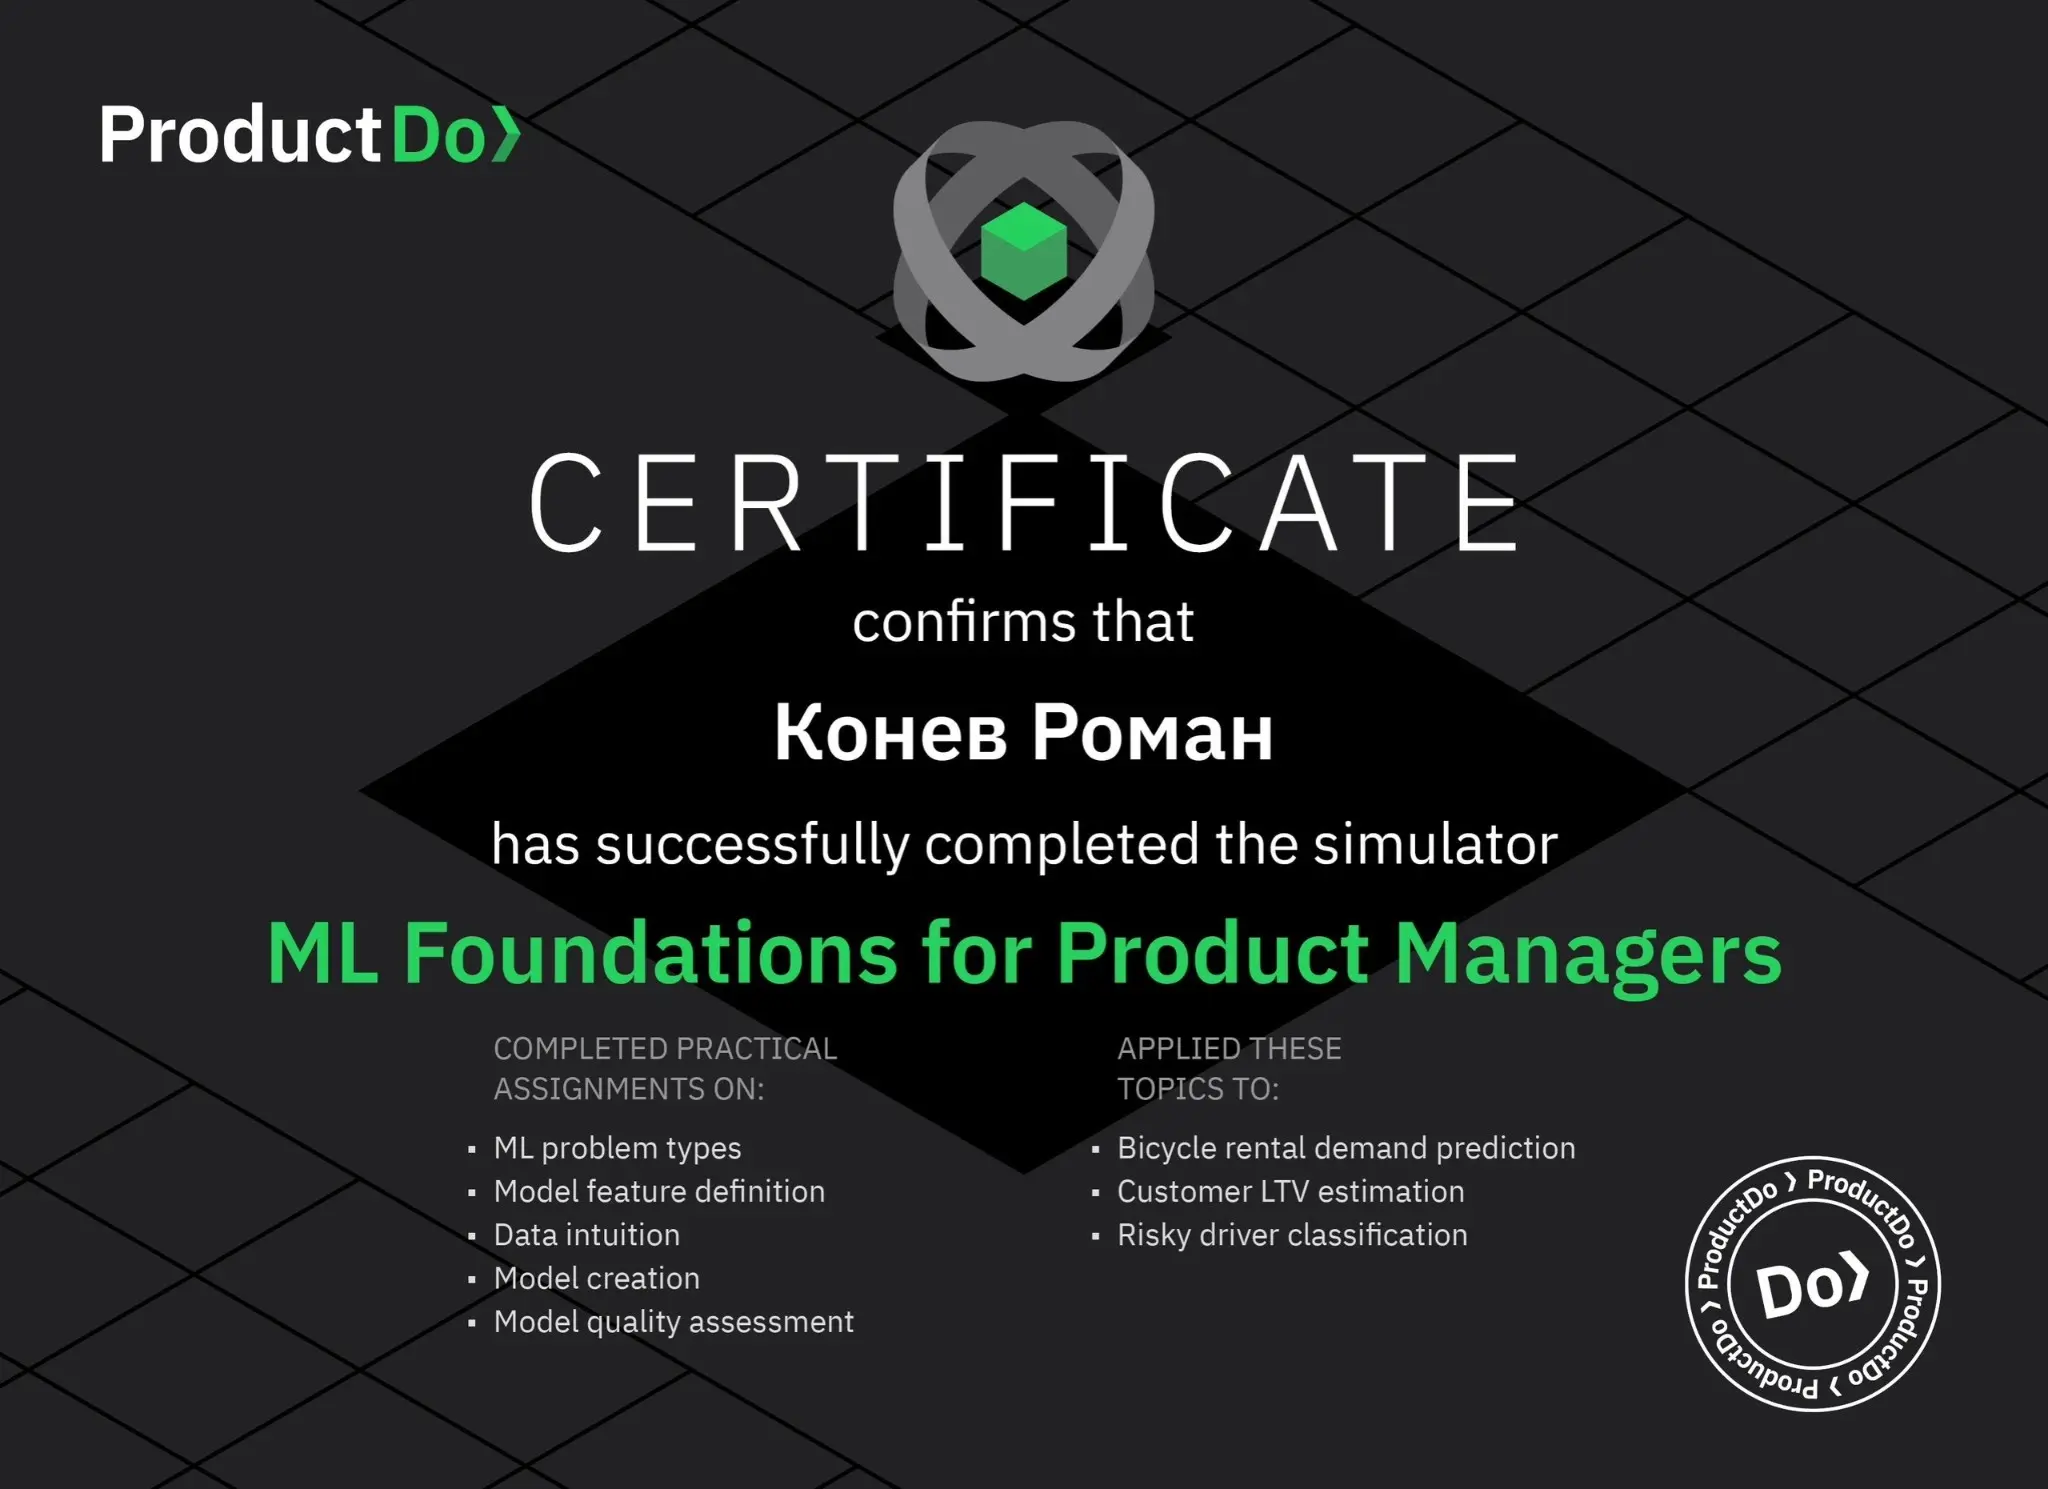
Как всё развивалось: 1. Сначала прошёл курс по ML на ProductDo (рекомендую). Разобрался в метриках регрессии и классификации т.к. знакомые эксперты говорят, что бизнесу в 90% случаев нужны именно такие модели. Пока многие восхищаются генерированием картинок, компании все таки зарабатывают на прогнозе Churn, LTV, конверсий и т.д. 2. Потом стало еще интереснее и я пошел на курс Data Science от Глеба Михайлова (очень рекомендую). Подтянул Python и Pandas и это оказалось вполне выполнимым челенджем. Сейчас пишу свою первую ML-модель в Google Colab, регрессию. Следом на очереди классификация. И да, учебных датасетов по любому направлению на kaggle.com хватает, так что можно практиковаться сразу на знакомых доменах. 3. Параллельно освоил Hermes Agen, развернул его на VPS, подключил openrouter и свой сlaude. Мой агент теперь доступен круглосуточно и не спит по ночам в отличие от меня. Так же тестирую локальные модели через LM Studio. 4. Начал читать профильные книги для развития гругозора: Создание продуктов на базе ИИ (Мэрили Ника), Машинное обучение для абсолютных новичков (Оливер Теобальд), RAG и генеративный ИИ (Дэнис Ротман).
Лайфхак от человека, который мыслит SQL-запросами, подключите библиотеку DuckDB и пишите SQL прямо по датасету. Порог входа заметно ниже, проверено на себе.
Для начинающих коротко о регрессии и классификации: 1. Регрессия предсказывает число. Например, оцениваем стоимость квартиры по площади, району и этажу. Смотрим на метрики MAE, RMSE, R2 они показывают, насколько модель врёт и честна ли она с нами. 2. Классификация раскладывает всё по полочкам. Например, находим пользователей карпулинга, которые собираются уйти к конкуренту. Тут смотрим на Accuracy, Precision, Recall, F1.
Что дальше: 1. Допилю модели регрессии и классификации, выложу проекты на GitHub. 2. Разберусь с feature engineering, т.к. плохие данные испортят самую красивую модель. 3. Доберусь до RAG. Научу LLM отвечать на вопросы по своим документам, например соберу ассистента, который шарит в базе знаний лучше любого менеджера. 4. Попробую файнтюнинг. Дообучу небольшую модель под конкретную задачу вроде тональности отзывов об отелях или классификации лидов в недвижимости.
Это мой первый опыт и мой пайплайн далеко не идеальный. Я изучаю всё глазами продакт менеджера, а не датасаентиста или программиста.
Если ты DS или ML-инженер, расскажи в комментариях, где я косячу и как сделать лучше, буду очень благодарен!И вопрос к тем, кто внедрял ML, с какой задачи вы начинали и что дало бизнесу самый заметный эффект? Ребята, которые только вступают на этот путь, тоже подключайтесь, обменяемся опытом.
#ProductManagement #MachineLearning #TravelTech #PropTech #Carpool #Rideshare #DataScience #LLM #ProductDo