От простого поиска к многопоточной архитектуре
Сейчас я занимаюсь новым pet-проектом — File Search Processor (FSP).
Это будущая консольная утилита, которая позволит искать информацию в файлах по заданной строке или шаблону, проходя по директориям и их содержимому.
С самого начала было понятно, что проект станет хорошей практикой многопоточности: при работе с большим количеством файлов последовательная обработка может стать узким местом. Но прежде чем переходить к параллельному выполнению, я решил разобраться с архитектурой.
С чего начал
Первым этапом стал простой поиск строки в одном файле. Для поисковой логики я выбрал паттерн Фабричный метод: в будущем планирую добавить поиск по шаблонам и другие варианты поиска, поэтому хотел отделить создание конкретного поискового объекта от остальной логики.
Пока реализован только "SearchLine", который выполняет обычный поиск строки. При этом я понимаю, что паттерн не должен использоваться ради самого паттерна: если в дальнейшем требования изменятся, архитектурное решение тоже может потребовать пересмотра.
Архитектура обработки файлов
Когда я перешёл к обработке директорий, стало очевидно, что здесь пересекается несколько разных задач: навигация по файловой системе, чтение данных, их обработка и координация потоков.
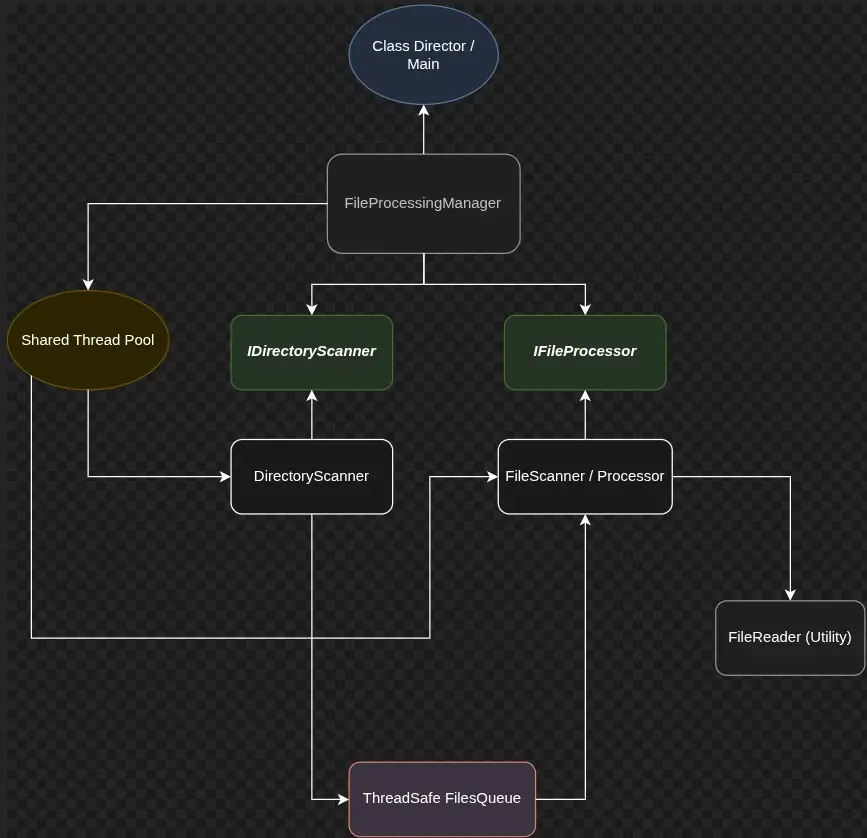
Чтобы не смешивать всё в одном классе, я сделал схему компонентов и начал разделять ответственность между ними. (Смотрите приложенную схему)
Основные компоненты: - DirectoryScanner — отвечает за обход директорий и поиск файлов. Он не должен знать, что происходит с содержимым найденных файлов. - FileReader — отвечает за чтение данных с диска. Его задача — предоставить данные, а не решать, зачем они нужны. - FileScanner/FileProcessor — отвечает за обработку содержимого и поисковую бизнес-логику. - FilesQueue — хранит пути к файлам и отвечает за синхронизацию доступа к очереди между потоками. - FileProcessingManager — координирует работу компонентов и управляет процессом обработки.
Где здесь SOLID?
Я не ставил цель "внедрить все пять принципов". Скорее, SOLID стал способом проверить, насколько удачно я разделил ответственность.
- Single Responsibility. Каждый компонент занимается своей задачей: обходом, чтением, обработкой, очередью или координацией. - Open/Closed. Абстракции вроде "IDirectoryScanner" и "IFileProcessor" позволяют добавлять новые реализации, не привязывая менеджер к конкретному классу. - Liskov Substitution. Если компонент реализует соответствующий интерфейс, его можно заменить другой реализацией без нарушения ожидаемого контракта. Например, в будущем это может быть другой способ сканирования директорий. - Interface Segregation. Вместо одного универсального интерфейса используются специализированные — например, для сканирования директорий и обработки файлов. Это избавляет реализации от методов, которые им не нужны. - Dependency Inversion. "FileProcessingManager" должен зависеть от абстракций, а не от конкретных реализаций. Создание объектов и передача зависимостей выполняются на верхнем уровне приложения.
Что дальше?
Следующий этап — связать компоненты в работающий конвейер обработки файлов, а затем перейти к многопоточному выполнению и измерению производительности. Мне интересно не просто реализовать утилиту, а понять, "где действительно нужны абстракции, как организовать взаимодействие потоков и какие архитектурные решения оправданы на практике".
Проект продолжается, поэтому вполне возможно, что часть текущих решений ещё изменится.
Ссылка на репозиторий проекта GitHub: https://github.com/semens901/File-Search-Processor