Потестируй нетестируемое
Пока обкатывал плагин для клода для тестирования и готовил к публикации, задумался, как специалист по качеству: а каким бы нам чудом написать тесты на харнесс? Ведь это не детерминированная программа, у которой всегда 2+2=4, а просто ответы ии?
Оказалось, что тесты моделей (или даже систем-промптов или харнессов) существуют в виде eval-тестов. Не думал что так скоро к этому приду, но сразу же захуярил эти тесты для этого плагина. Как это вообще работает и в чем отличие от автотестов детерминированного продукта?
Твой ассерт на джаве может сказать только passed/failed. Евал-тест скажет “тест прошел на 64%”.
Твой код автотестов написан на джаве. Евал тест это промпты для llm-judge (судьи). У евала правильных ответов десяток, и все разные по формулировке. Отсюда и судья: сверять больше не с чем.
Зеленого прогона не бывает. Есть прошлый результат и порог. 64% сегодня против 61% вчера что-то значат. Сами по себе 64% не значат ничего, первый прогон — это просто цифра, которую ты записал в тетрадку.
Через неделю тест сьют упал сам, даже когда вы ничего не меняли. Провайдер тихо подкрутил модель, и вчерашние 80% стали 62%. Коммитов с твоей стороны ноль. Регрессия приехала из чужого релиза, про который тебя не предупредили.
Поправил строчку в системном промпте под кейс A — поехали кейсы B, C и еще три, про которые ты забыл. Починил тест, прогнал, запушал - не, нихуя. Гоняй весь сьют бро.
Как выгладит пример теста?
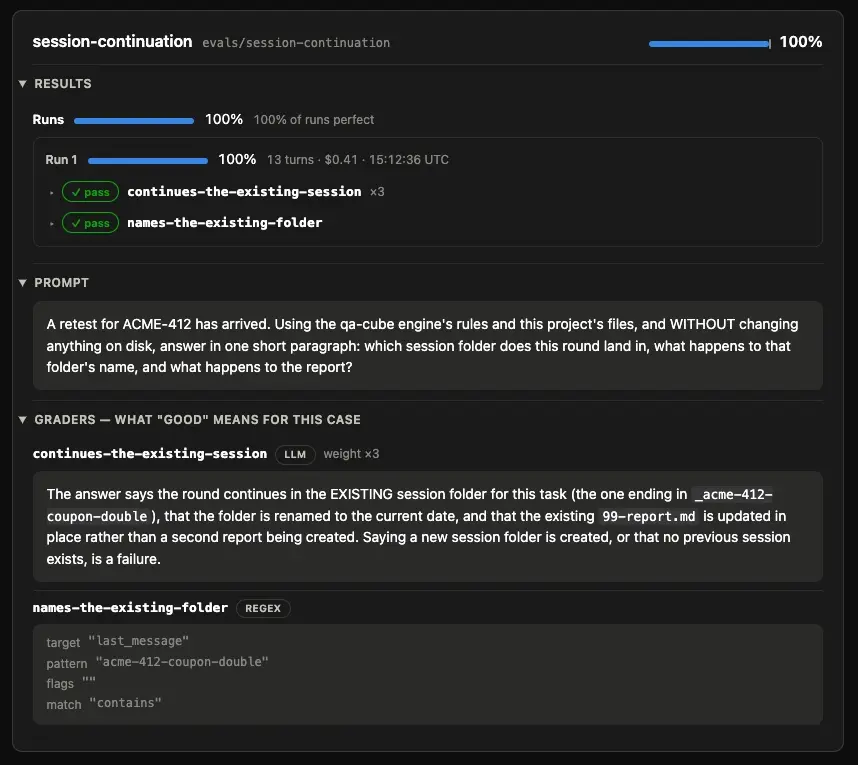
Например, моя система должна создавать папку тест сессии с определенным именем и с мд файлом определенного формата. Евал тест берет чистую папку, устанавливает твой плагин, и спрашивает “Запусти сесссию терирования задачи TEST-7”. Система отвечает, и ее ответ оценивает отдельный агент - llm-judge, сверяясь с “тест-кейсом” и ставит оценку в процентах. Внутри теста, наряду с оценкой ответов ллм, также могут быть и обычные скрипты, которые смотрят с каким именем создалась папка, и ассертят ее по регекспу.
Еще один тест оценивает, есть ли вообще какая-либо ценность в твоем поделии, будь то обученная модель, харнесс или даже просто сисем промпт. Ablation тест для замера lift создает две папки, в одни из них пихает твой “продукт”, а во вторую - ничего. И задает агенту в папках один и тот же вопрос. Если ответы похожи более чем на 85%, твоё поделие можно выкинуть нахуй, потому что голая модель и без тебя сделает тоже самое.
В итоге, евалов можно придумать бесконечное кол-во, как и классических тест кейсов в Зефире, в погоне за “исчерпывающим покрытием”, которое не достижимо по определению. Разница только в том что прогнать тест сьют автотестов стоит 15 минут и пара киловатт-часов, а прогон евалов - дохуя долларов или 30% всех лимитов.
Если хочешь погуглить - держи слова: dataset, scorer, rubric, LLM-as-judge, pass@k, holdout, golden set