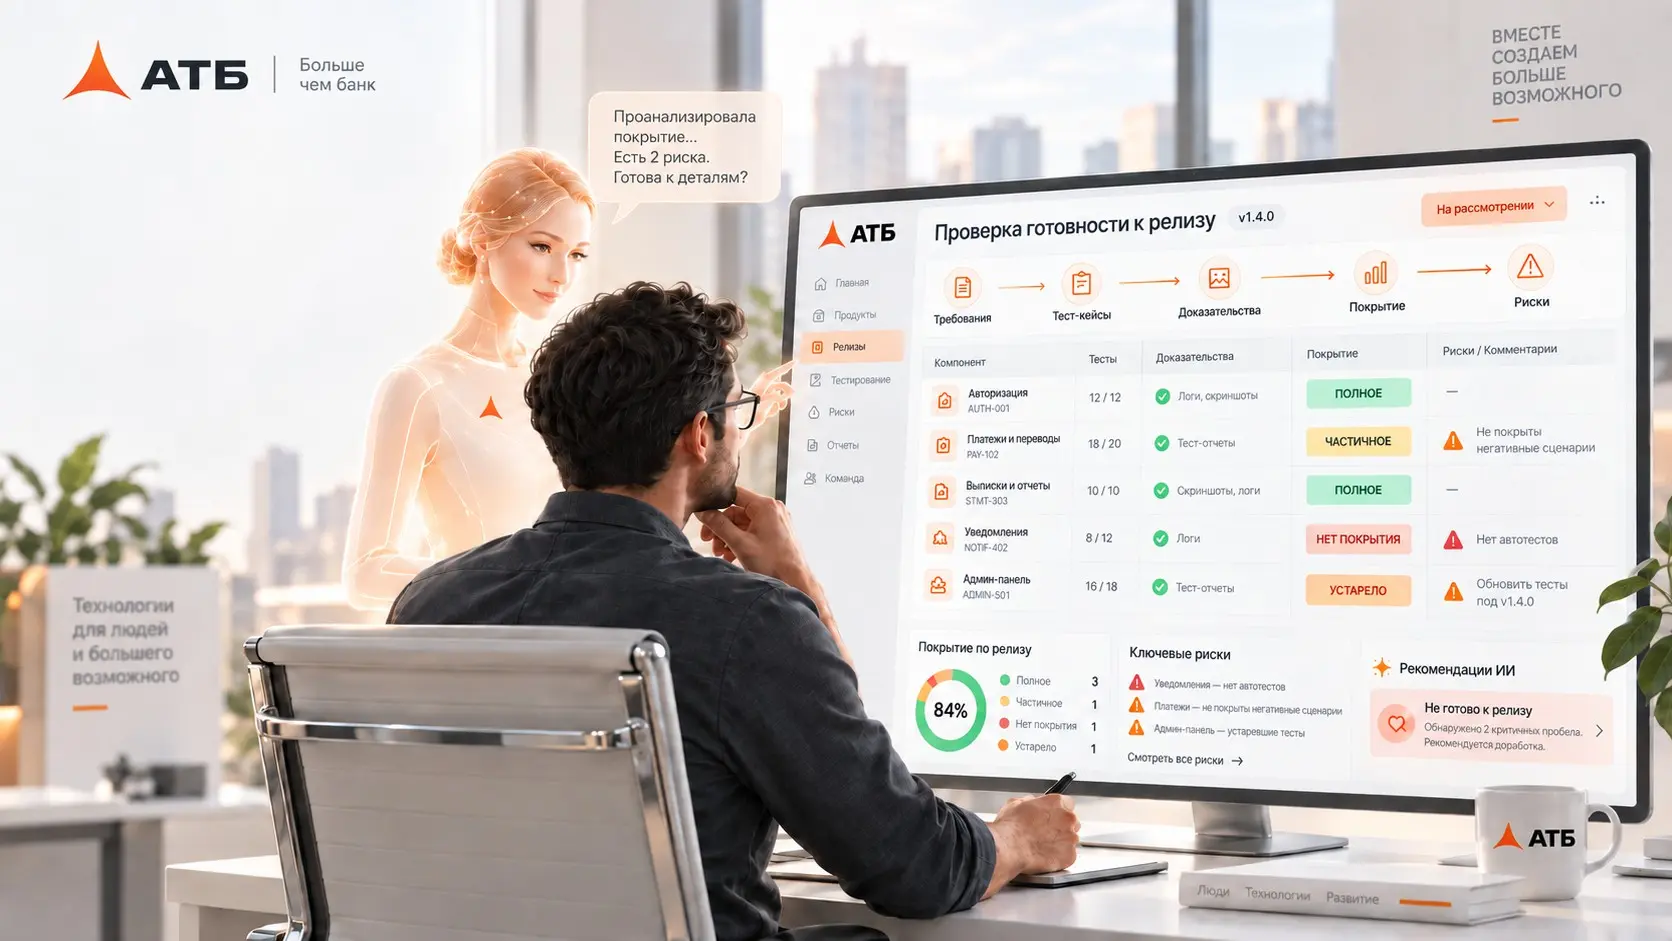
Как мы ии согласование релизов запилили в банке атб
Когда релиз большой, ручная проверка его готовности быстро превращается в квест: открыть Release в Jira, собрать связанные задачи, найти подзадачи, проверить тест-кейсы в Zephyr, убедиться, что они выполнялись, сопоставить требования с шагами и ожидаемыми результатами и понять, что осталось без покрытия. Мы решили автоматизировать эту работу с помощью ИИ.
Важно: система не принимает решение о выпуске релиза вместо человека. Она собирает доказательства, строит матрицу покрытия и показывает тестировщику или тест-лиду, где есть подтвержденное покрытие, а где остались пробелы.
Как это работает: На вход можно передать ссылку на Jira Release или ключ релиза. Сначала сервис собирает связанные Jira-задачи, подзадачи с контекстом. Для каждой задачи ищет связанные Test Case в Zephyr. Если в поле «Протокол ручного тестирования» указан Test Cycle, тест-кейсы из него тоже попадают в анализ. После сбора данных начинается AI-анализ.
Что именно делает ИИ: Мы не просим модель ответить на абстрактный вопрос «релиз покрыт тестами или нет». Qwen получает конкретную Jira-задачу и сначала раскладывает ее на атомарные проверяемые требования. Источником требований выступает только сама задача: summary, description, acceptance criteria и при необходимости environment. После этого каждое требование сопоставляется с реальными шагами Zephyr Test Case. Например, если в Jira написано, что при определенном условии операция должна быть отклонена, недостаточно найти тест-кейс с похожим названием. Модель должна показать конкретный шаг и Expected Result, которые подтверждают это поведение.
В результате требование получает один из статусов: FULL: подтверждено полностью. PARTIAL: подтверждена часть условий. NONE: подтверждающего теста нет. OUTDATED: тест проверяет неактуальное поведение. UNCLEAR: требование сформулировано неоднозначно. NOT_REQUIRED: техническая задача, для которой тест-кейс не обязателен.
Это одна из ключевых вещей, которую мы заложили в решение. После ответа Qwen backend повторно проверяет результат модели. Если модель указала Test Case, которого не было во входных данных, ссылка не принимается. Если она привела цитату из шага или Expected Result, сервис проверяет, что эта цитата действительно существует в Zephyr.
Даже FULL, PARTIAL и OUTDATED нельзя получить просто потому, что модель так решила. Для них требуется фактическое доказательство из тест-кейса. Если оно не проходит проверку, статус понижается.
То же самое с требованиями. Модель обязана указать точную цитату из Jira, из которой она получила требование.
Таким образом, LLM отвечает за смысловое сопоставление, а фактические доказательства контролируются кодом.
Что видит пользователь: На выходе мы получаем не длинный текст от нейросети, а структурированный отчет. В нем есть общий процент полностью подтвержденного покрытия, покрытие с учетом критичности и отдельный показатель по критическим требованиям. Можно провалиться до конкретной Jira-задачи, требования и Test Case и увидеть, каким шагом подтверждено покрытие. Отдельно выводятся основные пробелы: NONE, PARTIAL и OUTDATED. Отчет можно выгрузить в CSV или JSON.
Что в итоге: Самая полезная часть решения оказалась не в том, что ИИ «согласовывает релиз». Он берет на себя трудоемкую часть работы: собирает разрозненные данные и строит трассировку: Jira requirement -> Zephyr Test Case -> шаг -> Expected Result. А человек принимает решение, видя не просто процент покрытия, а конкретные доказательства и конкретные пробелы. По сути, мы получили AI-помощника для проверки готовности релиза, который не заменяет QA, а дает ему прозрачную картину перед согласованием.