https://github.com/firecrawl/anydoc
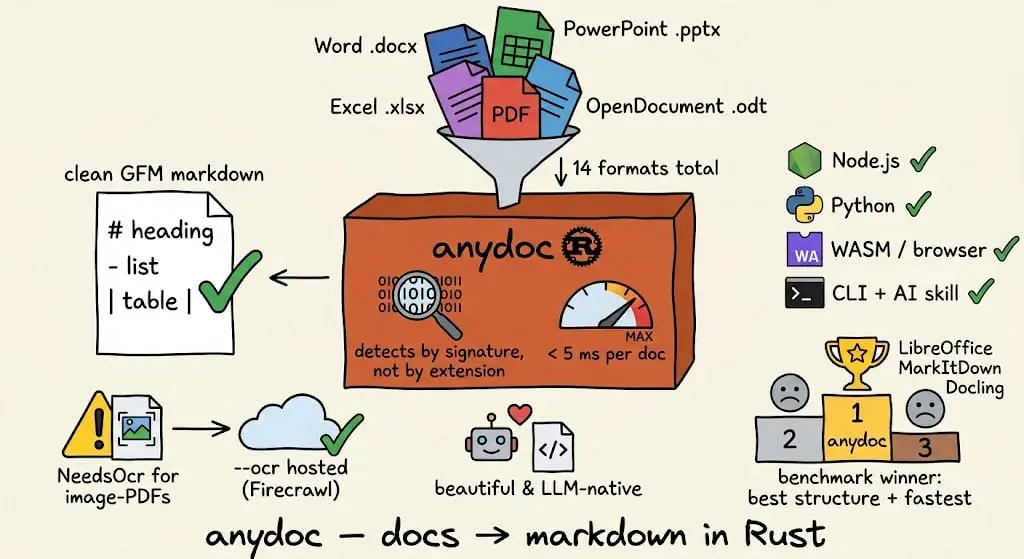
Быстрая библиотека, написанная на Rust, которая конвертирует офисные документы и таблицы в чистый Markdown (в стиле GitHub-Flavored Markdown).
- Медианное время обработки одного документа составляет менее 5 миллисекунд.
- Кроссплатформенность: Помимо самого Rust, библиотека имеет официальные готовые привязки (bindings) для Node.js, Python и браузеров via WebAssembly, а также работает как CLI-утилита и навык для ИИ-агентов (Agent Skill).
- Умное определение форматов: Библиотека распознает тип файла по его внутренним байтам (сигнатуре), а не по расширению. Если расширение файла перепутано, он все равно успешно сконвертируется.
- Единый стандарт на выходе: Все форматы приводятся к общей внутренней модели данных, благодаря чему таблицы, списки, формулы и заголовки форматируются абсолютно одинаково, независимо от того, пришел ли на вход старый документ .doc или современный .pptx.
Инструмент работает с 14 популярными форматами: Документы: Word (.doc, .docx, .docm), OpenDocument (.odt), RTF, EPUB. Таблицы: Excel (.xls, .xlsx, .xlsm, .xlsb), OpenDocument (.ods), CSV. Презентации: PowerPoint (.ppt, .pptx, .pps и др.), OpenDocument (.odp). Фиксированная верстка: PDF (текстовые PDF обрабатываются локально).
Собственного движка распознавания текста (OCR) у anydoc нет — он обрабатывает только текстовые PDF. Если страница является картинкой, библиотека выдает ошибку NeedsOcr. Однако в нее встроена интеграция с облачным сервисом Firecrawl Parse: при включении флага --ocr hosted, отсканированные документы отправляются на распознавание и возвращаются в том же чистом Markdown-виде. В независимых бенчмарках разработчиков против таких утилит, как LibreOffice, Unstructured, MarkItDown и Docling, инструмент занял первое место по качеству структуры и полноте текста на всех 14 типах файлов, оказавшись при этом значительно быстрее конкурентов.
А зачем нам markdown из документов? Ну во-первых это красиво. А еще можно отдавать этот документ нейросетям, потому md для них более "нативный" формат.