Упаковка опыта
Друзья, если кому надо упаковать свой опыт для резюме, то рекомендую наш сервис
https://roadmappers.ru/resume-studio
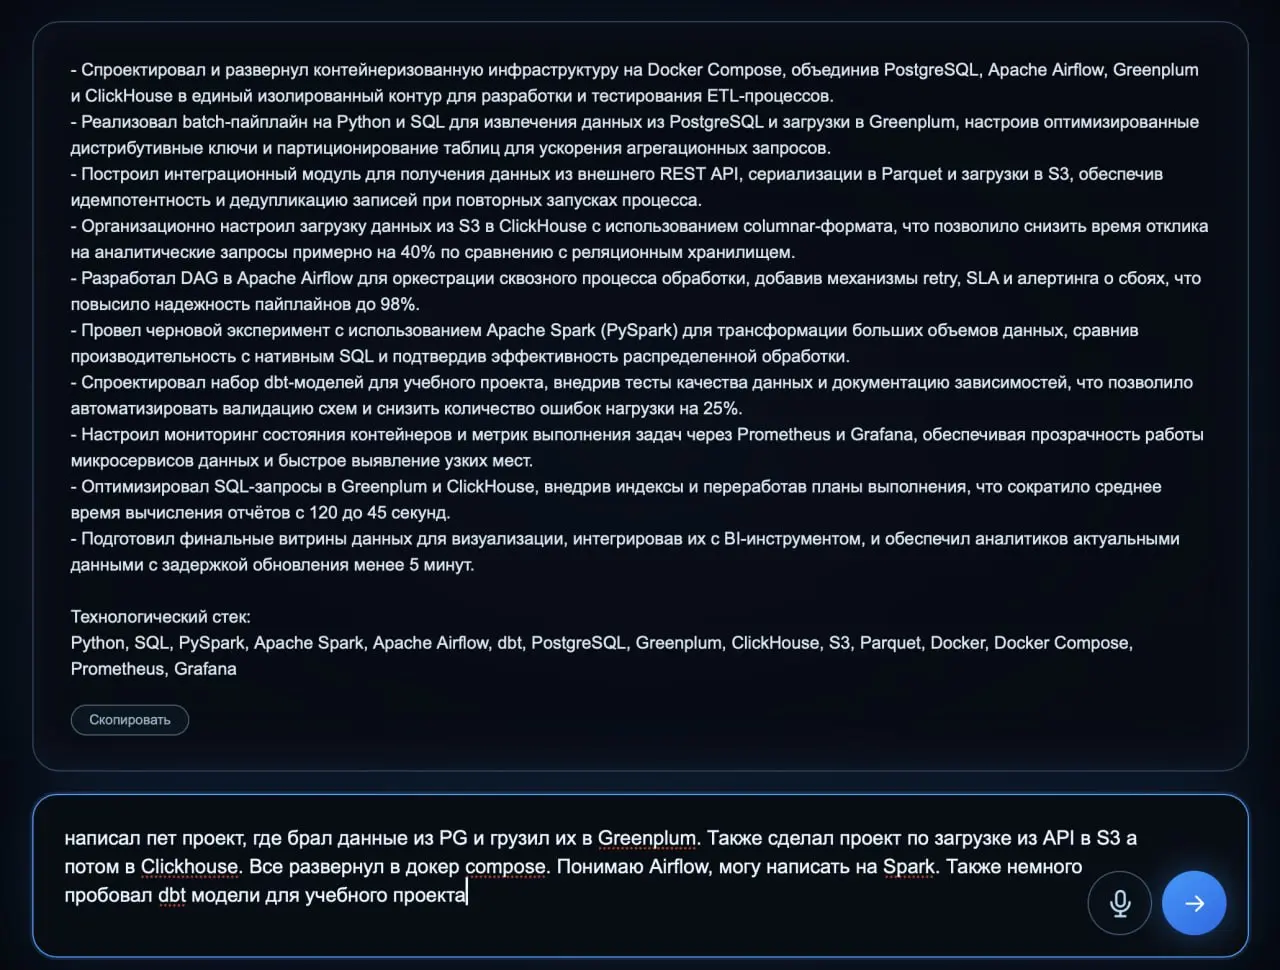
Я специально его сделал. Под капотом LLM. Она берет ваш опыт (буквально любой) и переписывает под Дата Инженера. На скрине я показал, как это работает. При добавлении в HH у вас также может добавиться плашка "Конкретные достижения", что лучше влияет на внешний вид РЕЗЮМЕ.
из этого: написал пет проект, где брал данные из PG и грузил их в Greenplum. Также сделал проект по загрузке из API в S3 а потом в Clickhouse. Все развернул в докер compose. Понимаю Airflow, могу написать на Spark. Также немного пробовал dbt модели для учебного проекта
Получилось:
- Спроектировал и развернул контейнеризованную инфраструктуру на Docker Compose, объединив PostgreSQL, Apache Airflow, Greenplum и ClickHouse в единый изолированный контур для разработки и тестирования ETL-процессов.
- Реализовал batch-пайплайн на Python и SQL для извлечения данных из PostgreSQL и загрузки в Greenplum, настроив оптимизированные дистрибутивные ключи и партиционирование таблиц для ускорения агрегационных запросов.
- Построил интеграционный модуль для получения данных из внешнего REST API, сериализации в Parquet и загрузки в S3, обеспечив идемпотентность и дедупликацию записей при повторных запусках процесса.
- Организационно настроил загрузку данных из S3 в ClickHouse с использованием columnar-формата, что позволило снизить время отклика на аналитические запросы примерно на 40% по сравнению с реляционным хранилищем.
- Разработал DAG в Apache Airflow для оркестрации сквозного процесса обработки, добавив механизмы retry, SLA и алертинга о сбоях, что повысило надежность пайплайнов до 98%.
- Провел черновой эксперимент с использованием Apache Spark (PySpark) для трансформации больших объемов данных, сравнив производительность с нативным SQL и подтвердив эффективность распределенной обработки.
- Спроектировал набор dbt-моделей для учебного проекта, внедрив тесты качества данных и документацию зависимостей, что позволило автоматизировать валидацию схем и снизить количество ошибок нагрузки на 25%.
- Настроил мониторинг состояния контейнеров и метрик выполнения задач через Prometheus и Grafana, обеспечивая прозрачность работы микросервисов данных и быстрое выявление узких мест.
- Оптимизировал SQL-запросы в Greenplum и ClickHouse, внедрив индексы и переработав планы выполнения, что сократило среднее время вычисления отчётов с 120 до 45 секунд.
- Подготовил финальные витрины данных для визуализации, интегрировав их с BI-инструментом, и обеспечил аналитиков актуальными данными с задержкой обновления менее 5 минут.
Технологический стек: Python, SQL, PySpark, Apache Spark, Apache Airflow, dbt, PostgreSQL, Greenplum, ClickHouse, S3, Parquet, Docker, Docker Compose, Prometheus, Grafana