Три дня я пытался понять, почему цифры перестали сходиться.
Четыре AI-продукта работают параллельно. Один основатель. Одна таблица решает, что будет выпущено.
Раньше я выбирал интуитивно. Какой продукт на этой неделе громче всех просил клиент, тот и попадал в дорожную карту. Так квартал улетал на функцию, которую никто не просил.
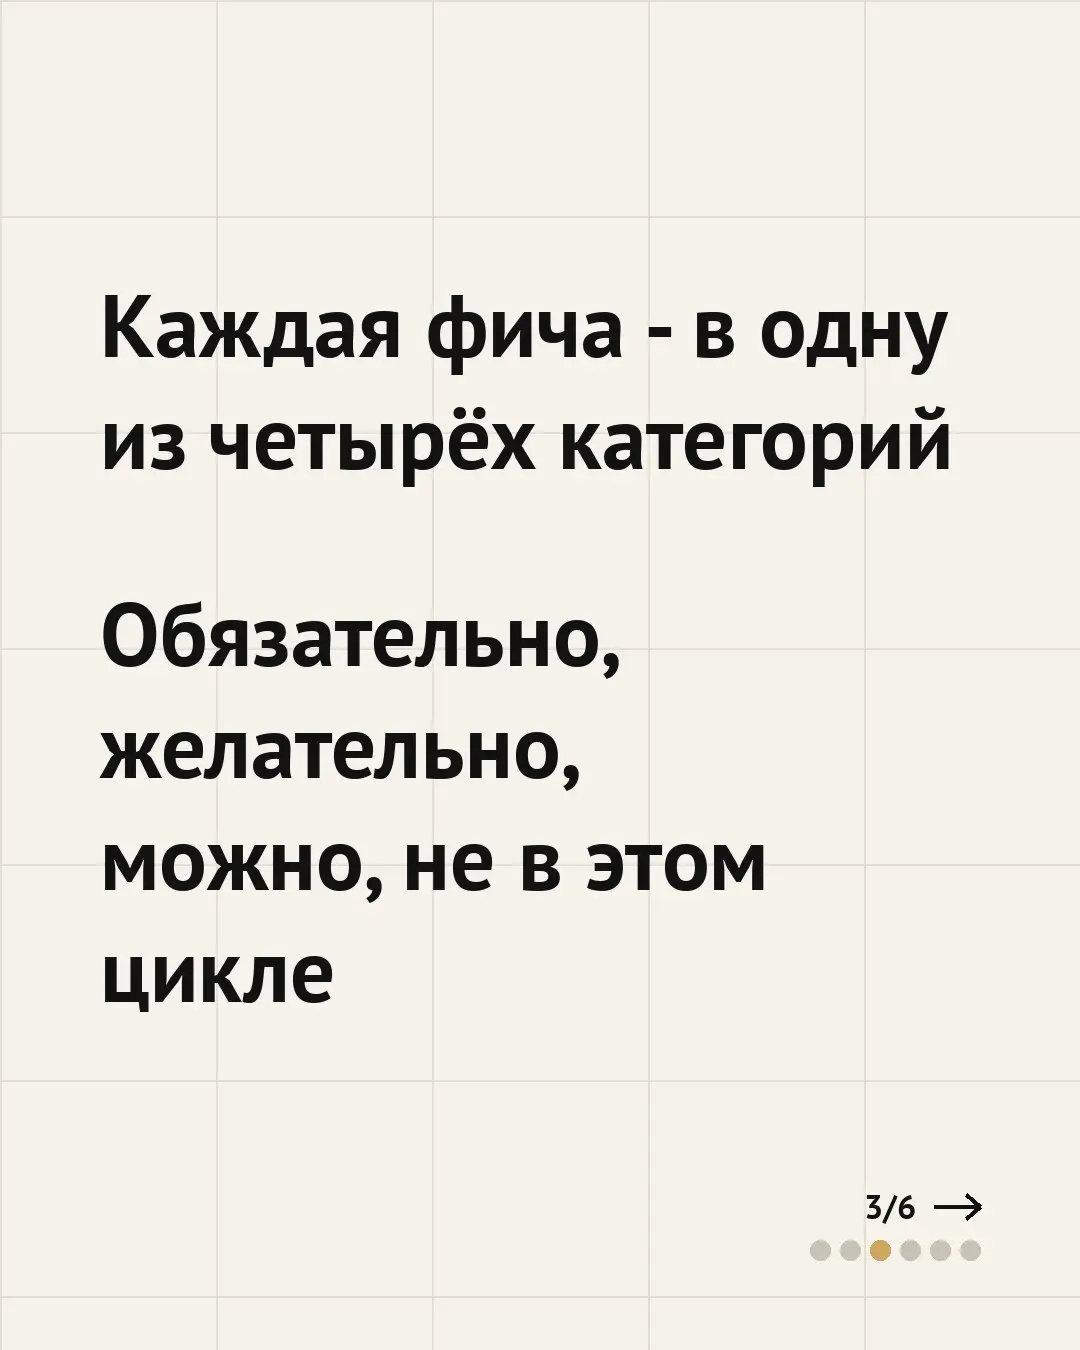
Теперь каждый продукт оценивается по одним и тем же четырем категориям еще до написания первой строчки кода: что он должен делать, что он должен бы делать, что он мог бы делать, что он не будет делать в этом цикле. Это метод MoSCoW — фреймворк приоритизации, созданный именно для такого хаоса с несколькими продуктами.
Оценка вынуждает к неудобному разговору. Функция, которая кажется срочной в Slack-переписке, обычно попадает в категорию "мог бы", а не "должен". Вес категорий важнее самих названий — пропустите взвешивание, и вы просто переименуете интуицию более красивыми словами.
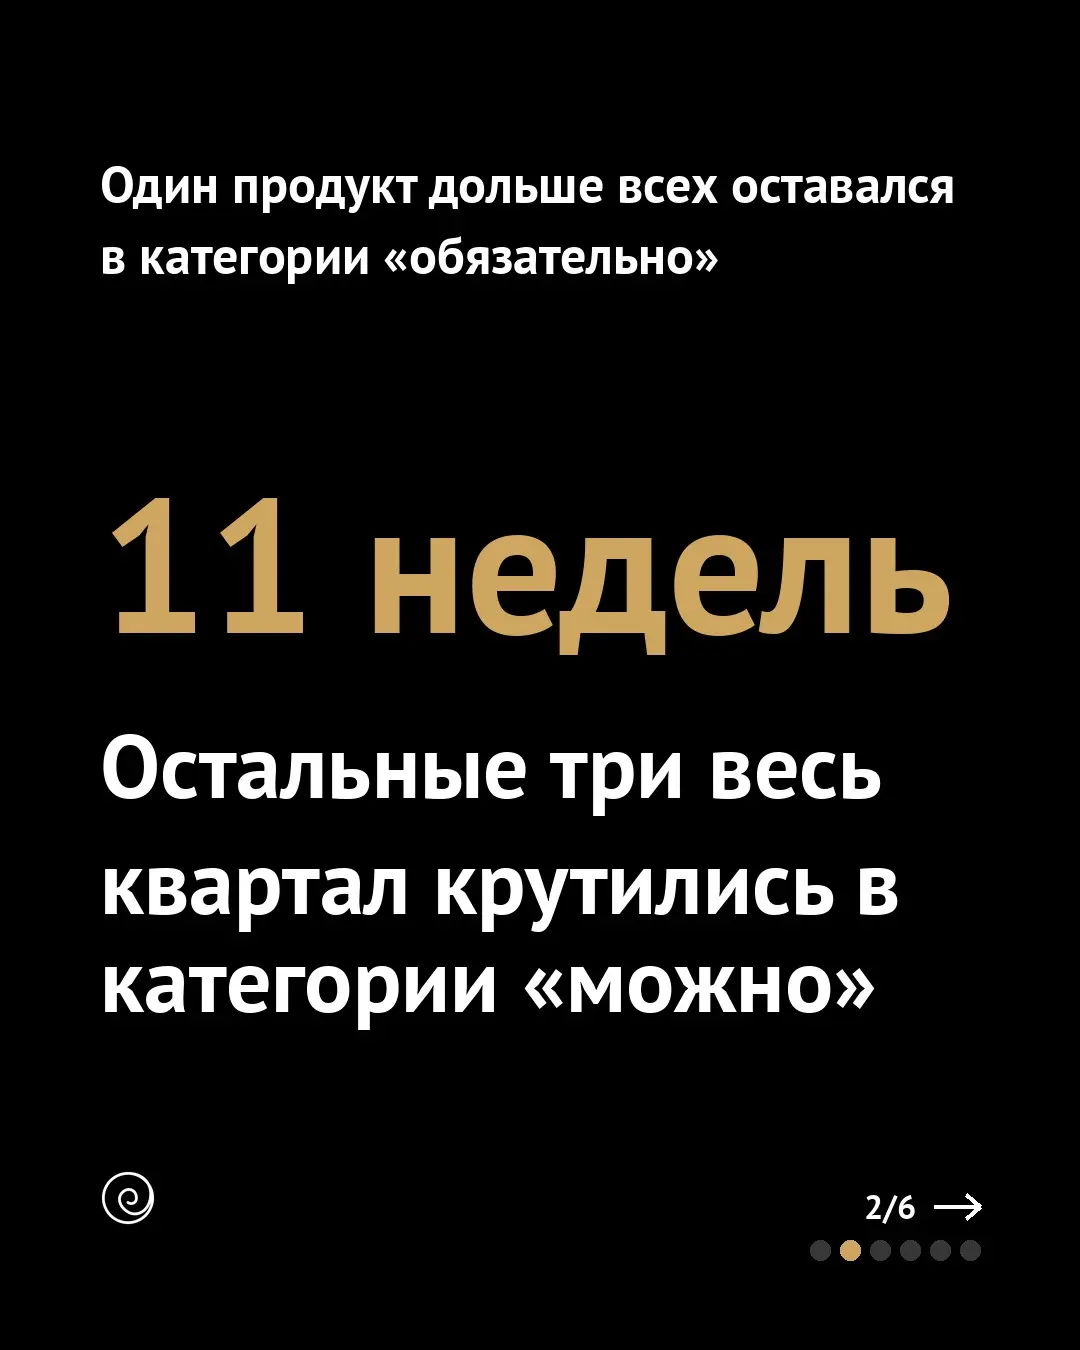
В прошлом квартале один из наших четырех продуктов оставался в категории "должен" одиннадцать недель подряд. Остальные три чередовались в категории "мог бы". Тот, что остался, решает наименее проработанную проблему в команде, просто и ясно.
Таблица не принимает решение в одиночку. Она просто делает решение достаточно наглядным, чтобы я не мог притвориться, что не видел, к чему все идет.
Какой из ваших продуктов выжил бы неделю, когда выпускается только то, что находится в категории "должен"?