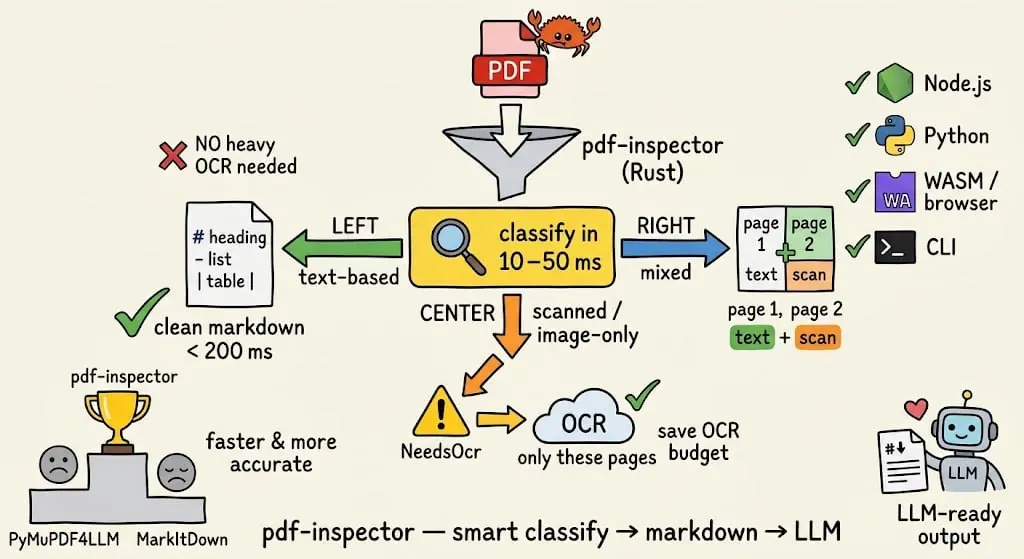
https://github.com/firecrawl/pdf-inspector Еще одна утилита для работы с документами. Написана на Rust (разработанная командой Firecrawl), предназначена для инспекции, классификации и извлечения текста из PDF-файлов без обязательного использования тяжеловесного OCR (оптического распознавания текста).
- Умная классификация: за 10–50 мс определяет тип документа (текстовый, отсканированный, содержащий только изображения или смешанный), что позволяет отправлять на классическое OCR только те страницы, где это действительно необходимо.
- Извлечение текста и конвертация в Markdown: преобразует текстовые PDF в чистую разметку Markdown, автоматически распознавая таблицы, заголовки, списки, блоки кода и многоколоночные структуры с сохранением правильного порядка чтения.
- Высокая скорость: обрабатывает локальные текстовые PDF менее чем за 200 мс. Согласно бенчмаркам разработчиков, библиотека превосходит аналоги (такие как PyMuPDF4LLM или MarkItDown) по общей точности и скорости работы.
- Кроссплатформенность: помимо родного Rust и CLI-утилит, имеет официальные готовые привязки (bindings) для Python, Node.js и WebAssembly для работы прямо в браузере.
Применяем и для передачи текста в нейросетки, и для оценки загруженных клиентам файлов с дальнейшим OCR только тех страниц, где это нужно.