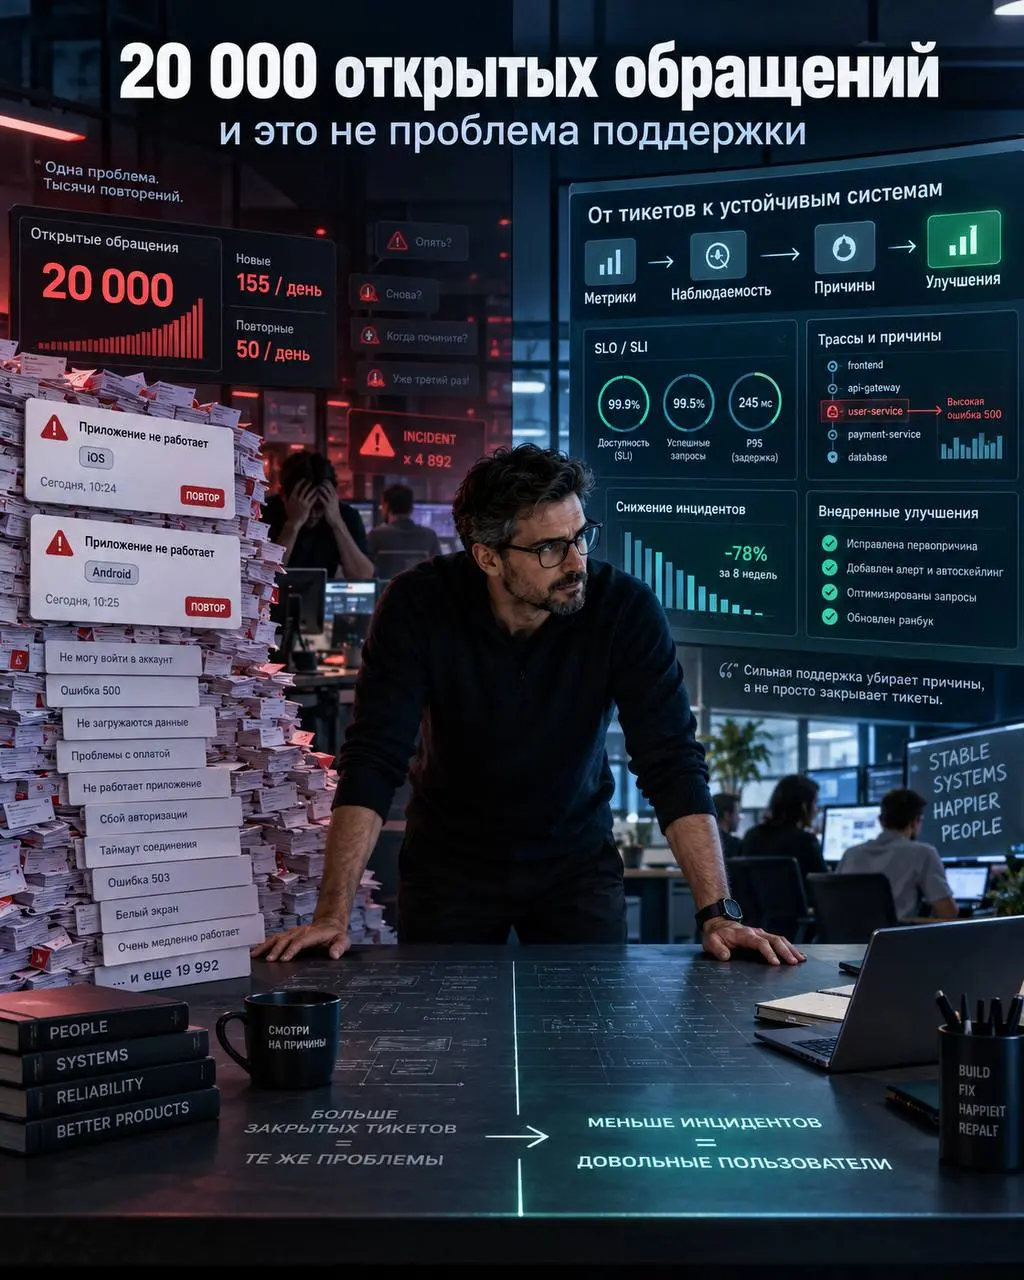
20 000 открытых обращений — и это не проблема поддержки
Когда у тебя 20 000 открытых обращений, первая мысль очень простая: надо быстрее закрывать.
Добавить людей. Усилить смену. Поставить план.
Посчитать производительность. У нас, например, входящий поток около 50 обращений в день, а закрываем примерно 155.
Математика вроде бы на нашей стороне.
Хвост должен сокращаться.
Но чем глубже я смотрю на поддержку, тем сильнее ощущение, что количество закрытых тикетов вообще не отвечает на главный вопрос: почему эти тикеты продолжают появляться?
И вот здесь начинается самое интересное.
Например, один backend используется и iOS, и Android. Падает один и тот же сценарий. Но система создаёт два разных инцидента.
Для отчётности — две проблемы. Для пользователя — одна.
Для команды — две цепочки коммуникаций, два разбора и два раза одинаковая работа.
Вроде бы процессы работают.
Только ценности от этого немного.
Или другой кейс.
Мы хотим контролировать SLO 99,9%.
Есть алерт: 50 ошибок за 5 минут. На первый взгляд всё логично.
А потом выясняется, что в каком-то сценарии за пять минут бывает всего 80–100 запросов.
То есть половина клиентов уже может получать ошибку, а мониторинг ещё считает, что ничего особенного не происходит.
Алерт есть. SLO есть. Дашборд есть.
Но реального состояния клиентского сценария мы всё равно не видим.
И вот такие вещи постепенно меняют отношение к самой поддержке.
Раньше на неё легко смотреть как на отдельную функцию: есть продуктовые команды, которые что-то делают, а есть поддержка, которая потом разбирается с последствиями.
Но это довольно странное разделение.
Потому что support получает тикет уже в самом конце цепочки.
До этого кто-то спроектировал систему.
Кто-то определил логирование. Кто-то решил, какие метрики собирать. Кто-то сделал интеграцию. Кто-то определил таймаут. Кто-то решил, что конкретный сценарий вообще не нужно мониторить отдельно.
И только потом всё это приезжает в поддержку в виде: «У клиента не работает перевод».
Поэтому сейчас мне гораздо интереснее смотреть не на то, насколько хорошо поддержка перерабатывает входящий поток, а на то, что генерирует этот поток.
Где нет наблюдаемости.
Где два инцидента на самом деле один.
Где проблема регулярно повторяется.
Где инженер поддержки каждый раз делает руками одно и то же.
Где приходится идти к разработчику просто потому, что без него невозможно понять, что вообще произошло.
И, конечно, это не значит, что тикеты не надо закрывать.
Надо.
Особенно когда у тебя их 20 000 :)
Но есть большая разница между: «мы научились закрывать 200 обращений в день» и «мы нашли три причины, которые каждый день создавали 50 новых».
Первое очень хорошо выглядит на операционном отчёте.
Второе иногда вообще незаметно.
Просто через какое-то время становится немного тише.
Инцидентов меньше. Эскалаций меньше. Ручной работы меньше.
И люди внезапно начинают успевать заниматься чем-то кроме очередного пожара.
Наверное, поэтому сейчас я всё меньше воспринимаю поддержку как «отдел, который закрывает обращения».
Это скорее очень хороший датчик качества всей инженерной системы.
Если поддержка постоянно захлёбывается — возможно, проблема действительно в поддержке.
А возможно, она просто первой показывает всё то, что мы не починили раньше.