


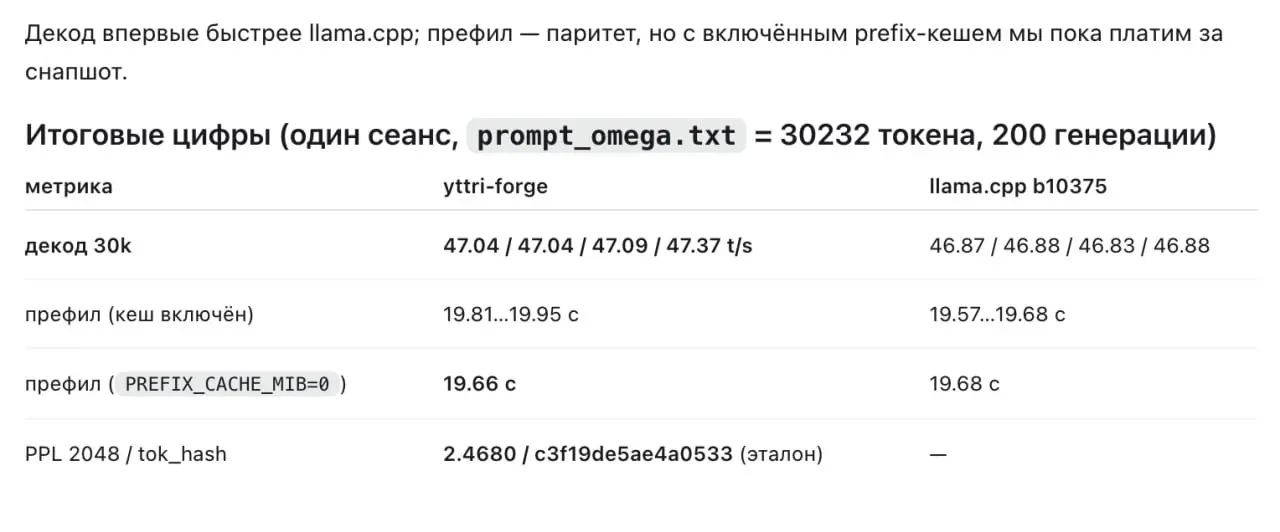
Мой инференс моделей qwen написаный на Rust впервые обогнал llama.cpp по скорости. Есть и другие преимущества в том числе размер занимаемой памяти.
Остался один небольшой момент по префилу, но он проявляется только при кешировании. Я работаю над этим, уверен скоро я добьюсь успеха и это станет свободным решением без необходимости использовать llama.cpp в проектах, а можно запускать модели прям в своем коде на Rust.
Есть желание потестировать пишите в личку. Решение поддерживает три протокола chat, response, message - что позволяет подключать запущенные модели к любому harness движку.
Исходниками бесплатно делиться не буду, но могу поучаствовать в проектах.


· 19.09
А как оптимизировали ? LoRa?
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
коммент удалён
· 24.09
Нет, Lora это Fine tuning. Я же писал именно инференс т.е. запуск и работа модели. Перебирал драйвера nvidia и разбирался как складываются матрицы, как суммируются, складываются, переиспользуются и т.п.
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
ответ удалён
· 24.09
Тензоры по итогу
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
ответ удалён
· 24.09
Да, пришлось писать свои ядра.
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
ответ удалён
· 24.09
На основе исходного кода квен?
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
ответ удалён
· 24.09
Не совсем верно. Qwen и другие это скорее структура. А вот загрузка этой структуры и как данные запроса конвертируются в памяти для такой матрицы, как потом прилепляться на уровне генерации это немного другое.
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
ответ удалён
· 24.09
Скоро будет отдельный сайт с разбором и моделями которые тестировались. Я также проводил тесты на Gemma 4 там тоже dense модель, но результаты тоже достойные. Дальше в планах это поддержка мультикарт по примеру vllm что llama.cpp вообще не умеет, а недостаток vllm что она не умеет работать с квантоваными моделями.
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
ответ удалён