


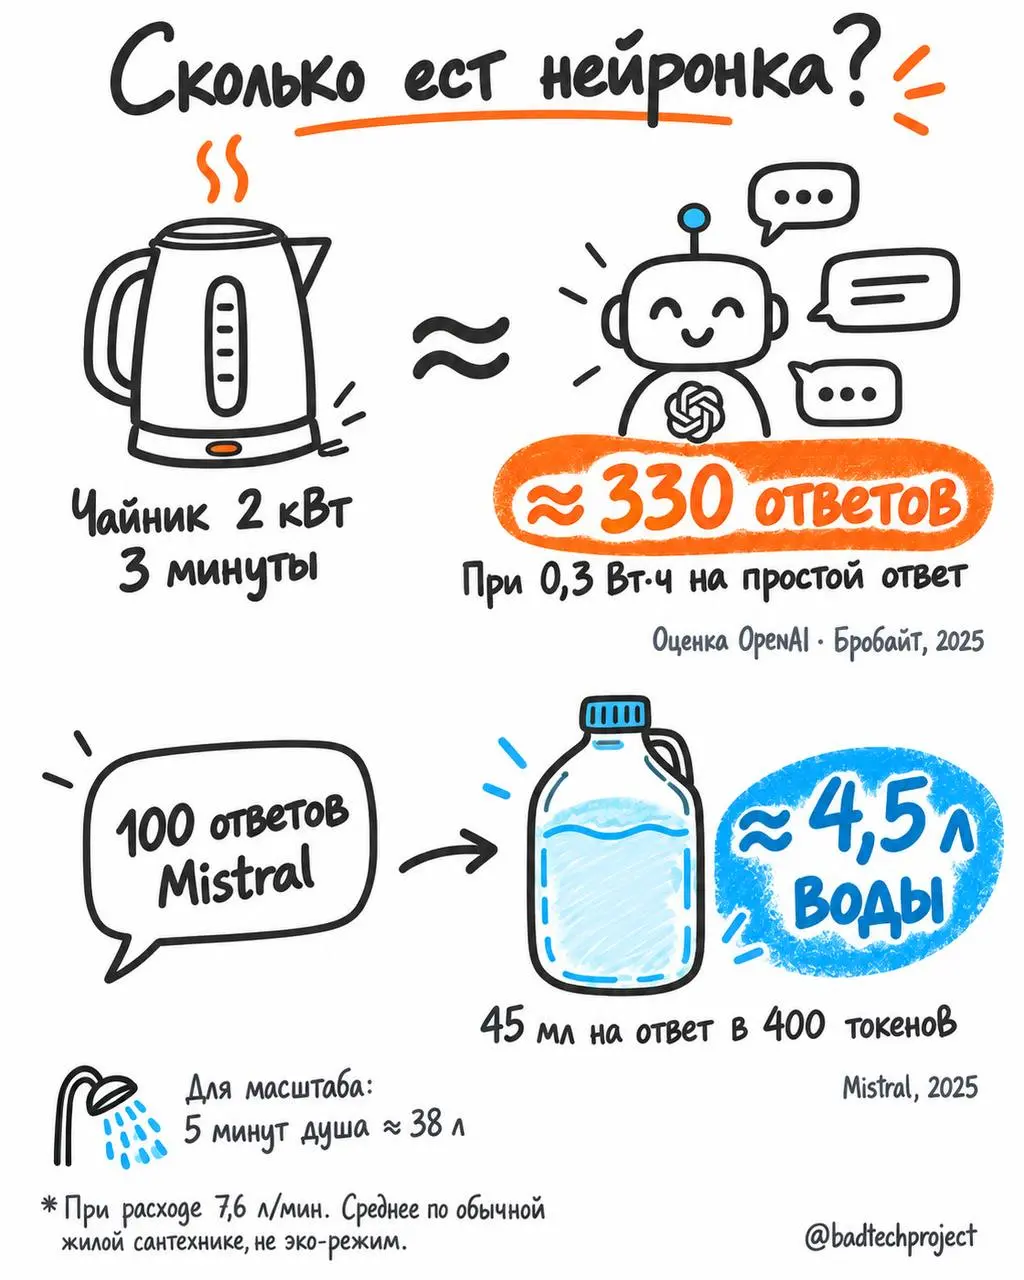
Один чайник - это 330 ответов ChatGPT
Короче, я полез разбираться, сколько воды и электричества уходит на один запрос в нейронку.
Потому что «AI потребляет огромное количество ресурсов» звучит страшно, но хочется понять че там реально?
Начнем с электричества.
Epoch AI посчитали, что обычный запрос к GPT-4o с ответом примерно на 500 токенов требует около 0,3 Вт·ч.
У Google есть замеры на инфраструктуре Gemini: 0,24 Вт·ч для медианного текстового запроса по их методике в мае 2025 года.
Если вы не сильно шарите в инженерии, то помогут бытовые сравнения. Если взять 0,3 Вт·ч на ответ, получаются:
💡 Лампочка 10 Вт горит час примерно 33 ответа нейронки.
💻 Ноутбук потребляет 50 Вт в течение часа - примерно 167 ответов.
🫖 Чайник мощностью 2 кВт работает 3 минуты - примерно 330 ответов.
Пока греете воду для чая, нейронка могла бы несколько сотен раз помочь вам переписать сообщение коллеге😁
Правда, с долгими рассуждениями все иначе.
В исследовании 2026 года одна и та же модель Qwen 3 32B в сценарии решения задач с рассуждением тратила на ответ примерно в 23 раза больше энергии, чем в обычном диалоге: ответы были длиннее, настройки обработки тоже отличались.
Поэтому переносить «0,3 Вт·ч на запрос» на агента, который час копается в вашем проекте, нельзя.
А что с водой?
У Google 0,26 мл на текстовый запрос, примерно пять капель. Но учитывается только охлаждение дата-центра. Вода на производство электричества сюда не входит. Методика.
У Mistral - 45 мл на ответ в 400 токенов, при более широком учете воздействия, включая производство оборудования. Поэтому напрямую сравнивать эти цифры нельзя.
Если взять оценку Mistral:
💧 100 ответов - 4,5 литра воды.
🚿 Пять минут душа при расходе 7,6 литра в минуту 38 литров.
По объему - это примерно как 840 ответов Mistral.
Но тут есть нюанс: вода из душа уходит в канализацию и может вернуться после очистки. В водном следе AI считают в том числе испарение. Это сравнение объемов, а не одинакового ущерба природе.
Что с этим делать?
Я бы спокойно пользовался нейронкой для полезных задач.
Для «сократи абзац» выбирал простой режим. А долгое рассуждение включал там, где оно действительно помогает.
P.S. и тут нифига не учтены расходы на обучение моделей




· 1 ч
Тоже задумывался над этим, с одной стороны, обратная связь с позитивной оценкой или негативная с корректировками/скармливанием более удачного решения делают лучше будущие ответы/логику, а с другой стороны - увеличивают расход ресурсов и токенов.
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
коммент удалён