
Как AI-агентам распознавать одну и ту же сущность
AI может отлично понимать текст и при этом ошибаться в самом важном — с каким именно объектом он работает.
Представьте обычную ситуацию. В CRM клиент записан как «Алексей Петров», в системе заказов — как «Петров Алексей», а в программе лояльности у него вообще идентификатор CL-48291. Для сотрудника очевидно, что это один человек. Для AI это могут быть три разные записи.
Пока агент работает внутри одной системы, проблема почти незаметна. Но как только он начинает связывать данные из CRM, ERP, платёжных сервисов и других источников, идентификация становится частью бизнес-логики.
И здесь цена ошибки оказывается выше, чем при обычной неточности в ответе.
Если AI неправильно классифицировал товар — это неприятно. Если он применил действие не к тому клиенту, последствия могут быть гораздо серьёзнее. Поэтому надёжные AI-системы не пытаются каждый раз «угадывать», что две записи относятся к одному объекту.
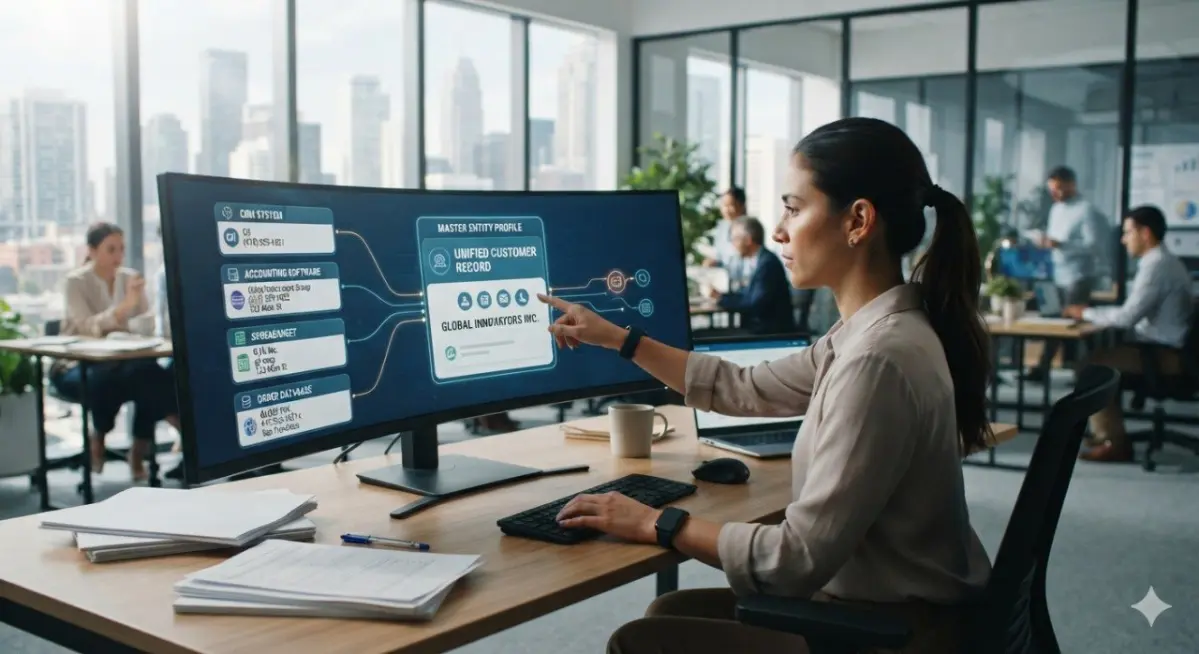
Обычно для этого создаётся единый канонический идентификатор. Например, у клиента есть внутренний ID, а уже к нему привязаны идентификаторы CRM, ERP, интернет-магазина и других систем. Тогда агент сначала находит общий объект, а затем работает с нужным представлением в конкретной системе.
При этом совпадение имени, телефона или email ещё не означает, что это один и тот же человек. Надёжное сопоставление обычно строится на комбинации нескольких признаков и чётких правилах системы, а не на догадках модели. Поэтому при внедрении AI важно думать не только о доступе к данным.
Не менее важно понимать, как система определяет, что клиент в CRM, заказ в интернет-магазине и запись в платёжной системе действительно относятся к одному бизнес-объекту.
Чем больше интеграций появляется в компании, тем важнее становится этот слой идентификации. Именно он часто определяет, сможет ли AI безопасно работать с реальными бизнес-процессами.