Data Lakehouse в облаке (часть 1): Концепция и слой Bronze
О чем: Общая архитектура Yandex Cloud, стек и особенности сбора сырых данных as-is.
При проектировании современных платформ данных инженеры часто сталкиваются с дилеммой. С одной стороны, классический Data Lake на базе S3-объектного хранилища подкупает своей дешевизной и масштабируемостью. С другой — он быстро превращается в «болото данных» (Data Swamp), где невозможно обеспечить ACID-транзакционность, выполнить точечные операции UPDATE/DELETE или гарантировать консистентность при одновременном чтении и записи.
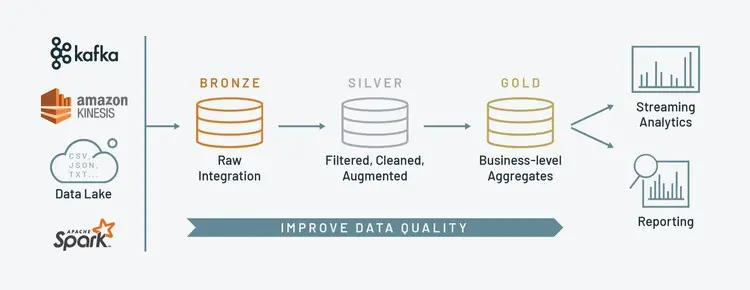
Решением этой проблемы стал подход Data Lakehouse, который объединяет лучшие свойства хранилищ данных (DWH) и объектных репозиториев. В этой серии статей я поделюсь практическим опытом реализации такого подхода с использованием Медальонной архитектуры (Medallion Architecture) в инфраструктуре Yandex Cloud.
Технологический стек платформы
Для построения, отказоустойчивого и экономически эффективного конвейера обработки данных был выбран следующий стек технологий:
- Хранение: Yandex Object Storage (S3) в качестве единого физического уровня хранения. - Вычисления: Эфемерные кластеры Yandex Data Proc (Apache Spark) для тяжелой пакетной обработки данных. - Табличный формат: Apache Iceberg для реализации полноценного транзакционного слоя поверх S3. - Оркестрация: Apache Airflow, управляющий жизненным циклом данных и вычислительных ресурсов. - Витрины и трансформация: dbt в связке с ClickHouse для финального SQL-моделирования и обеспечения сверхбыстрого доступа к аналитике.
Концептуально поток движения данных выглядит следующим образом: Сырые JSON → Bronze (S3 Files) -> (PySpark) -> Silver (Iceberg) -> (PySpark) -> Gold (Iceberg) → dbt + ClickHouse → BI / Потребители.
Слой Bronze: Правильный прием сырого потока
Главная задача слоя Bronze — максимально быстро и надежно зафиксировать входящий поток данных «as is» (в исходном виде), без изменения структуры. В нашем кейсе источником служат полуструктурированные сырые JSON-данные.
Ключевые правила организации Bronze-слоя: 1. Никаких трансформаций: Любое изменение схемы данных на этом этапе запрещено. Если источник прислал поврежденный или избыточный JSON, он должен быть сохранен именно в таком виде. Это гарантирует возможность полной перезагрузки (replay) данных с любой точки во времени при изменении бизнес-логики. 2. Оптимальное партиционирование в S3: Запись сырых файлов организуется по паттерну структуры каталогов: s3://my-data-lake/bronze/dataset_name/year=YYYY/month=MM/day=DD/ Это критически важно для Spark: при последующем чтении за определенный период механизм Partition Pruning позволяет избегать полного сканирования бакета, минимизируя сетевой оверхед и ускоряя джобы. 3. Изоляция метаданных: На данном этапе мы сознательно не накладываем на данные строгую схему. Слой Bronze — это файловое хранилище, подготовленное для дальнейшей дистрибуции в транзакционный слой Silver.
В следующей части мы детально разберем, как с помощью PySpark превратить этот массив сырых JSON-файлов в структурированные таблицы слоя Silver, как реализовать легковесную кастомную валидацию данных и почему формат Apache Iceberg полностью меняет правила игры при работе с Data Lake.