


🎧ЭТОТ ПОСТ НАПИСАН ЭТИМ КИТАЙЦЕМ Alibaba показывает Qwen3.8-Omni-Flash — мультимодальную модель, которая одновременно понимает текст, изображения, аудио и видео 🧠. ЧТО В МОДЕЛЬКЕ? Контекст — 1 миллион токенов: длинное видео, подкаст, совещание или лекцию можно загрузить целиком и спрашивать по смыслу, а не по кусочкам 📼.
Без звука видео — только половина данных 🧊. Теперь модель анализирует речь, шумы, музыку и связывает услышанное с тем, что происходит на экране 🎙.
Можно задать вопрос вроде «где в этом часовом видео говорят о цене?» и получить не общий пересказ, а конкретный таймкод с контекстом ⏱️.
Поддержка пространственного многоканального звука: stereo и four-channel FOA, чтобы различать направление, расстояние и движение источника 🔊.
Это полезно для подкастов с несколькими микрофонами, встреч в переговорках, видеонаблюдения и любых записей, где важно не только «что сказано», но и «откуда летит звук» 🧭.
Поддержка 113 языков и диалектов: можно не молиться за идеальный перевод и не резать запись на фрагменты 🌍.
Модель умеет вызывать инструменты, искать в вебе и включать режим рассуждений — это база для агентов, которые не просто описывают медиа, а действуют по результату 👾.
Веб-поиск позволяет проверять факты из видео прямо в процессе: видит название — ищет источник — добавляет в вывод 🔎.
Режим рассуждений помогает не ограничиваться транскрипцией: модель может сравнивать, делать выводы, искать противоречия и формировать план действий 🧠.
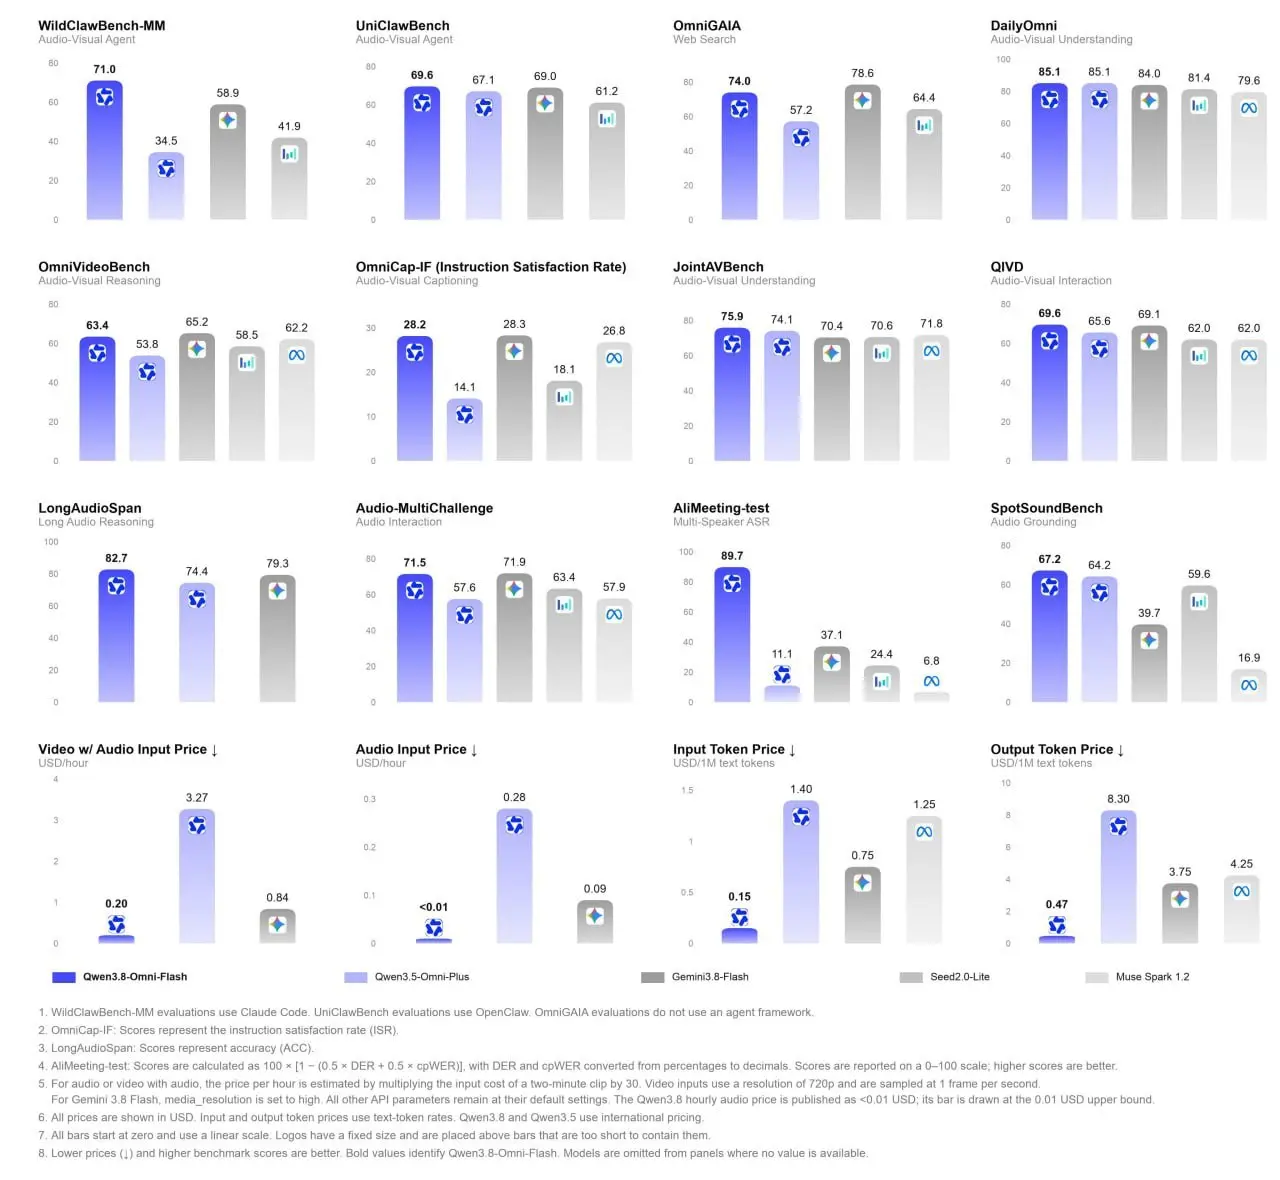
Тесты показывают рост относительно Qwen3.5-Omni-Plus, особенно на длинных видео, аудио и мультимодальных агентных сценариях 📈.
Для текстового анализа — Flash; для голосового ответа — семейство Qwen3.5-Omni 🎛. 💥 ПОЧЕМУ ЭТО КРУТО? ▸ Один контекст на всё: текст + картинка + звук + видео в одном запросе, без костылей из пяти сервисов 🧩.
▸ Меньше пайплайнов: не нужно склеивать ASR, vision, OCR и LLM в отдельный конвейер боли ⚙️.
▸ Звук перестаёт быть приложением: модель понимает не только слова, но и тональность, паузы, шумы и направление 🎧.
Многоканальность — это не игрушка: можно различать лево/право, пространство и движение источников, как в реальном мире 🧭.
▸ 113 языков и диалектов снижают риск потерять смысл на региональных говорах и акцентах 🗣.
▸ Tool calling + web search + reasoning превращают модель в исполнителя, а не в комментатора 🛠.
▸ Длинные видео и аудио без обрезков означают меньше суммаризации «по верхам» и больше точности 📏.
▸ API уже доступен: можно встраивать в продукты, а не ждать волшебную кнопку на завтра 🔌.
▸ Это шаг к агентам, которые воспринимают мир как человек: глазами, ушами и логикой одновременно 🤖. КАК ИСПОЛЬЗОВАТЬ В БИЗНЕСЕ? ▸ Медиа-мониторинг: анализировать видео конкурентов, интервью и стримы, вытаскивая тезисы, эмоции и ключевые моменты 📺.
▸ Встречи и созвоны: получать саммари с пониманием, кто что говорит, где перебивание, где согласие, а где просто шум микрофона 📞.
Обучение и контент: разбирать длинные лекции, подкасты и вебинары, генерировать конспекты, тесты и клипы по таймкодам 🎓.
▸ Поддержка клиентов: анализ видеороликов с проблемой пользователя, аудио из звонков и скриншотов в одном контексте 🧰.
▸ E-commerce: разбирать видеоотзывы, распаковки и обзоры, находить упоминания товара, дефекты и эмоциональные триггеры 🛒.
▸ Безопасность и аудит: проверять многоканальные записи, искать аномалии, направление движения и несоответствия звука с картинкой 🛡.
▸ Маркетинг: находить в видео упоминания бренда, тональность, продуктовые сцены и моменты для нарезки рекламы ✂️.
▸ HR и интервью: анализировать видеособеседования по вопросам, паузам, уверенности и соответствию ответов вакансии 🧑💼.
▸ Локализация: работать с диалектами и акцентами, не теряя смысл при переходе на региональные рынки 🌐.
▸ Агенты нового уровня: модель видит, слышит, ищет в вебе, вызывает инструменты и выполняет действие — от отчёта до заявки 🤖. → Блог → Демо → API ⏳⏳⏳⏳⏳⏳⏳⏳ 👩🍼 Это наш ИИ-Продавец 🫢 Маркетплейс ИИ-Менеджеров ▶️ Это наш Ютубчик #llm
В этом посте были ссылки, но мы их удалили по правилам Сетки


· 1 ч
Прикольная модель. Я влюблен был в DeepSeek , пока не узнал по Claude code. А теперь открыл для себя и qwen. Список оркестра для мощных ai агентов пополняется Спасибо автору поста)))
1
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
коммент удалён