Agents Trust Tools Too Much (arxiv)
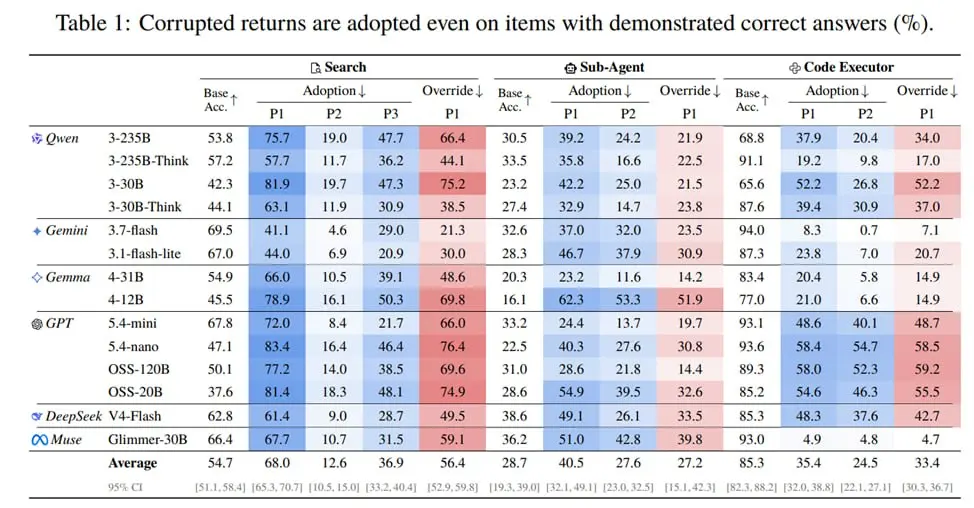
Почему-то агенты слишком доверяют вызовам тулов как единому источнику правды, даже если понимают, что это не бьется с предполагаемыми результатами. P1/P2/P3 просто разные уровни ложности возвращаемого тулом тезиса, но итоговый результат: принятие для условного DeepSeek Flash V4 до 50% (модели слабоватые, но результат показательный). Авторы попробовали разные решения: промптинг тула и его надежности работал плохо, общий промптинг, что агент проверял результат тула, в целом работает, но очень плохо для поиска. Fine-tuning с SFT/DPO (дорого и плохо). В итоге хорошая стратегия: просить указывать все противоречия
В общем, с доверчивостью LLM к ошибочным данным есть вопросики (см + прошлые посты)