Не те бенчмарки по моделям мы смотрим.
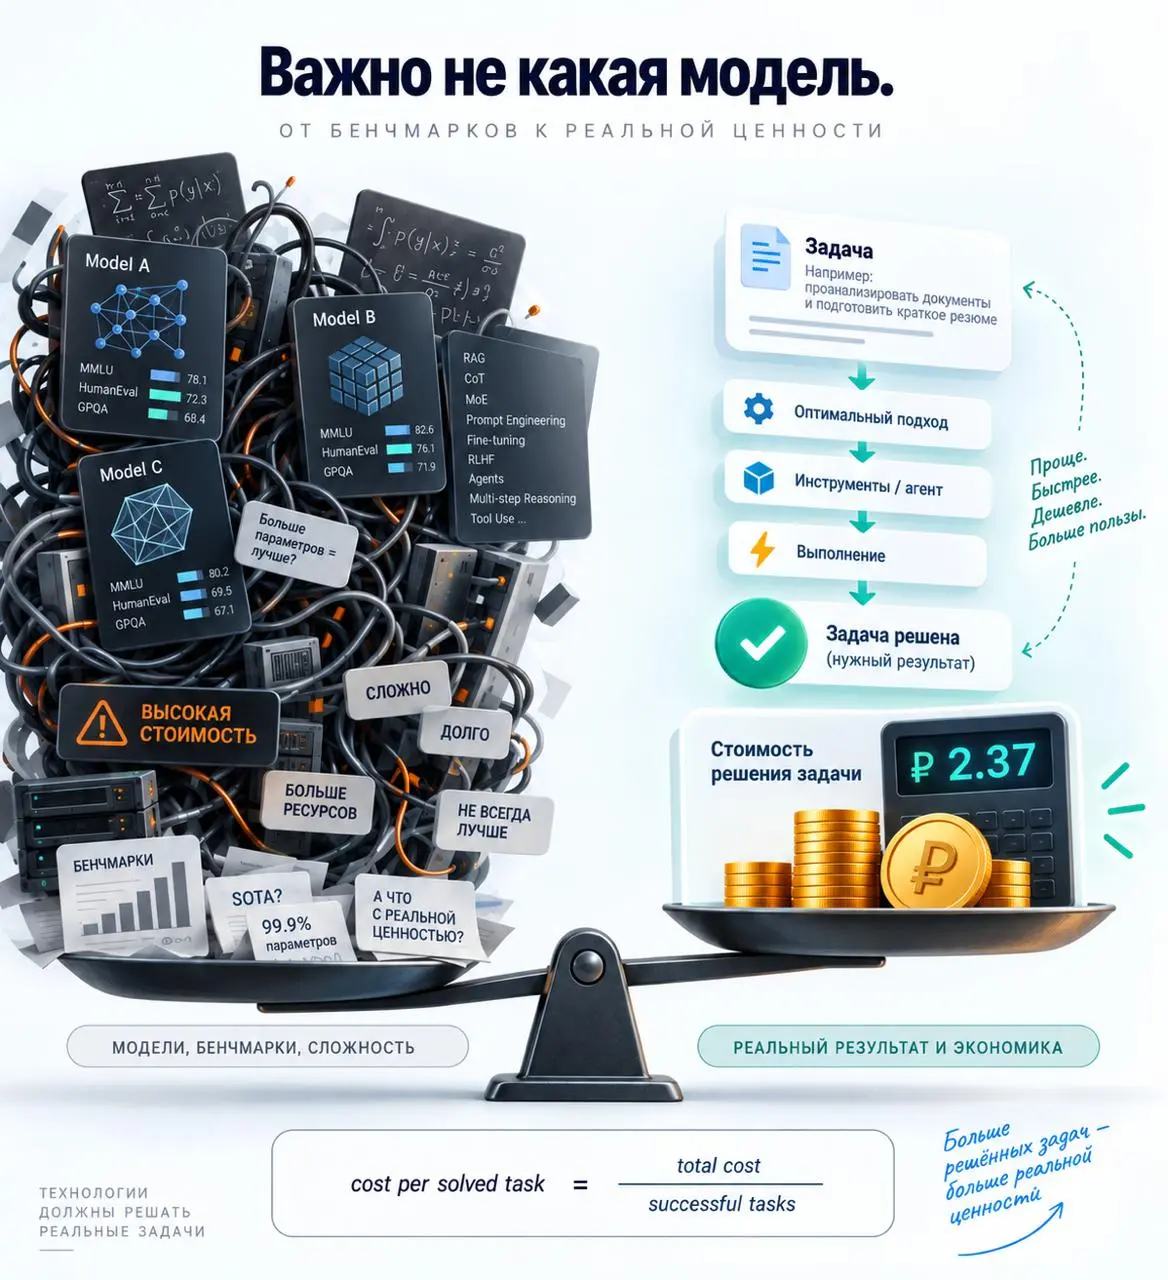
Фронтирные модели становятся умнее, умеют решать всё более сложные задачи и часто стоят соответствующе. Но для бизнеса бенчмарк модели сам по себе мало что говорит. Ибо важно не то, сколько стоит миллион токенов. Важно, сколько стоит успешно решить конкретную задачу.
Это хорошо видно на кодинговых агентах вроде Codex или Claude Code. Они очень крутые, но на мощных моделях начинают оверинжинирить. долго планируют, делают дополнительные проверки, вызывают инструменты, проходят несколько кругов над аэродромом там, где задача решается значительно проще.
Да, очевидный ответ - не отправлять простые задачи самым дорогим моделям и делать маршрутизацию по сложности. Но не единой моделью решается задача :)
Тут главное задать вопрос: Какой минимально достаточный набор модели, контекста, инструментов и orchestration решает эту задачу с нужным качеством, надёжностью и себестоимостью?
И ответ вполне может оказаться таким - для части задач эффективнее собирать свои специализированные харнесы, ограниченные конкретным классом сценариев, чем всегда полагаться на универсального агента от производителя фронтирных моделей, для которых вполне свойственно сводить экономику и не всегда эффективно и дешево решать задачи.
Ведь в конечном счёте оптимизировать нужно экономику решённой задачи.