Лиха беда - начало. Строим MILP-оптимизатор.
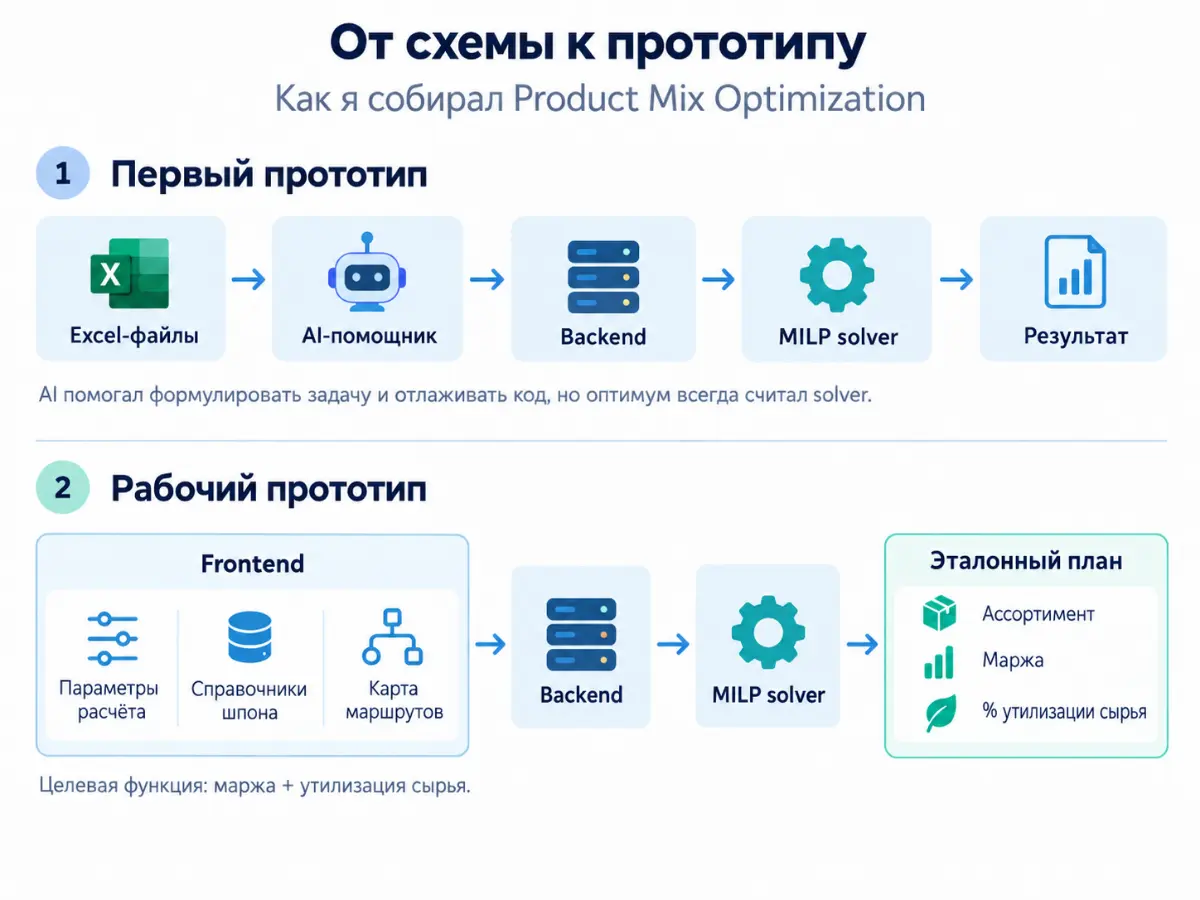
В позапрошлой статье я подводил к тому, что Product Mix Optimization в рамках S&OP можно реализовать на базе MILP-solver. Но между идеей и работающей системой есть довольно длинный путь. Я начал с самого простого — нарисовал схему будущего оптимизатора, чтобы визуально понять его архитектуру. Сразу оговорюсь: я не разработчик и не программист. Но у меня есть опыт участия во внедрении MES со стороны заказчика. Моя роль была на стыке производства и команды разработки. Я анализировал наши бизнес-процессы, координировал аналитиков подрядчика с технологами и производством, помогал разбирать спорные требования. Иногда приходилось объяснять коллегам, почему какой-то функционал нельзя реализовать именно так, как они его представляют, учитывая ограничения стека разработчиков. А иногда — наоборот, убеждать команду разработки, что требование производства не «хотелка для галочки», а реально необходимая часть процесса. Бывало, день начинался в семь утра с сообщений аналитиков: «Мы правильно поняли эту часть процесса?» — разница во времени с Москвой давала о себе знать. Этот опыт дал мне главное понимание: прежде чем писать что-то сложное, нужно разобраться, как данные, логика и результат должны двигаться внутри системы. Первая архитектура На входе — Excel-файлы с исходными данными и формулировка задачи от языковой модели. Для работы использовал OpenCode с подключенными GPT и DeepSeek. Backend преобразовывал постановку в математическую задачу для MILP-solver. Solver выполнял оптимизацию, результат возвращался обратно, модель помогала его интерпретировать, а данные сохранялись в базе. Здесь важное уточнение к вопросу из комментариев: никакой ML-модели, которая сама выбирала производственный план, не было. AI помогал формулировать ограничения, писать и отлаживать код, но оптимальное решение всегда рассчитывал solver. Поэтому проверять нужно было не то, «не насочинял ли AI», а правильно ли я описал задачу для solver. На первых этапах я использовал простые сценарии, результат которых можно проверить вручную или в Excel: хватает ли шпона, не превышена ли мощность, правильно ли работают ограничения и выбирает ли solver более выгодный из очевидных вариантов. Если решение формально допустимо, но производственно бессмысленно, значит в модели не хватает реального ограничения. Его добавляли — и считали снова. Появление frontend Когда backend + solver начали стабильно считать простые сценарии, стало понятно: пора уходить от «расчёта через код» к нормальному интерфейсу. Во frontend я разделил исходные данные на три группы: параметры расчёта и ограничения; справочники видов и сортов шпона; визуальную карту маршрутизации сырья и полуфабрикатов от передела к переделу. Постепенно начал вырисовываться рабочий прототип, который уже возвращал эталонный производственный план. Целевая функция сочетала максимизацию маржи и максимальную утилизацию сырья. «Силу» стремления к каждой цели можно было задавать в процентах. Результат уже не пересказывала языковая модель. Система формировала таблицу ассортимента, учитывала нецелевой выход — например, когда на выходном контроле часть продукции получается ниже сортом, чем планировалось, что для фанерного производства вполне обычная ситуация. Такой объём автоматически переоценивался и попадал в маржу с учетом уценки. Вместе с итоговым ассортиментом система показывала общую маржу и процент утилизации по каждому виду шпона. В этот момент у меня впервые появился не математический эксперимент, а прототип, который уже можно было проверять на реальных производственных сценариях. #производство #фанера #sop #экономика #финансы #разработка