Как на самом деле работает map в Go
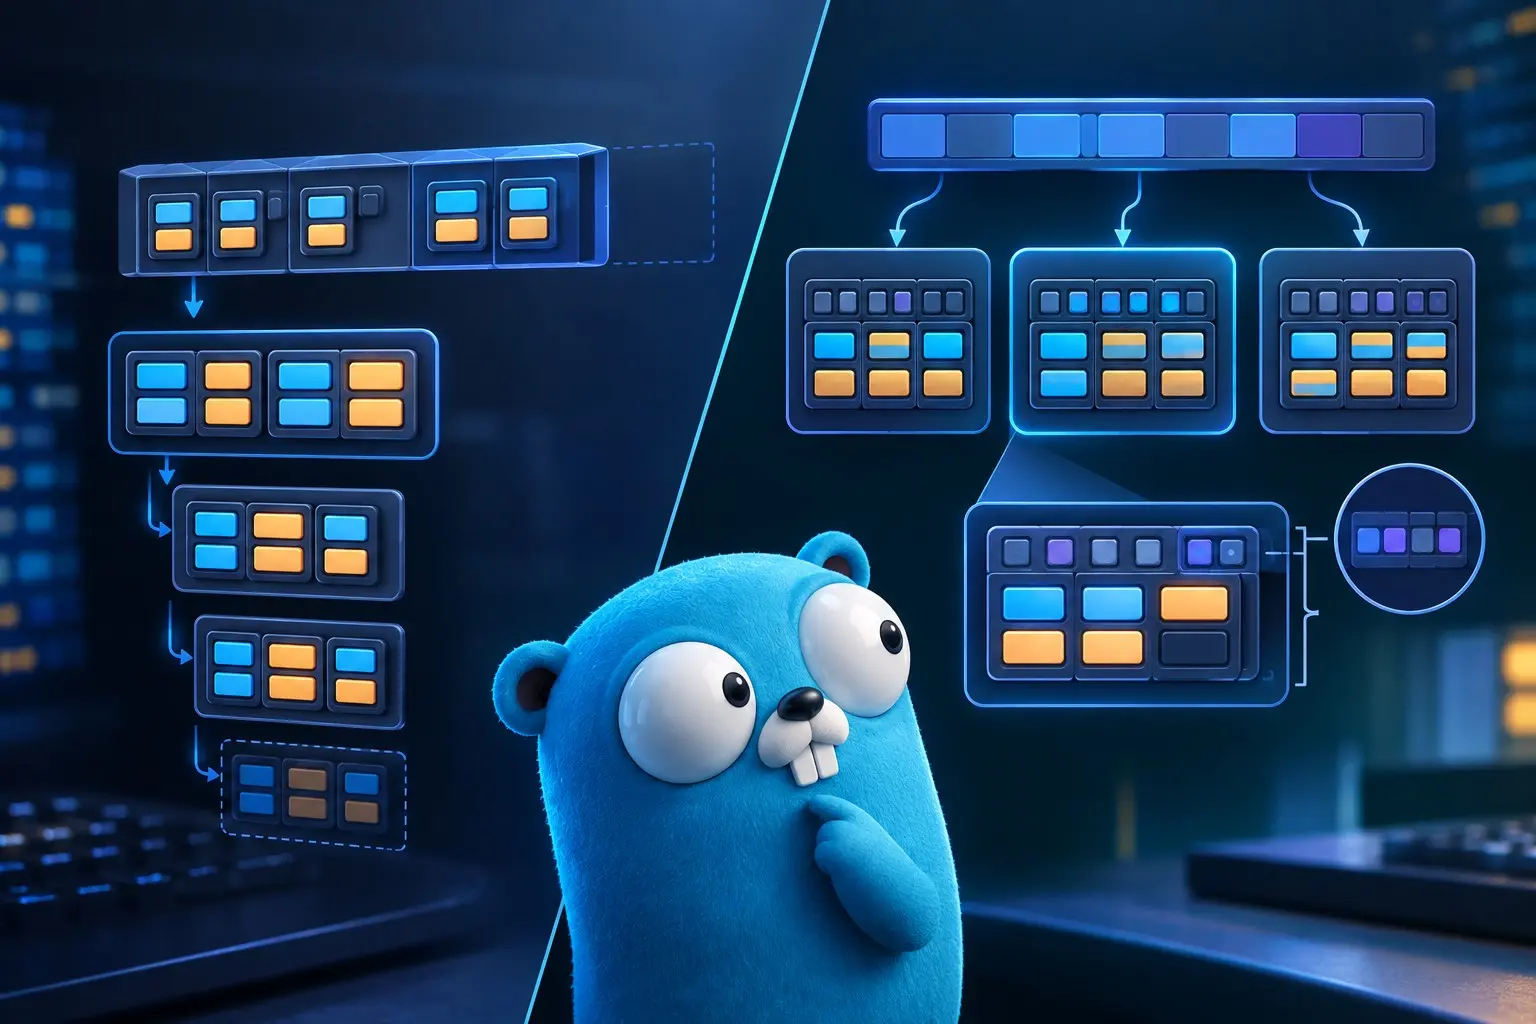
Как на самом деле работает map в Go map[string]int выглядит просто: users := map[string]int{ "alice": 10, "bob": 20, } Но внутри это довольно интересная структура. Причём начиная с Go 1.24 встроенный map работает уже не так, как раньше. Старый map До Go 1.24 основой были buckets. Один bucket мог хранить до 8 пар key/value: map | +-- bucket | +-- key/value | +-- key/value | +-- ... | +-- bucket | +-- bucket При поиске сначала вычислялся hash ключа. Часть hash определяла нужный bucket, а небольшая часть сохранялась как tophash. Условно: hash("alice") | v bucket #5 | +--> tophash | +--> key == "alice"? То есть runtime сначала быстро проверял fingerprint, а уже потом сравнивал настоящий ключ. Overflow buckets Если bucket переполнялся, создавался overflow bucket: bucket | v overflow | v overflow При большом количестве таких цепочек поиск становился дороже. Плюс данные оказывались разбросаны по памяти, что хуже для CPU cache locality. Когда map рос, runtime не переносил всё мгновенно. Использовался incremental growth - старые buckets постепенно переносились в новую структуру во время последующих операций. Go 1.24: Swiss Tables В Go 1.24 реализацию map полностью переработали. Теперь используется подход Swiss Tables. Упрощённо: Map | +-- Directory | +-- Table | | | +-- Groups | +-- Table | +-- Table Table состоит из групп, а в каждой группе 8 slots. Рядом находятся control bytes. Они позволяют быстро понять состояние каждого slot: EMPTY DELETED USED Для занятого slot хранится небольшая часть hash - fingerprint. Поэтому поиск выглядит примерно так: hash | v group | +--> control bytes | +--> нашли подходящий fingerprint | v сравнили key Сначала дешёвая проверка fingerprint, потом настоящее сравнение ключа. Что с коллизиями? Новая реализация использует open addressing. Если подходящий slot не найден, поиск переходит к следующей группе: group 5 ↓ group 6 ↓ group 7 Вместо старой цепочки: bucket ↓ overflow ↓ overflow Это помогает лучше использовать locality памяти. Что происходит при delete? После: delete(users, "alice") slot нельзя просто пометить как EMPTY. Через него может проходить цепочка поиска. Поэтому используется специальное состояние: [ USED ][ USED ][ DELETED ][ USED ][ EMPTY ] DELETED ещё называют tombstone. Он означает: здесь был элемент, поэтому поиск должен продолжаться. А EMPTY позволяет остановить поиск. Как растёт новый map? Новый map разбит на несколько tables. Отдельные tables могут расти независимо, а большие могут разделяться: Table / \ A B Для выбора table используются биты hash. Это позволяет выполнять рост более локально, а не перестраивать огромную структуру целиком. Старый vs новый Если совсем упростить: OLD
hash ↓ bucket ↓ 8 slots ↓ overflow ↓ overflow NEW
hash ↓ table ↓ group ↓ 8 slots + control bytes ↓ next group Главная разница: старый map: bucket + overflow buckets новый map: Swiss Tables + open addressing + control bytes + groups + directory И это хороший пример того, как меняется runtime, хотя код разработчика практически не меняется: m[key] = value остался тем же. Но под ним теперь совершенно другая структура. Поэтому иногда полезно заглядывать внутрь runtime. Не для того, чтобы писать свой hash map. А чтобы понимать, почему обычный map имеет именно такую производительность и такое поведение с памятью.