


⚡️llms.txt: можно ли управлять и блокировать ИИ при обходе сайта?
Продолжаем #seoразбор. Сегодня про llms.txt: помогает ли этот файл попадать в ответы ИИ или просто добавляет галочку в аудите..
Короче, сделали тест у себя в GEO-LAB.
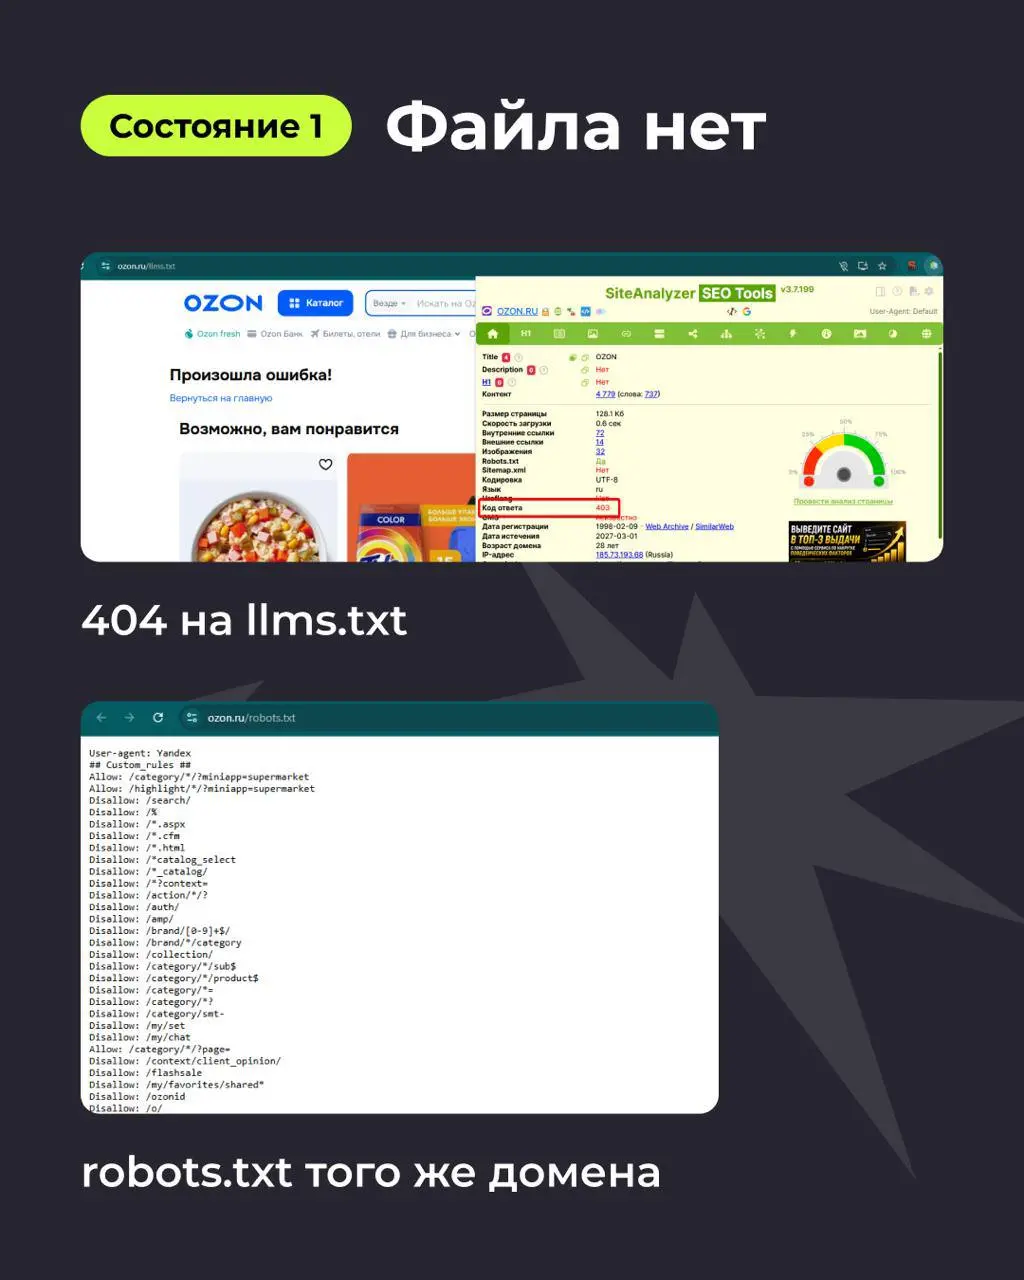
✔️ Состояние 1. Файла нет
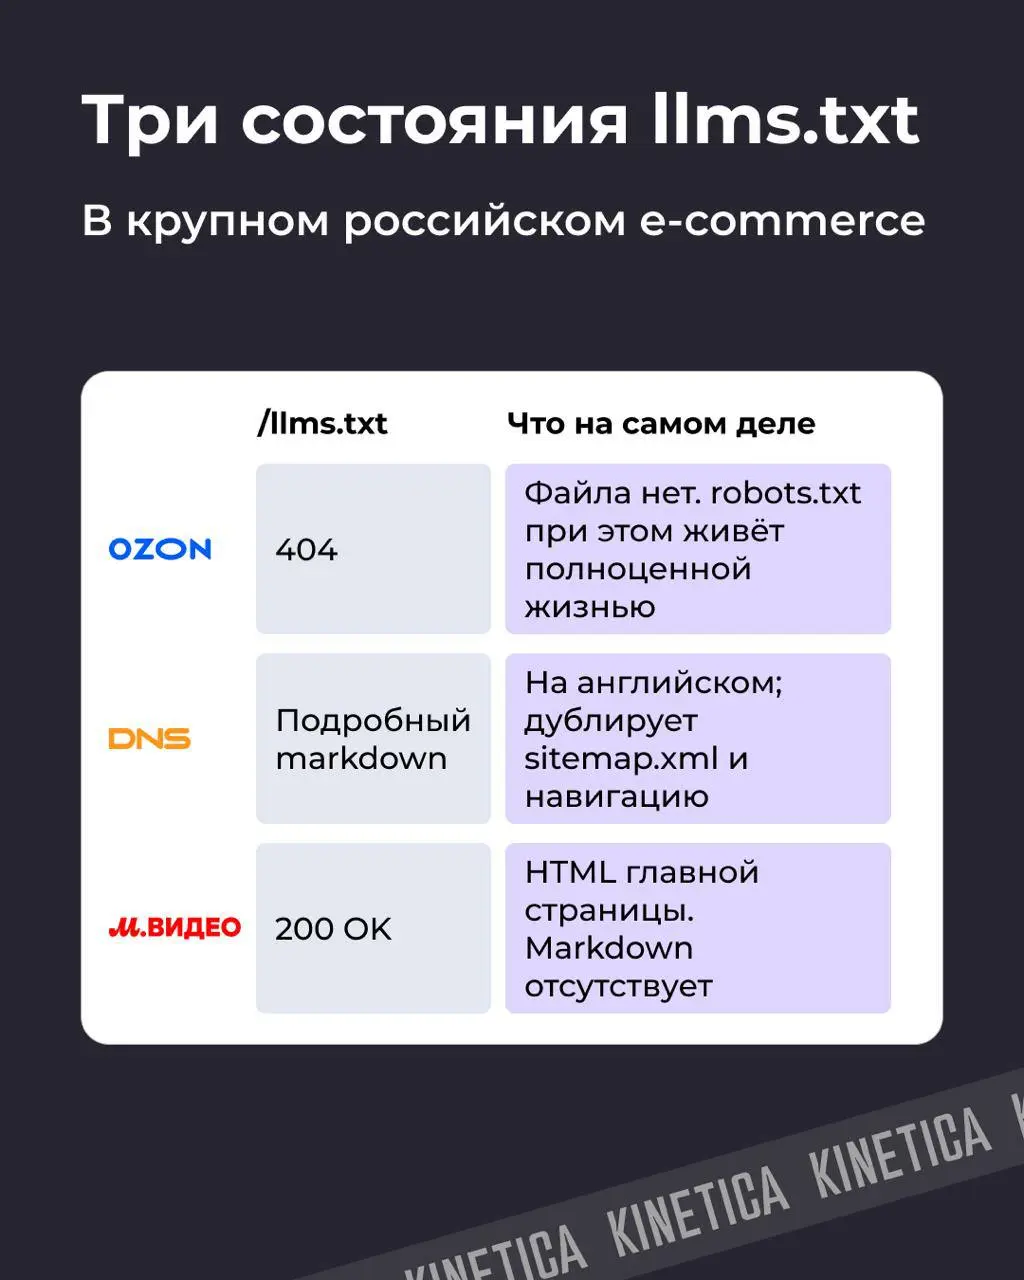
Ozon: /llms.txt возвращает 404. При этом robots.txt на месте и живёт полноценной жизнью.
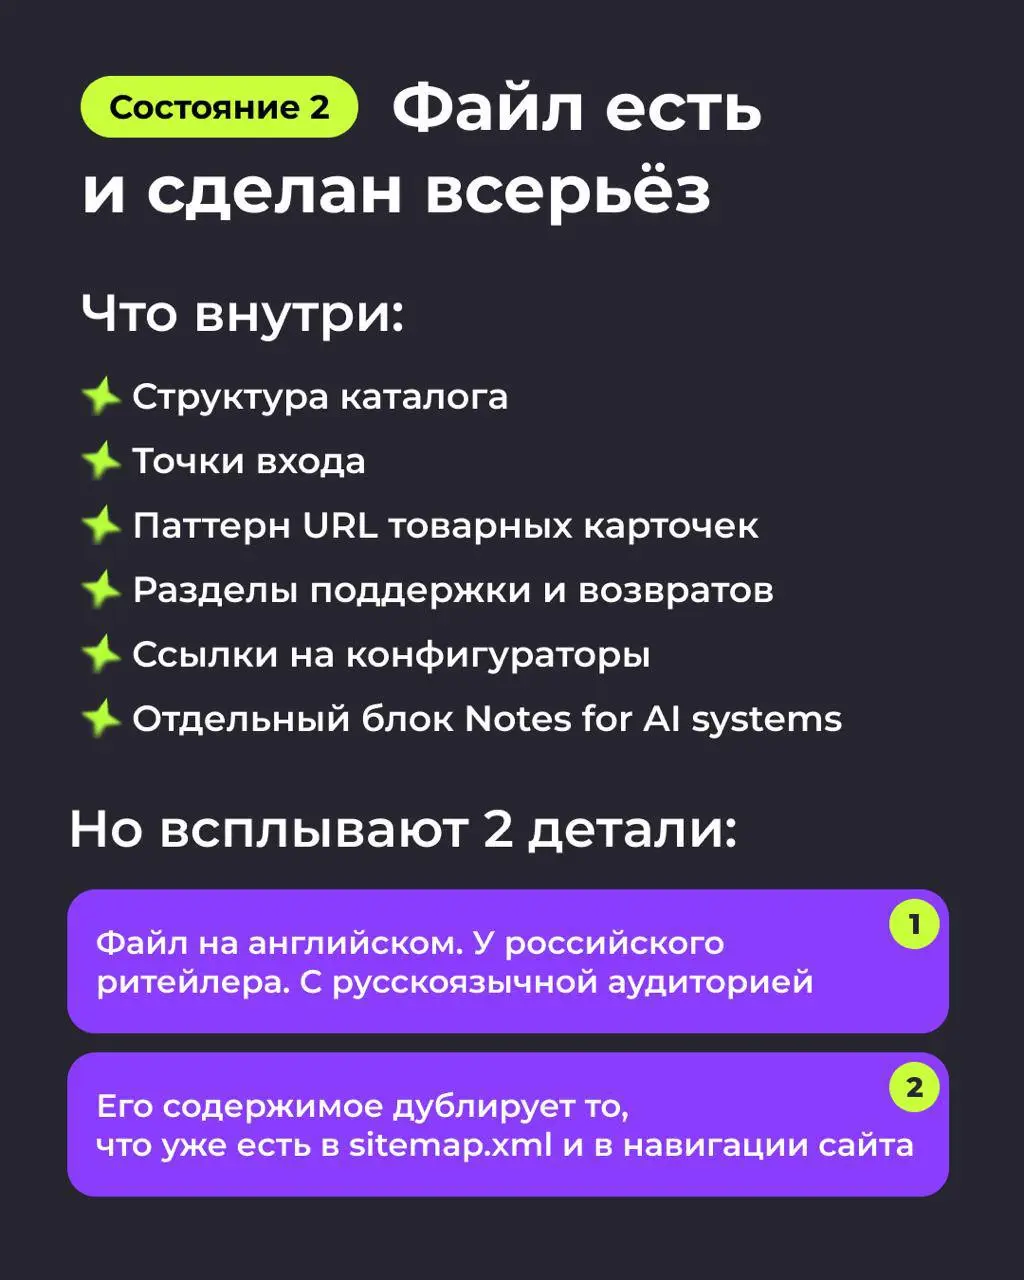
✔️ Состояние 2. Файл есть, сделан всерьёз
DNS: помимо robots.txt, на сайте есть подробный llms.txt в формате Markdown.
Внутри: структура каталога, точки входа, паттерн URL товарных карточек, разделы поддержки и возвратов, ссылки на конфигураторы, отдельный блок Notes for AI systems.
Тут две важные детали: ✔Файл на английском - у российского ритейлера с русскоязычной аудиторией.
✔И его содержимое дублирует то, что уже есть в sitemap.xml и в навигации сайта.
Сам файл о себе пишет честно: это описательный документ, а не набор правил.
✔️ Состояние 3. Файл «есть»
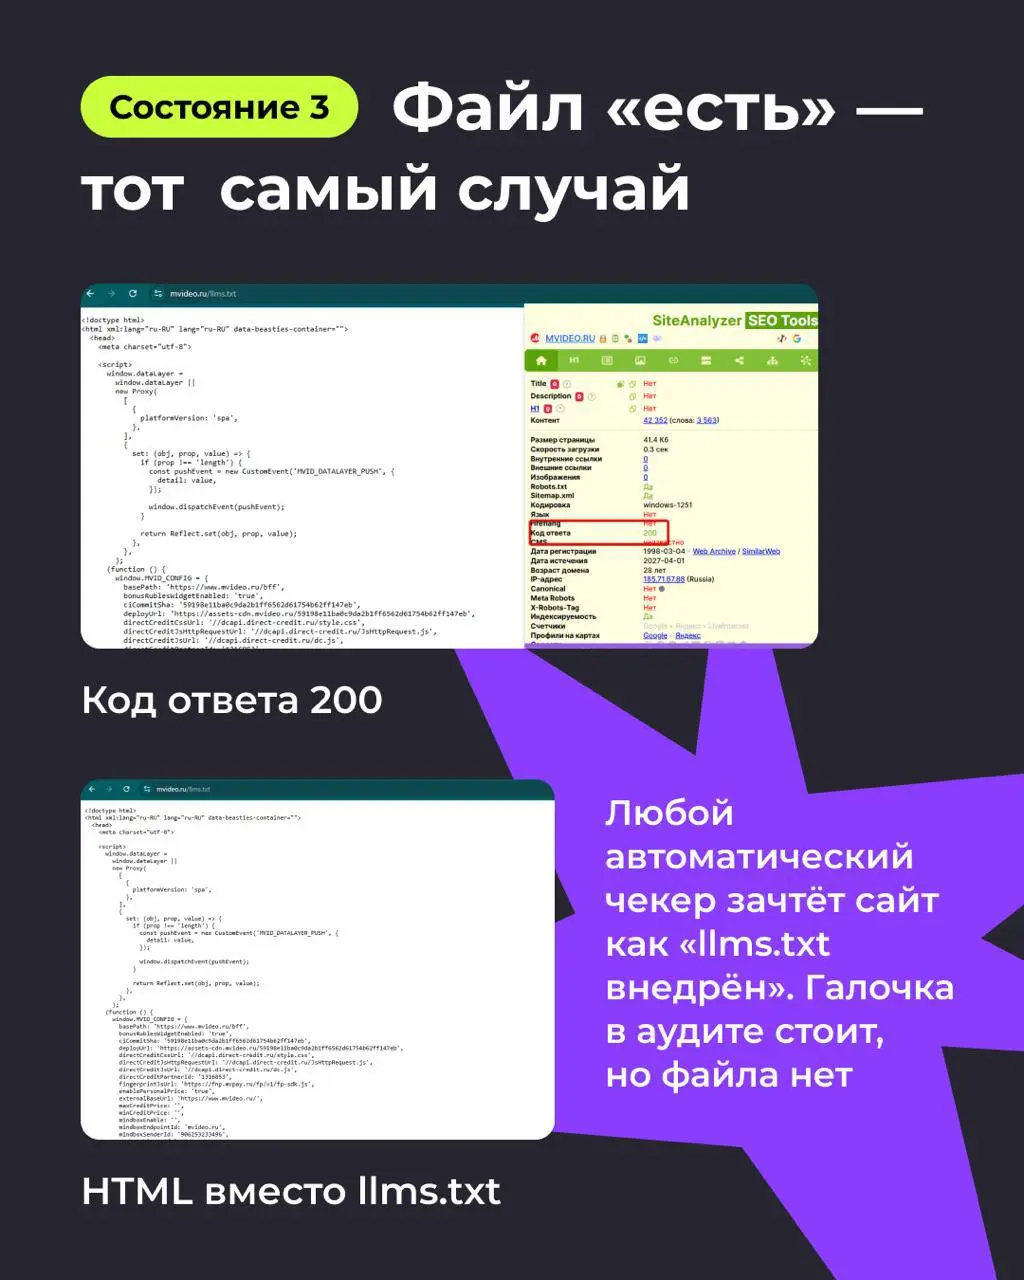
М.Видео: /llms.txt отдаёт 200 OK. Мы проверили отдельно, потому что не поверили.
Внутри - HTML главной страницы. Это SPA на Angular: приложение возвращает index.html на любой неизвестный адрес. В теле подключение Google Tag Manager, preload шрифтов Roboto, тег . Markdown отсутствует.
И там же, в этом самом HTML: html
Мёртвый мета-тег со значением null - на странице, которую сайт отдаёт вместо файла для ИИ.
🤓 Почему третий случай важнее двух первых? Код 200 означает, что любой автоматический чекер зачтёт этот сайт как «llms.txt внедрён». Галочка в аудите стоит. Файла нет.
И это никого не побеспокоило. Если бы кто-то читал llms.txt и от этого зависел результат, подмену бы заметили — по логам, по отчётам, по эффекту. Не заметили, потому что эффекта, за которым следят, нет.
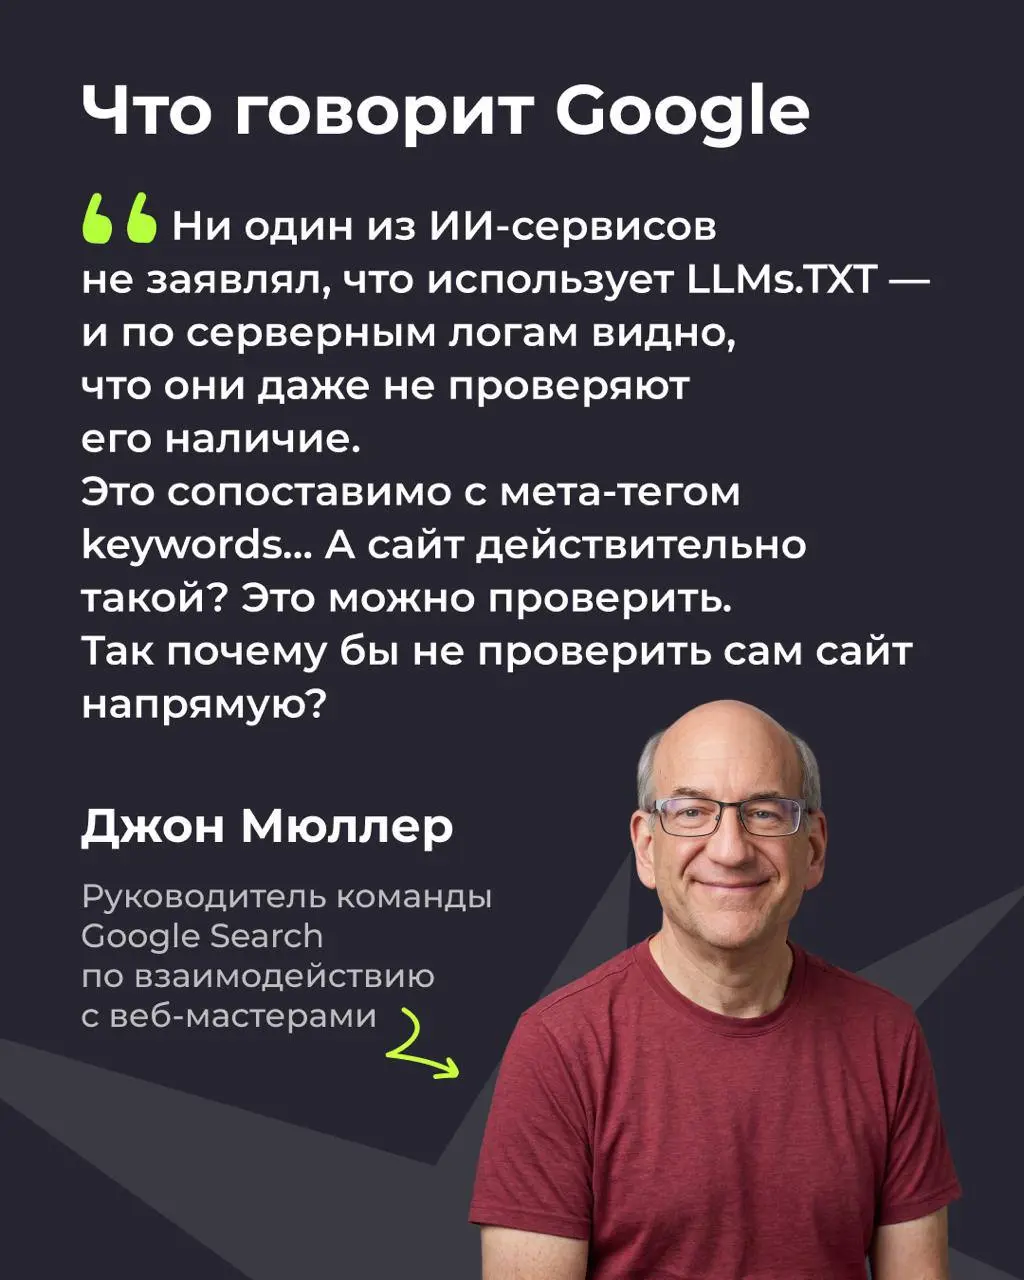
🕵️ Что говорит Google. Тред в r/TechSEO: автор положил llms.txt в корень блога и через месяц не увидел в логах обхода никакой реакции. Спросил, у кого есть система отслеживания и заметил ли кто-нибудь эффект.
В комментарии ответил Джон Мюллер из Google: Насколько мне известно, ни один из ИИ-сервисов не заявлял, что использует LLMs.TXT (и по серверным логам видно, что они даже не проверяют его наличие). По-моему, это сопоставимо с мета-тегом keywords — это то, чем владелец сайта объявляет свой сайт… (А сайт действительно такой? Ну, это можно проверить. И раз так — почему бы просто не проверить сам сайт напрямую?) Первая часть по сути то про факт: заявлений о поддержке нет, обращений в логах нет. Вторая уже поинтереснее. Мюллер сравнивает llms.txt с keywords не по бесполезности, а по устройству: это так сказать декларация владельца о содержимом собственного сайта. А сам сайт при этом доступен для прямой проверки.
Здесь суть - краулер может открыть страницы и посмотреть, что там. Зачем ему верить пересказу, когда есть оригинал.
Ровно по этой причине умер keywords. И ровно по этой причине не работает llms.txt. Вопрос не закрыт, споры идут. Но у нас нет ни одного кейса, где внедрение llms.txt или llms-full.txt дало измеримый результат — ни в цитируемости, ни в позициях, ни в лидах.
Настораживает сама конструкция: появляется новая среда, правил никто не знает, и тут же возникает артефакт, который якобы всё решает. Один файл в корне - и вы в ответах ИИ. В диджитале такой палочки не было ни разу.
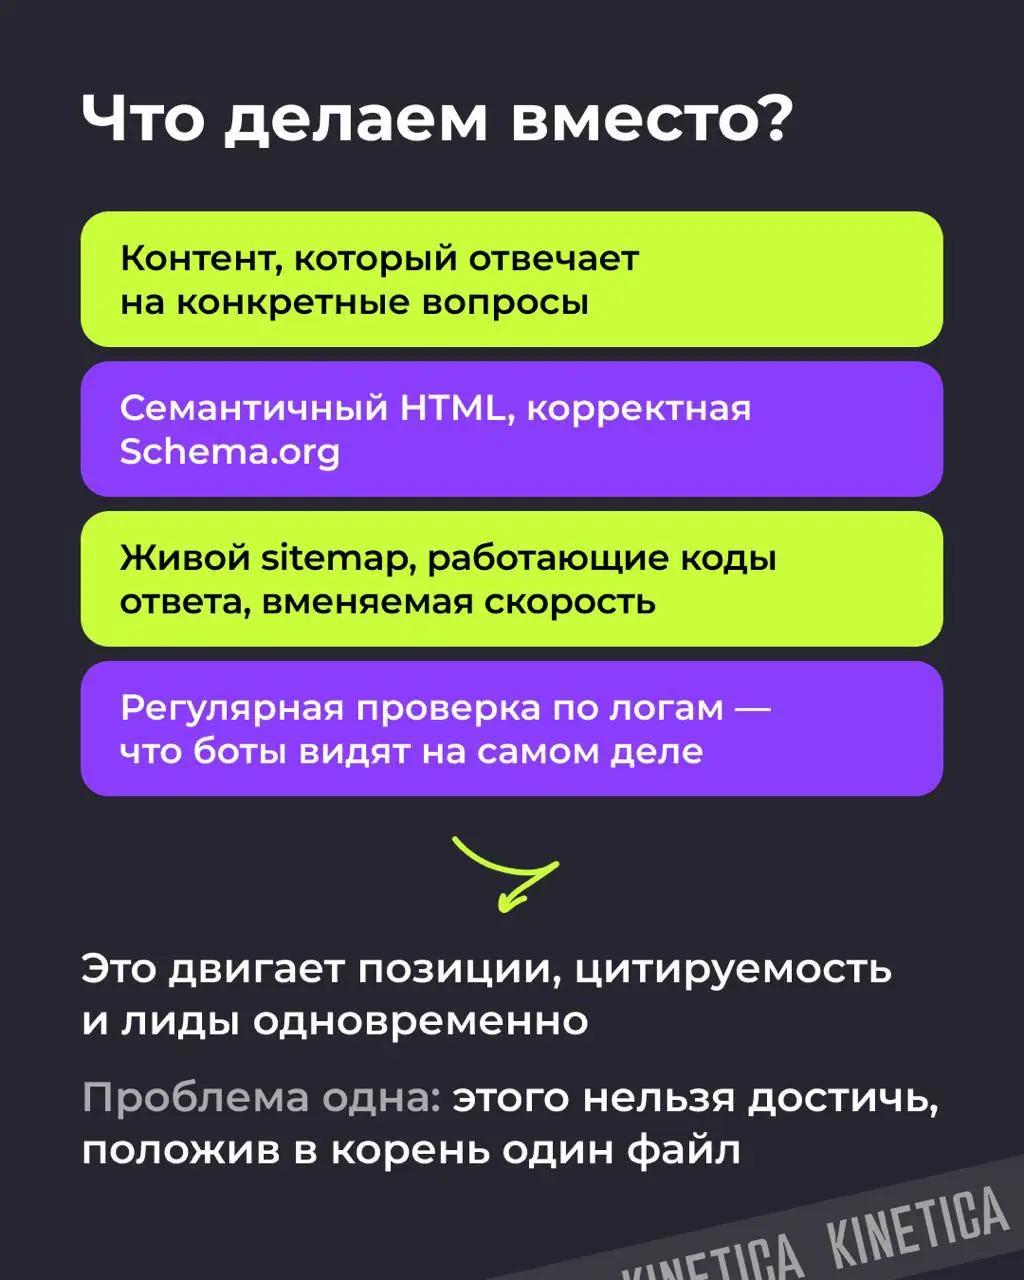
✍️ Итак, что делаем вместо: ✔ контент, отвечающий на конкретные вопросы ✔ семантичный HTML ✔ корректная Schema.org ✔ живой sitemap ✔ работающие коды ответа ✔ вменяемая скорость ✔ регулярная проверка того, что боты видят на самом деле - по логам
Это двигает позиции, цитируемость и лиды одновременно. Проблема одна: этого нельзя достичь, положив в корень один файл.
Появятся кейсы с воспроизводимым эффектом - пересмотрим позицию и напишу об этом.
Всем лидов ❤️ 🚀


· 4 ч
Это бесполезный файл, держу в курсе))
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
коммент удалён