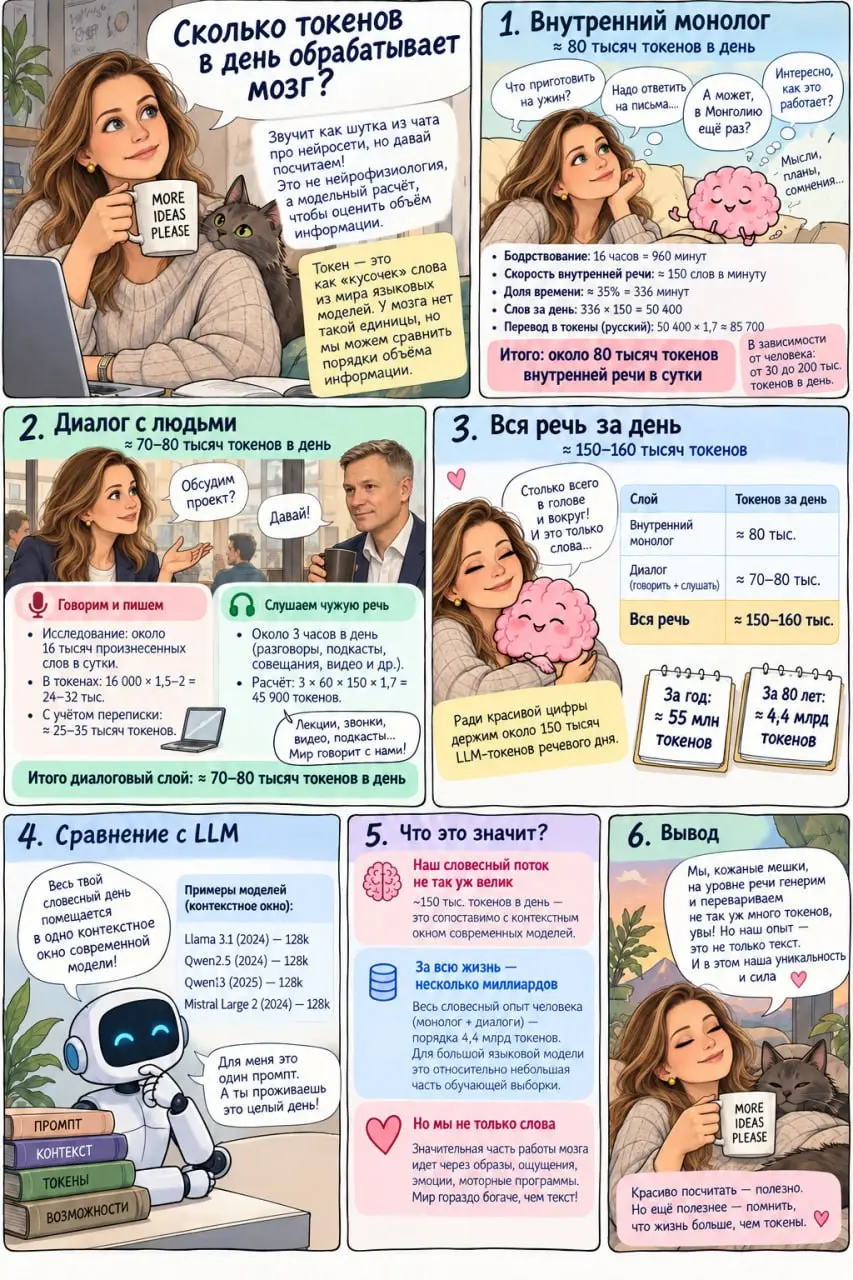
Сколько токенов в день обрабатывает человеческий мозг?
Если считать только слова, результат даже немного обидный: · внутренний монолог - около 80 тысяч токенов в день; · разговоры, переписка и услышанная речь - еще 70-80 тысяч; · весь словесный поток за 80 лет - примерно 4,4 млрд токенов.
То есть весь наш речевой день почти помещается в одно контекстное окно современной LLM. Мы, кожаные мешки, генерим не так уж много текста.
Но дальше начинается самое интересное. Если добавить зрение, слух, тело, запахи и вкус, игровая модель дает около миллиона смысловых единиц в день. А сырой поток от сенсорных рецепторов может достигать 7,2 триллиона условных токенов за сутки.
И весь этот информационный водопад обрабатывает устройство массой 1,4 килограмма и мощностью около 20 ватт.
Оно не просто предсказывает следующий токен: оно видит, слышит, держит равновесие, чувствует боль, вспоминает прошлое, назначает сигналам эмоциональный вес - и в конце концов заставляет тело что-нибудь сделать.
Так что человеческий мозг пока рано отправлять в утиль истории. Да, ИИ уже читает быстрее нас и помнит больше текста. Но между большим контекстным окном и существованием в реальном мире все еще лежит приличная технологическая пропасть.
В новом лонгриде от Сергея считаем токены внутреннего монолога, разговоров, органов чувств и целой человеческой жизни. С формулами, допущениями, триллионами сигналов и небольшой серверной стойкой из мяса.
Спойлер: суперсила мозга не в том, чтобы обработать максимум токенов, а в том, чтобы понять, какие из них действительно важны, - и превратить их в действие.