🚀 Как мы сделали RAG-аналитика для годовых отчётов
Суть: обычная LLM плохо работает с документами - либо не влезает весь отчёт в контекст, либо модель начинает «галлюцинировать» цифры. Мы решили сделать систему, которая сначала находит нужный кусок отчёта, а потом уже отвечает на вопрос - со ссылкой на конкретную страницу-источник.
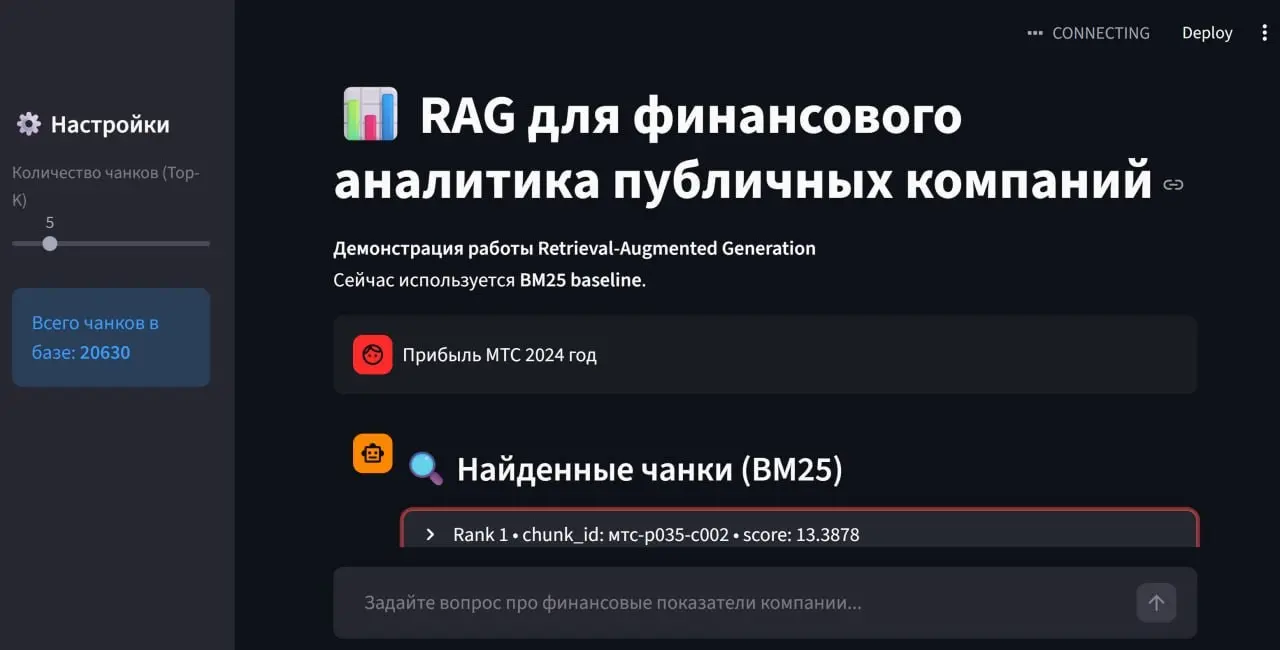
Что сделали: - собрали больше 40 годовых отчётов публичных компаний (Газпром, Сбер, МТС, Магнит и др.) и распарсили PDF в текстовые чанки; - создали golden set - эталонные вопросы про выручку, прибыль, активы и т.д. с проверенными вручную ответами; - сравнили три подхода к поиску: обычную LLM без поиска (baseline), классический полнотекстовый поиск (BM-25) и семантический поиск на эмбеддингах; - посчитали метрики качества (Hit@10, MRR и др.) и честно сравнили с рандомным бейзлайном; - собрали демо-интерфейс, где можно задать вопрос на естественном языке и получить ответ со ссылкой на источник.
Что выяснили: семантический поиск ощутимо обходит поиск по ключевым словам (почти в 9 раз по Hit@10), но и ему пока есть куда расти - предстоит доработка (гибридный поиск, реранкинг, “более умный” чанкинг таблиц).
Путь от сырых PDF до рабочего прототипа RAG-системы был тернистым, но увлекательным🙌
* к слову, мы еще подгрузили проект на Streamlit (ссылка на Github репозиторий с проектом https://github.com/pskripnikk-crypto/RAG_for_Analytics)