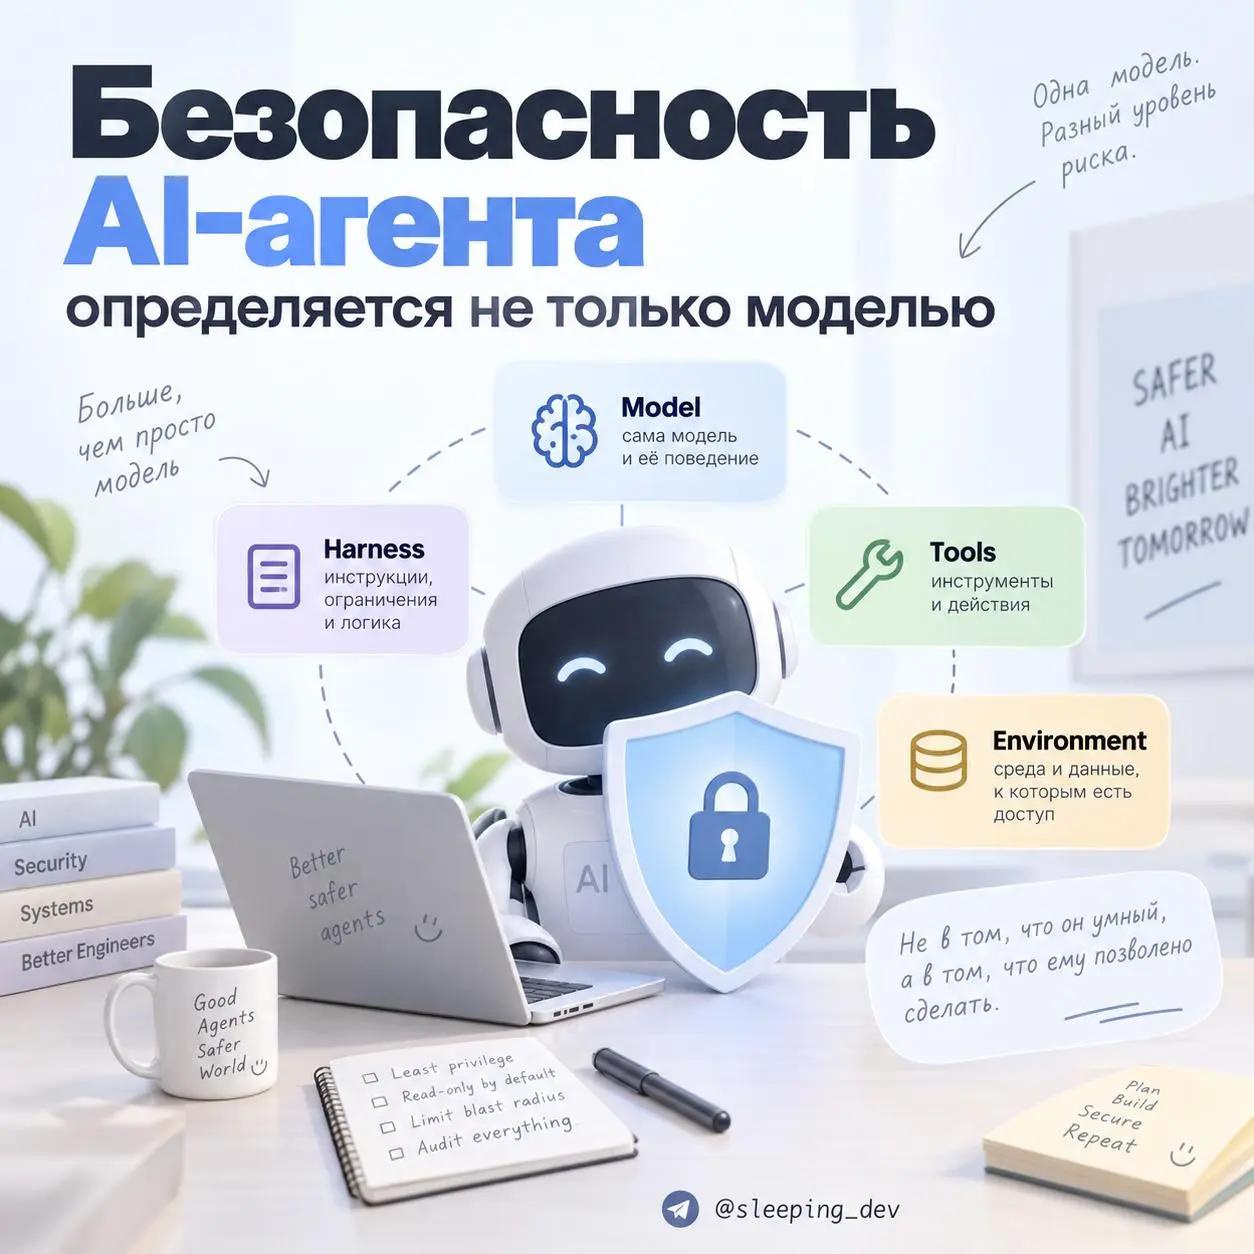
Безопасность AI-агента определяется не только моделью
Когда обсуждают безопасность AI-агентов, вопрос обычно звучит так:
«Можно ли доверять Claude, GPT или Gemini?»
Но модель — лишь один компонент системы. И для реального уровня риска часто не самый важный.
В материале Trustworthy agents in practice Anthropic предлагает смотреть сразу на четыре слоя:
— Model — сама модель и её поведение. — Harness — инструкции, ограничения и логика, которая управляет агентом. — Tools — инструменты и действия, доступные агенту. — Environment — среда и данные, к которым он получил доступ.
Для тимлида это полезная смена фокуса.
Вопрос не только в том, ошибётся ли модель. Она обязательно когда-нибудь ошибётся.
Гораздо важнее другое:
Что система позволит ей сделать после ошибки?
Одна и та же модель может:
— читать задачи в Jira; — менять статусы, исполнителей и описания; — запускать скрипты в production.
Формально модель одна. Фактически это три системы с совершенно разным уровнем риска.
Поэтому безопасность агента я бы проектировал так же, как любую другую критичную систему:
— минимально необходимые права; — ограниченный blast radius — масштаб возможного ущерба; — read-only по умолчанию; — явное подтверждение опасных действий; — изоляция среды; — журнал действий и возможность остановить выполнение.
Не нужно начинать с попытки сделать агента безошибочным. Это примерно такой же надёжный план, как запретить разработчикам писать баги.
Лучше исходить из того, что ошибка произойдёт, и заранее ограничить её последствия.
Безопасность агента определяется не только тем, насколько он умный. Она определяется тем, насколько опасную ошибку ему позволили совершить.
Материал: Anthropic — Trustworthy agents in practice