


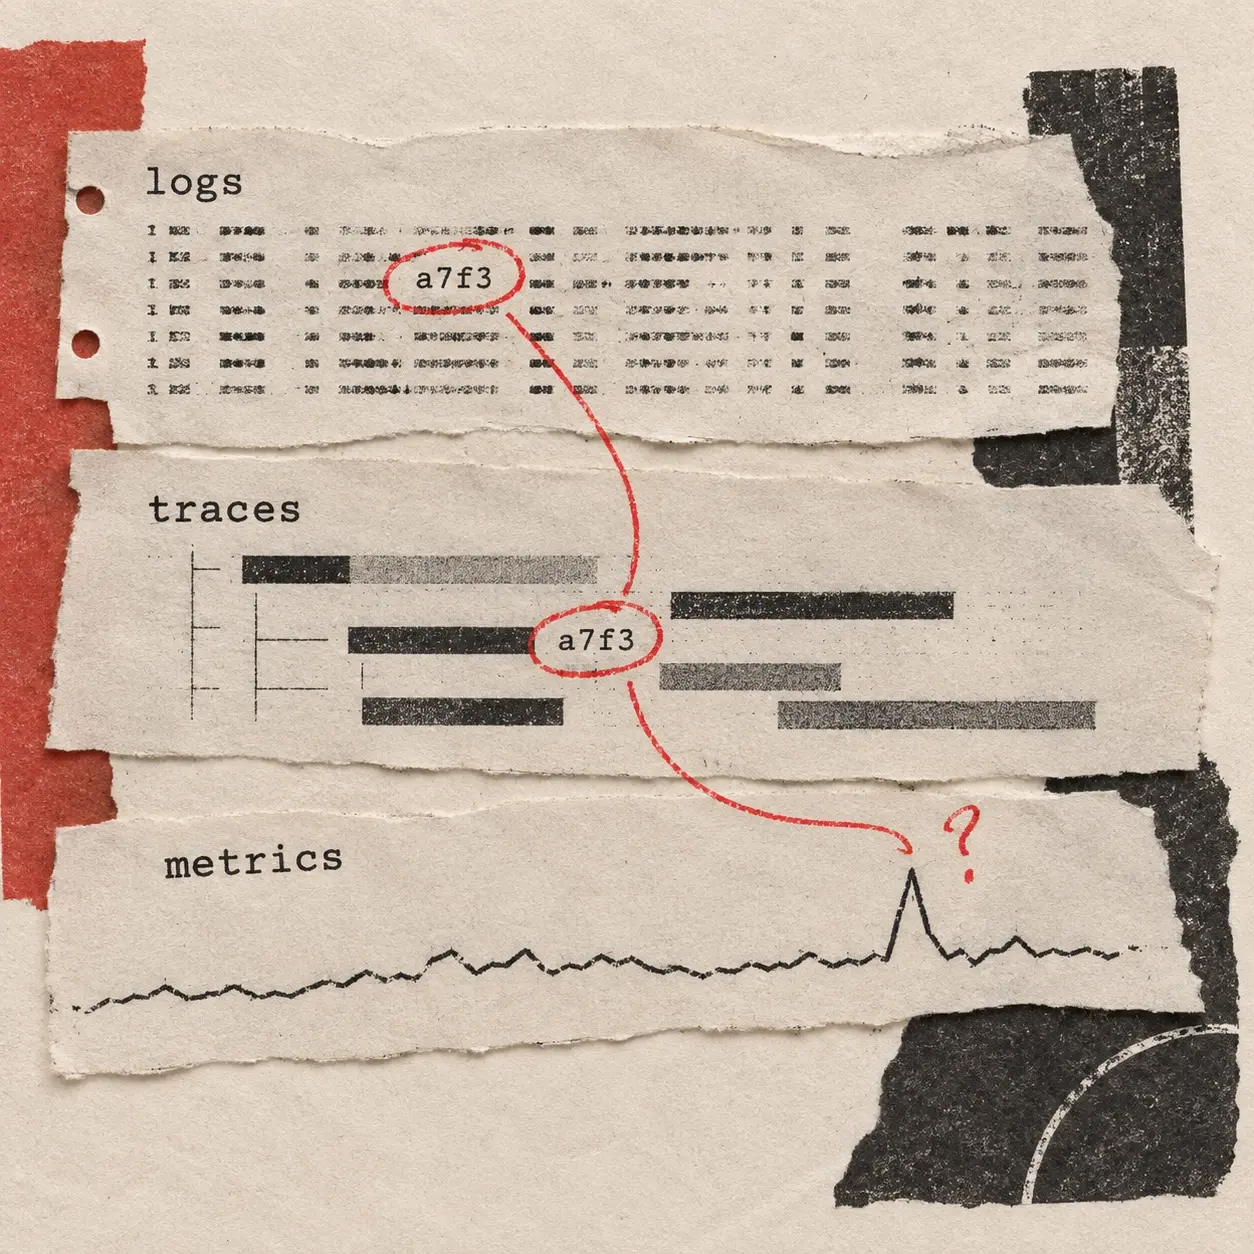
Ошибка в логах нашлась. А что происходило с самим запросом?
Берешь trace_id, смотришь, через какие сервисы прошел запрос, где задержался. Потом еще метрики за это время. Вроде разбираешь одну ошибку, а данные приходится собирать из нескольких мест. ⠀ Хотим, чтобы с этим помогал свой ИИ-агент. У нас сначала вообще была задача дать разработчикам доступ к базе и логам через агента. Для этого делаем Clavis. Администратор выбирает, кому какие подключения доступны, и может этот доступ отозвать. ⠀ В обновлении добавили Prometheus и VictoriaTraces. Через Clavis агент теперь может запрашивать данные из базы, логов, метрик и трейсов. ⠀ Первое внедрение уже работает, готовим второе. Теперь хочется дойти до разбора, где агент нашел причину, показал, как проверил, и разработчику не пришлось заново проходить весь путь за ним.


· 25.09
Пункт «показал, как проверил» тут главный, потому что агента легко увести теми же ловушками, на которых спотыкается человек. У меня их было три подряд. Добавил повторы к падающему запросу, и быстрая ошибка превратилась в зависание — симптом вылечил симптомом. Потом docker logs --since 24h после пересоздания контейнера показал логи только с момента старта, и «одно падение за сутки» оказалось «одним за десять минут». Третья вышла обиднее всех: сам опечатался в имени колонки в ручном тесте, получил «column does not exist» и пятнадцать минут искал, кто переименовал поле в проде.
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
коммент удалён