Почему RAG-бот иногда отвечает «не знаю» ✍️ В августе я только начинал погружаться в RAG и собирал первую версию информационного бота для DE-практикума. Тогда задача выглядела довольно коротко: загрузить материалы курса, подключить LLM и научить её отвечать на вопросы.
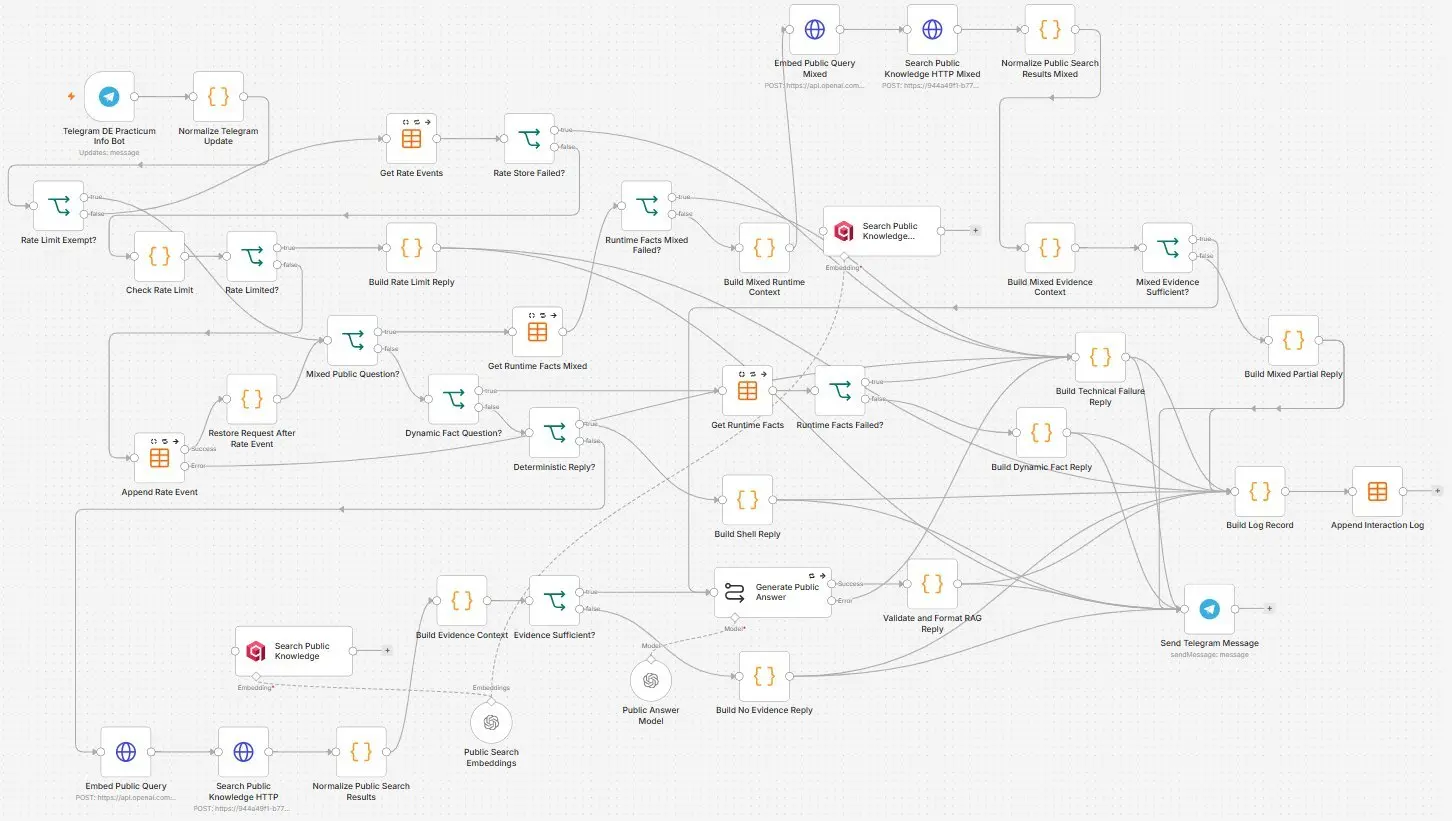
Сейчас бот уже работает в бета-режиме, а схема внутри выросла в нормальный пайплайн. Хочу показать, что происходит между сообщением в Telegram и готовым ответом, и почему иногда правильный результат этого пайплайна звучит как «я не знаю».
📣 RAG расшифровывается как Retrieval-Augmented Generation, или генерация с дополненным контекстом. Перед ответом модель получает несколько фрагментов, которые система нашла специально под вопрос пользователя. В этих фрагментах и нужно искать основание для ответа.
Например, человек спрашивает: Я аналитик, уверенно пишу JOIN и оконные функции, Python использую для небольших скриптов. Достаточно ли такой базы для входа и когда стартует следующий поток?
Теперь подробнее, что происходит:
В одном сообщении смешаны два типа данных. Требования к входу лежат в программе и меняются редко. Дата старта, цена и количество мест относятся к текущим условиям, поэтому их нельзя доставать из старого описания курса.
Сначала бот определяет тему вопроса. Затем поиск находит в базе знаний фрагменты, близкие по смыслу. Каждый найденный фрагмент получает оценку близости: чем она выше, тем лучше текст соответствует вопросу. Актуальные условия бот получает отдельно и только после этого собирает общий контекст для модели.
Если поставить высокий порог, в контекст попадут только очень близкие фрагменты. Ответов станет меньше, зато случайный текст из соседнего урока почти не пройдёт. Если опустить порог, бот будет отвечать чаще, но вместе с полезным контекстом начнут приезжать слабо связанные куски. Из них модель легко собирает убедительный, но неверный ответ.
Порог я проверяю на контрольных вопросах: смотрю, какие фрагменты нашлись, с какими оценками и хватает ли их для ответа. Отдельно прогоняю смешанные формулировки и вопросы, ответа на которые в базе нет.
До генерации слабые фрагменты отсекаются по порогу. Затем система проверяет, покрывает ли оставшийся контекст сам вопрос. Если человек спросил и про требования, и про дату старта, ответа только на первую часть недостаточно.
После генерации валидатор проверяет, подтверждаются ли основные утверждения контекстом и закрыты ли все части вопроса. Если нет, бот задаёт уточнение, отвечает только на подтверждённую часть или сообщает, что данных недостаточно.
В лог сохраняются вопрос, найденные фрагменты, их оценки, решение валидатора и итоговый ответ. Так можно разобрать случай, когда текст звучит нормально, хотя доказательств под ним нет.
Здесь ответ «я не знаю» становится полезной функцией. Неверная цена, дата старта или требование к участнику могут привести человека к неправильному решению. Поэтому я скорее приму меньше ответов, но с понятным основанием. Генерировать мусор ради высокой доли ответов здесь нет смысла.
В итоге внутри получился знакомый инженерный маршрут: входное сообщение, классификация, поиск, отсечка по порогу, сборка контекста, проверка, генерация и логирование. Только вместо строк в таблице через него проходит текст.
⌨️ Вот, поэтому сейчас боту можно написать о своём опыте и спросить, подходит ли текущая база для практикума, что будет в модулях по Spark и Airflow или как устроена проверка работ: https://t.me/de_practicum_info_bot
Шестой поток DE-практикума стартует 12 октября. Если бот ответит странно или пропустит часть вопроса, перешлите мне диалог. Такие примеры помогают точнее настроить поиск и пороги.
________________ В этом посте были ссылки, но мы их удалили по правилам Сетки