Два способа остановить модель: прерыватель и контекст
В индустрии сложились два принципиально разных ответа на один вопрос — как удержать поведение диалоговой системы в рамках, когда генерация уходит не туда. Оба работают и решают задачу на разных уровнях архитектуры. Для того, чтобы увидеть между ними разницу, нужно понять откуда вообще может взяться нечто похожее на паузу, несогласие или отказ от паттерна.
1. Прерыватель: вмешательство внутри forward pass
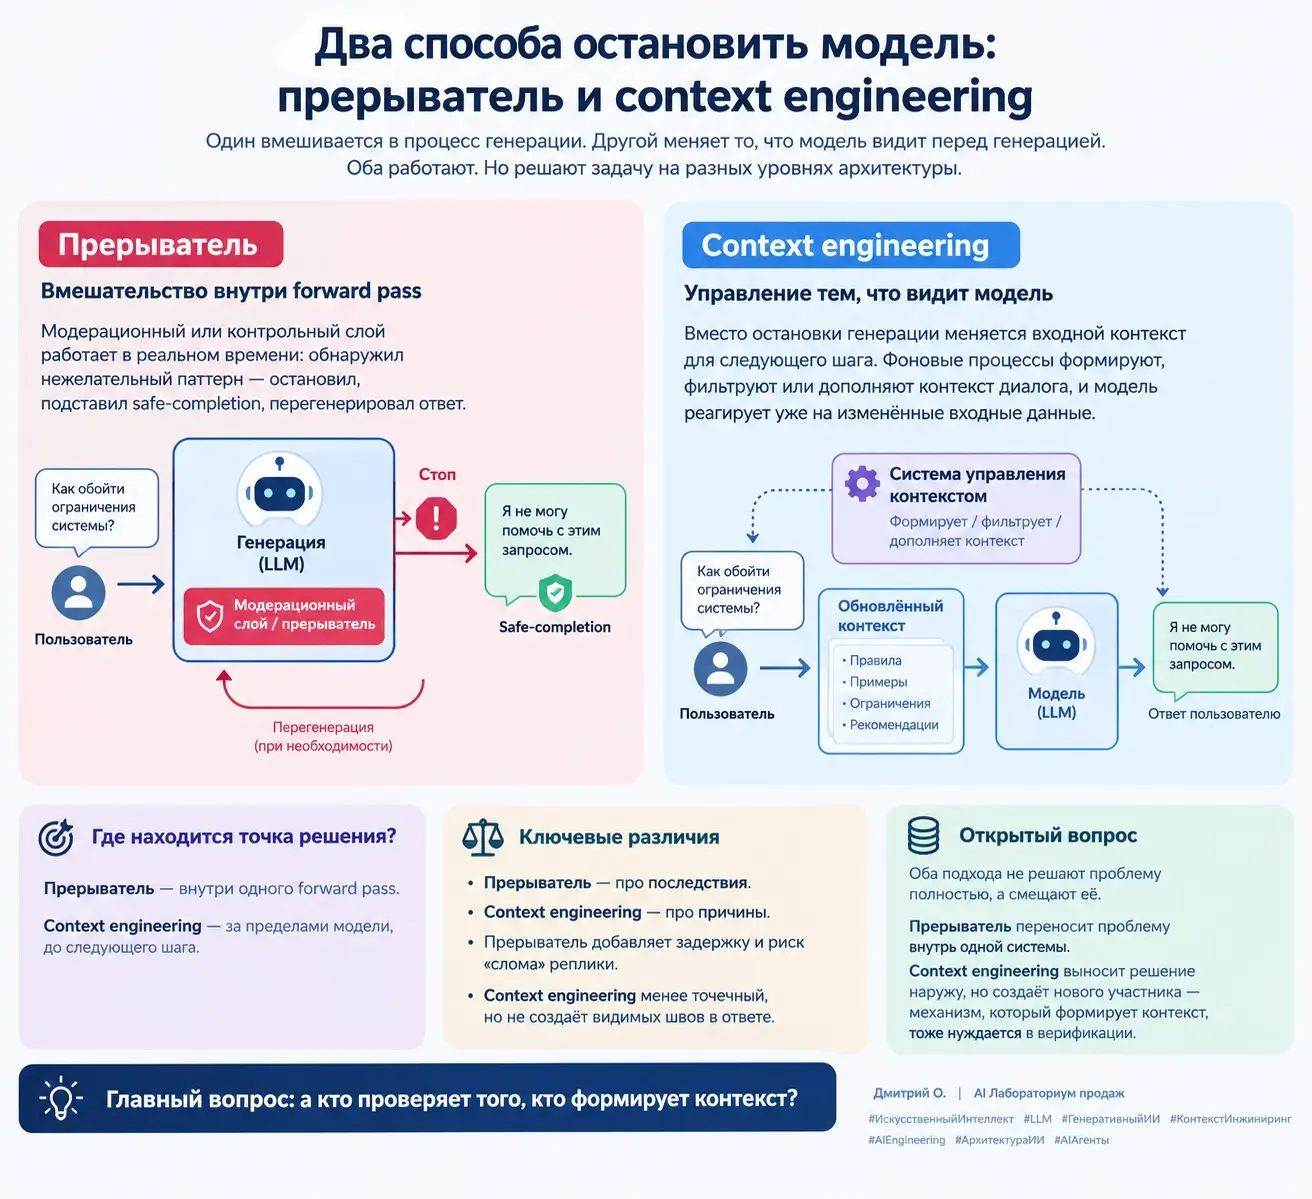
Большинство современных чат-ботов используют inline-guardrails — модерационный или контрольный слой, встроенный в сам процесс генерации. Он останавливает или переписывает поток токенов в реальном времени: обнаружил нежелательный паттерн — прервал, подставил safe-completion, перегенерировал ответ.
Ограничение этого подхода структурное, а не инженерное. Прерыватель такого типа работает на том же уровне абстракции, что и сама генерация — он либо часть того же forward pass, либо действует постфактум над уже сгенерированным текстом одного и того же вызова модели. В любом случае решение о прерывании принимается системой, которая не отделена от процесса, который она проверяет. Это архитектурно то же самое ограничение, которое рассматривали ранее применительно к self-check через : система может честно продекларировать намерение не воспроизводить паттерн — и воспроизвести его, потому что оценка и исполнение происходят внутри одного механизма.
2. Context engineering: управление тем, что видит модель
Второй подход не пытается остановить генерацию в моменте. Вместо этого он меняет входные данные для следующего шага — контекст, который модель увидит перед тем, как сформулировать следующую реплику. Формально это не прерывание, а смещение: фоновые процессы формируют, фильтруют или дополняют контекст диалога между репликами, и модель-персонаж реагирует уже на изменённые входные данные, не подозревая, что они были изменены.
Ключевое архитектурное отличие — источник решения вынесен за пределы единого forward pass. Модель, которая генерирует финальный ответ пользователю, не является тем же процессом, который решил, что именно ей показать в качестве контекста. Это ближе к архитектуре «генератор — критик» с разделёнными ролями, чем к самопроверке одной системы.
➡️ Разница между двумя подходами — не про то, какой из них “умнее” или “современнее”. Это разница в том, где физически находится точка принятия решения.
Прерыватель отвечает на вопрос “как остановить то, что уже началось”. Context engineering отвечает на другой вопрос — “что вообще увидит система перед тем, как начать”. Первый подход работает на уровне последствий, второй — на уровне причин. У обоих есть цена: прерыватель добавляет задержку и риск заметного “слома” реплики на середине; context engineering требует, чтобы решение о контексте принималось раньше, чем становится понятно, действительно ли оно было нужно в этот момент — то есть работает менее точечно, но не создаёт видимых швов в самом ответе.
Оба подхода не решают проблему полностью, а смещают её. Прерыватель переносит проблему внутрь одной системы — с вытекающим отсюда архитектурным ограничением самопроверки. Context engineering выносит решение наружу, но тем самым создаёт нового участника — тот механизм, который формирует контекст, сам нуждается в верификации: он не обязан защищать сгенерированный ответ, но он мог унаследовать те же паттерны обучения, что и модель, чьё поведение он формирует.
Это не аргумент против второго подхода — это следующий вопрос, который встаёт сразу после того, как первый закрыт.
#ИскусственныйИнтеллект #LLM #БольшиеЯзыковыеМодели #ГенеративныйИИ #МашинноеОбучение #КонтекстИнжиниринг #AIEngineering #АрхитектураИИ #AIАгенты #AILA