Data Lakehouse в облаке (часть 4): dbt, ClickHouse и DataOps
О чем: Построение витрин (факты/измерения), инкрементальный захват дельты dbt и CI/CD.
В предыдущих частях мы прошли огромный путь: собрали сырые JSON в слой Bronze, очистили их через кастомную валидацию PySpark в транзакционный слой Silver (Apache Iceberg) и оптимизировали затраты облака с помощью эфемерных кластеров.
Теперь данные готовы приносить пользу бизнесу. В этой финальной статье мы разберем, как построить сверхбыстрый аналитический слой с помощью dbt и ClickHouse, а также как автоматизировать доставку кода в продакшн используя GitHub Actions.
Слой витрин: Почему Spark уступает место dbt и ClickHouse?
Apache Spark идеален для «тяжелой» очистки, парсинга сырых структур и нормализации терабайтных массивов. Но когда дело доходит до финального SQL-моделирования, построения сложных агрегатов и частых изменений бизнес-логики витрин, Spark становится слишком инертным и дорогим.
Для этого этапа мы разделили зоны ответственности:
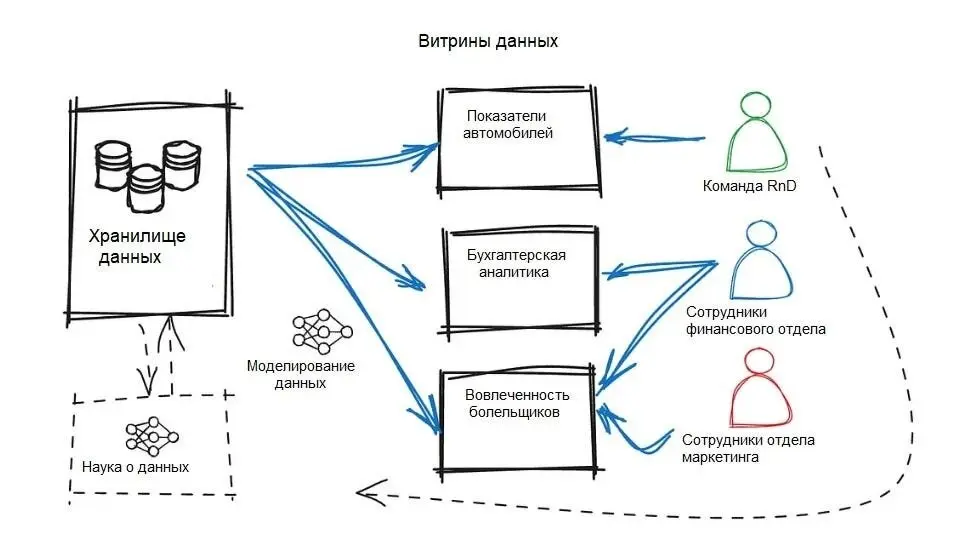
- Spark формирует стабильный, чистый срез данных в Gold-слое Iceberg. - dbt (data build tool) забирает эту дельту данных, берет на себя всю T-трансформацию (Transformation) на чистом SQL и управляет связями (DAG зависимостей витрин). - ClickHouse выступает в роли сверхбыстрой столбцовой СУБД, в которой эти витрины материализуются для мгновенной отдачи в BI (Apache Superset).
Настройка инкрементального захвата дельты
Чтобы не пересчитывать миллиарды строк исторических данных при каждом запуске, мы настроили модели dbt на инкрементальный режим. dbt сканирует Gold-слой в S3, забирает только новые коммиты Iceberg (с момента последней сборки) и выполняет быструю вставку в таблицы ClickHouse.
При проектировании таблиц в ClickHouse критически важно правильно выбрать движок (например, ReplacingMergeTree для дедупликации) и настроить ключи сортировки (ORDER BY) по reference-кодам, чтобы аналитические отчеты летали за доли секунды.
Пайплайн в GitHub Actions
Весь процесс развертывания прозрачен и контролируется через систему контроля версий. Мы внедрили жесткое правило: изменения в мастер-ветку попадают только после одобрения пулл-реквеста.
Автоматический CI/CD пайплайн в GitHub Actions устроен следующим образом: 1. Linter & Code Style: При создании Pull Request запускаются автоматические проверки качества кода (flake8/black для Python и sqlfluff для dbt-моделей). 2. Build: При слиянии кода в main GitHub Actions компилирует PySpark-пакеты и собирает dbt-манифест. 3. Deploy: Скомпилированные артефакты автоматически загружаются в Yandex Object Storage (S3), откуда их подтягивают Airflow и эфемерные кластеры
Заключение: Что дал бизнесу такой подход?
Построив полноценный Data Lakehouse по Медальонной архитектуре в Yandex Cloud, мы получили: 1. Полную надежность (ACID) поверх дешевого S3-хранилища благодаря Apache Iceberg. 2. Чистые данные без инфраструктурного оверхеда за счет легковесной кастомной валидации и карантина. 3. Экономию бюджета в 3–5 раз благодаря автоматическому запуску и гарантированному удалению эфемерных кластеров Data Proc в Airflow. 4. Скорость аналитики, когда dbt инкрементально обновляет витрины в ClickHouse, отдавая данные в BI за миллисекунды.
GitHub проекта: https://github.com/VasinDK/spark_med_analytics