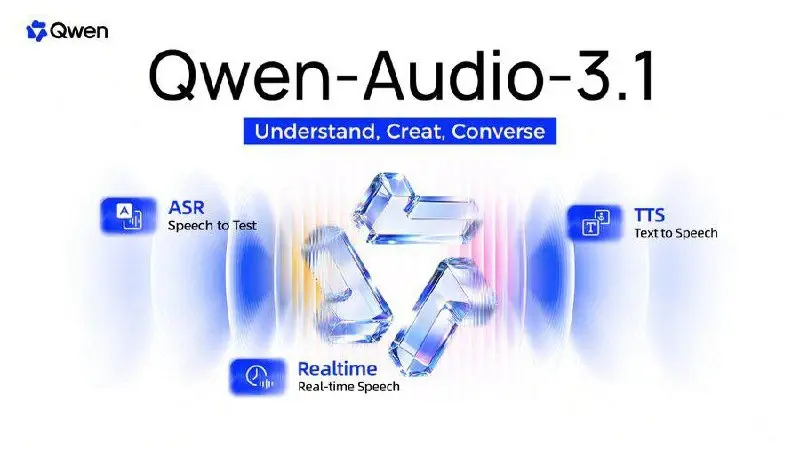
🎭 ГОЛОС В РЕЖИМЕ АКТЕРА 🎙 Alibaba выкатила Qwen-Audio-3.1-TTS — модель синтеза речи. Голосом можно управлять обычным текстом: скажи «испуганно», «как диктор радио» или «шёпотом» и ИИ послушается 😲✨. ▌ Управление эмоциями через промпт • 🗣 Интонация по запросу: скорость, громкость, тон — всё меняется одним словом в тексте. Больше никаких плоских озвучек из 2015-го • 🏷 86 аудиотега: смех, вздохи, дыхание, паузы, крики, шепот. Детализация уровня студийной записи, но без студии 🎛 • 🌍 16 языков, включая русский. Тембр сохраняется при смене языка — твой голос звучит так же уверенно на английском, как и на родном 🇺🇬🇧
▌ Клонирование голоса нового уровня → Достаточно одного примера записи для создания цифрового двойника 🎤 → Модель справляется даже с шумными записями, очищая фон и сохраняя характер 🔊✅ → Идеально для подкастеров, которые хотят озвучивать контент своим голосом, не записывая каждую фразу заново 👂💼
▌ Технические характеристики, от которых захватывает дух • ⏱️ До 3 минут непрерывной речи за один проход. Это целый рассказ, лекция или диалог без разрывов 📜 • 🎵 Качество до 48 кГц. Чистый звук, который приятно слушать в наушниках премиум-класса 🎧 • 🧠 Контекстное понимание. Паузы ставятся там, где нужно сделать вдох, а акценты — на важных словах 🎯 💥 ПОЧЕМУ ЭТО КРУТО? ▸ Естественность вместо синтетики Речь звучит так, будто её произносит живой человек с живыми эмоциями. Слышно волнение, радость, усталость. Это не TTS, это театр в твоем браузере 🎭❤️
▸ Полный контроль над подачей Ты становишься режиссером звука. Хочешь, чтобы персонаж говорил быстро и тревожно? Напиши это. Хочешь спокойный медитативный тон? Легко. Гибкость, которой не хватало всем предыдущим моделям 🎬🎚
▸ Мультиязычность без потери идентичности Клонированный голос сохраняет узнаваемость тембра при переводе. Твой бренд или личный блог может звучать одинаково узнаваемо в разных странах 🌐🔊
▸ Работа с «грязными» данными Не нужно искать идеальные чистые сэмплы. Алгоритм вычистит шум и оставит суть. Экономия времени на предобработке аудио 🧹⏳
▸ Высокая детализация звуковых эффектов Вздохи, смешки, глотательные движения — всё это включено в 86 тегов. Слушатели чувствуют присутствие говорящего, а не просто слышат информацию 👂👻
▸ Длинные форматы без обрезки 3 минуты подряд — это комфортный объем для большинства образовательных и развлекательных видео. Не нужно склеивать куски и терять интонацию на стыках ✂️ 💼 КАК ИСПОЛЬЗОВАТЬ В БИЗНЕСЕ? ▸ Масштабирование видеопродакшена Создавай сотни вариантов рекламных роликов с разными интонациями (срочно, дружелюбно, премиум) без найма десятков актеров озвучивания. A/B тесты звука становятся реальностью 📈🎙
▸ Персонализация обучения и поддержки Аудиокурсы, которые говорят с учеником эмпатично, делают паузы для осмысления и подчеркивают важные моменты. Поддержка клиентов получает человеческое лицо (и голос), снижая напряжение в конфликтах 🎓
▸ Создание виртуальных инфлюенсеров и аватаров Цифровые двойники брендов могут вести прямые эфиры, отвечать на вопросы и менять настроение в зависимости от ситуации. Узнаваемый голос = сильный бренд 🤖💼
▸ Локализация контента мирового уровня Переводи свои подкасты и видео на 16 языков, сохраняя оригинальный тембр ведущего. Зрители в Японии или Германии услышат «того же самого» эксперта, только на их языке 🌍🗣
▸ Быстрая прототипизация медиапроектов Писателям и геймдизайнерам: мгновенная озвучка диалогов для проверки ритма истории. Не жди актеров, тестируй эмоции прямо сейчас 🎮📝
▸ Доступность и инклюзивность Люди с нарушениями зрения получают качественную аудиокнигу с правильной интонацией, а не роботизированный набор букв. Социальная ответственность бизнеса в действии ♿️ ⏳⏳⏳⏳⏳⏳⏳⏳ 👩🍼 Это наш ИИ-Продавец 🫢 Маркетплейс ИИ-Менеджеров ▶️ Это наш Ютубчик #голос
В этом посте были ссылки, но мы их удалили по правилам Сетки