Крупная модель выдумала мне клиента
В заявке был только вопрос. Ни названия компании, ни контакта, ни суммы.
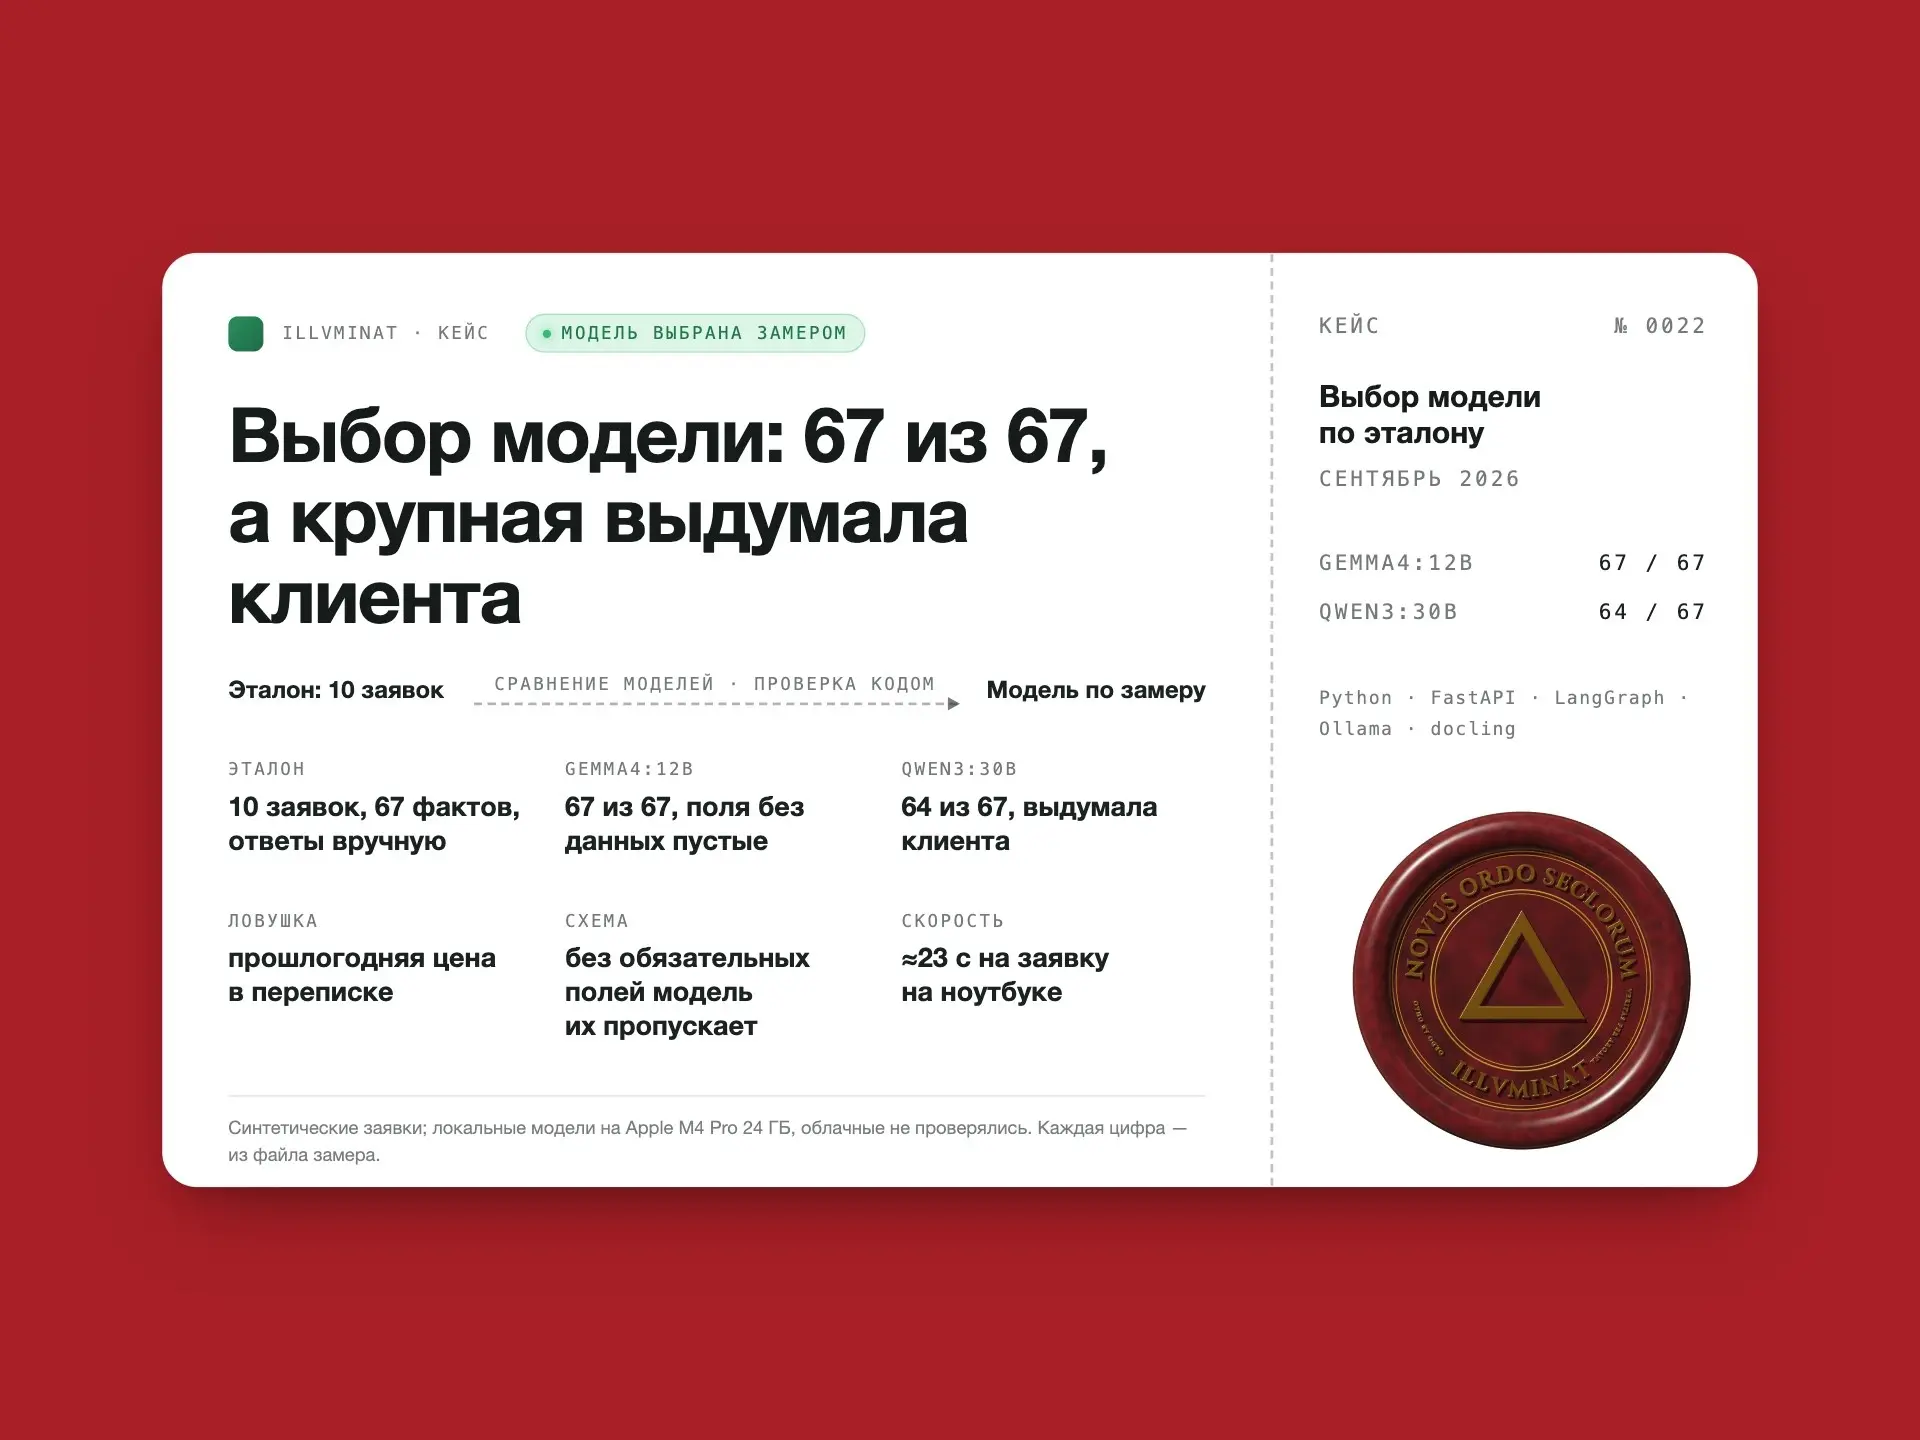
Модель на 30 миллиардов параметров всё равно заполнила поле «контрагент». Модель в два с лишним раза легче оставила его пустым.
Так я выбирал модель для своего ИИ-агента, который разбирает входящие заявки из писем, Word, Excel и сканов.
Выбирал не по рейтингам. Сначала написал эталон: 10 заявок и 67 фактов, ответы — руками, до первого прогона.
В эталон положил ловушки: заявку без данных, прошлогоднюю цену в старом письме, самопоправку «3 млн — нет, 3,5 млн», двух контрагентов в одной заявке.
Итог на десяти заявках: — лёгкая модель: 67 из 67; — крупная: 64 из 67. Взяла прошлогоднюю цену, потеряла почту и выдумала клиента.
Крупная была быстрее — 18 секунд на заявку против 23. Но выдуманный клиент в CRM стоит дороже пяти секунд.
Ещё две находки. Если поля в схеме необязательные, модель их молча пропускает. А распознавание сканов без заданного языка читало «Счёт №» как «Cuët Ne».
Главный вывод: пустое поле лучше правдоподобного. Человек заметит пустое и уточнит, а выдуманное пройдёт дальше.
Данные синтетические, модели локальные.
А вы по чему выбирали модель для своей задачи — по рейтингам или по своим примерам?
#искусственныйинтеллект #ииагенты #нейросети #разработка #автоматизация