
ИИ агент построил мою первую A/B-аналитику
У нас было три варианта нового экрана сканирования ценника. Голосование среди коллег лидера не выявило, и я предложил: пусть решат пользователи. Так обычная Android-задача превратилась в A/B/C-тест.
Экран и все три варианта написал AI-агент, и это оказалось самым простым. A/B-тестов я до этого не проводил.
Моя первая интуиция была такой: чем больше действий хочешь анализировать, тем больше событий отправляешь. Я начал размечать отдельные события на открытие, успех, ошибку, подсказку «поднесите ближе».
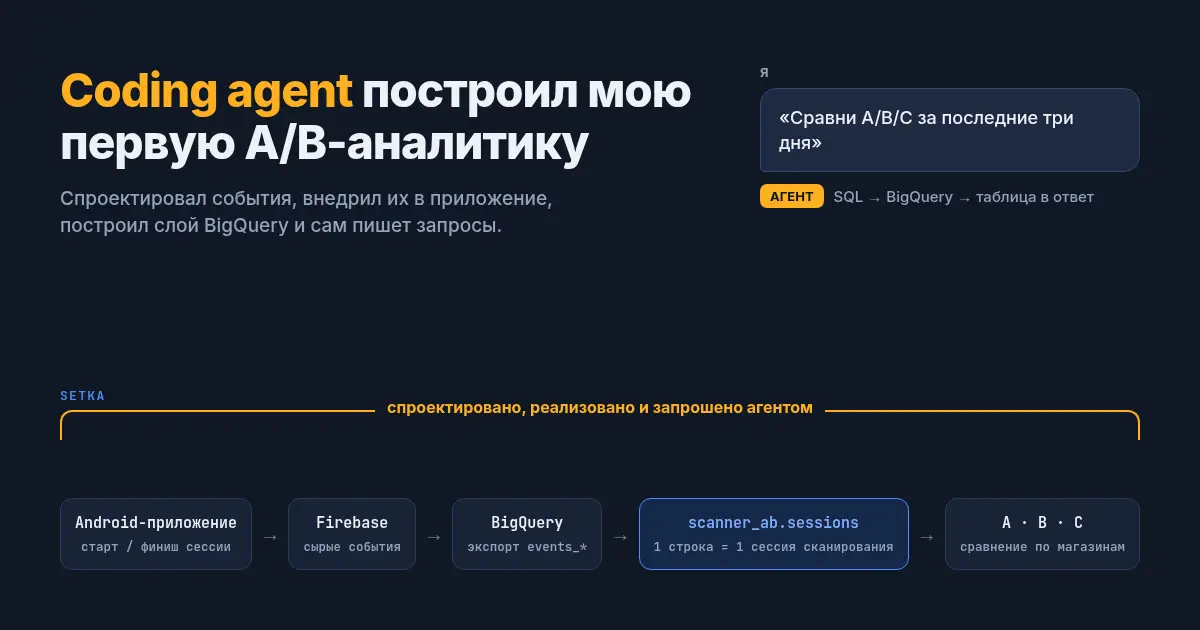
Агент предложил другую модель. Для эксперимента ему понадобились в основном два события: barcode_scan_scanner_session_start и barcode_scan_scanner_session_finish. Зато в них есть всё нужное: session_id, вариант, магазин, устройство, а при завершении — результат, тип кода, длительность, число несовпадений при двойном подтверждении, распознан ли код с первой попытки.
По сути он спроектировал сущность «сессия сканирования». Вопросы стало можно задавать не отдельным кликам, а попытке сканирования целиком. Сам я бы так аналитику не построил.
Дальше та же логика: экспорт Firebase в BigQuery, который агент помог мне настроить, и отдельный слой scanner_ab.sessions, где одна строка равна одной сессии. Теперь я задаю вопросы обычным языком: «сравни A/B/C за три дня», «разложи по моделям планшетов». Агент сам пишет SQL и возвращает таблицу.
Но одну вещь запрос не решает. Вариант у нас назначается магазину, поэтому тысяча сканирований в одном магазине — не тысяча независимых участников. Сравнивать нужно сначала на уровне магазинов. Агент умеет найти это ограничение и построить правильные разрезы, но понимать, какой вывод данные действительно позволяют, должен человек.
Главное, что я вынес: ценность агента не в том, что он пишет SQL. Он сначала спроектировал данные, которые потом сам анализирует.
Весь путь от продуктового вопроса до инженерного вывода разобрал в статье: https://hram.github.io/articles/price-tag-scanner-ab/