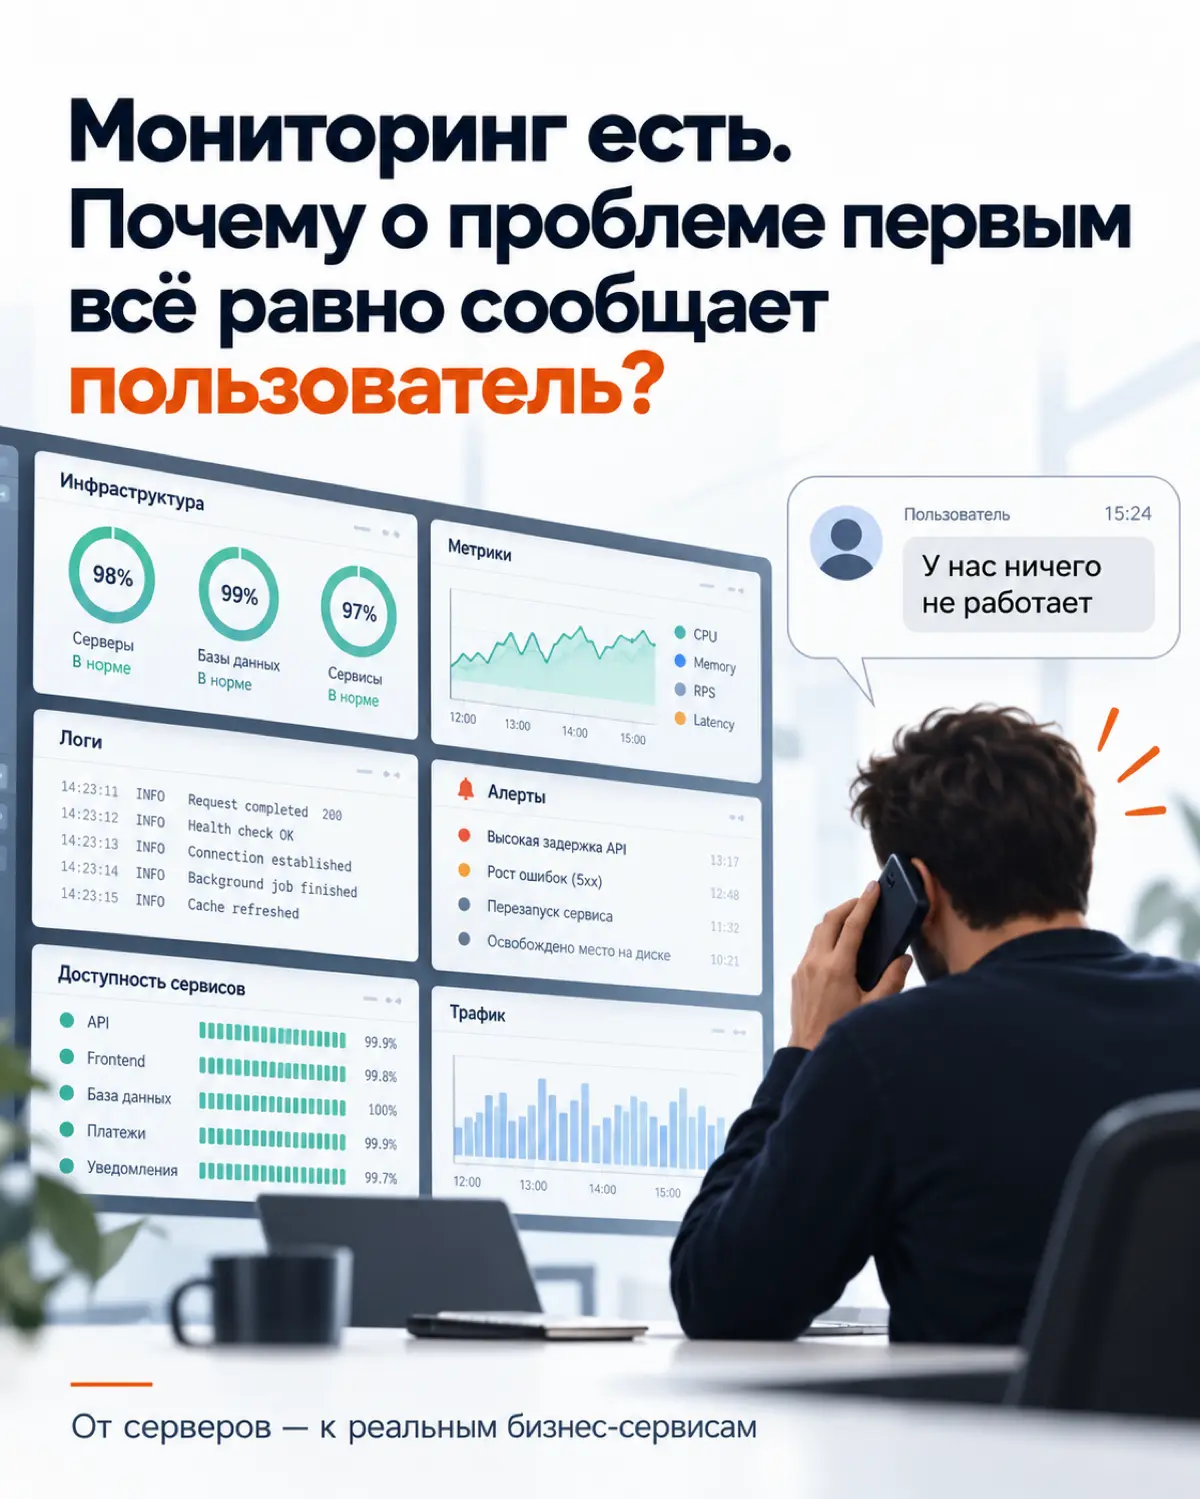
Почему о проблеме первым всё равно сообщает пользователь?
Zabbix работает. Grafana висит на телевизоре. Логи собираются. Алерты приходят. А потом звонок: «У нас ничего не работает».
И начинается поиск.
Самое интересное, что проблема обычно не в отсутствии мониторинга. Наоборот — данных слишком много. CPU. RAM. Диски. Пакеты. Ошибки. Latency. Состояние сервисов. Всё измеряется.
Но пользователю всё равно, что PostgreSQL отвечает, CPU загружен на 34%, а nginx зелёный. У него вопрос проще: Я могу сейчас выполнить свою работу или нет? И вот здесь обычный мониторинг часто заканчивается.
Система может показывать: «всё нормально» при этом: — пользователь не может войти; — заказ не проводится; — файл не открывается; — интеграция зависла; — платёж не проходит. Технически компоненты живы. Бизнес-сервис — нет.
Поэтому я больше смотрю на мониторинг не как на сбор метрик, а как на ответ на три вопроса: Что сломалось? Кого это затронуло? Насколько это критично для бизнеса?
И здесь возникает ещё одна проблема. Когда алертов слишком много — алертов больше нет.
Если инженеру каждый день приходит сотня уведомлений, через некоторое время он начинает воспринимать их как фон. Жёлтое. Красное. Ещё красное. Потом оказывается, что среди сотни сообщений было одно действительно важное.
Поэтому «мы мониторим 10 000 метрик» для меня вообще не показатель зрелости. Гораздо интереснее другой вопрос: Какой процент реальных проблем ИТ обнаруживает раньше пользователя? Вот это уже хорошая метрика.
Потому что зрелый мониторинг — это не когда система знает обо всём. А когда она умеет вовремя сказать: «Здесь проблема. Она уже влияет на пользователей. Смотреть нужно сюда.» И желательно сделать это до первого звонка в техподдержку.
Я полагаю, именно в эту сторону сегодня и должен развиваться корпоративный мониторинг: от контроля серверов — к контролю сервисов;
от тысяч событий — к пониманию влияния;
от “CPU 95%” — к “бизнес-процесс сейчас не работает”.