


Мониторинг не спасает от инцидентов в критических ИС
Все верят в мониторинг. Верят, что если правильно настроить Zabbix, Grafana, Prometheus — инцидентов не будет.
Но в критических ИС это не так. И вот почему.
Что показывает мониторинг Мониторинг показывает состояние железа, серверов, сети. Он умеет отвечать на вопросы: · Сервер жив? — Да/нет. · CPU в норме? — Да/нет. · Пакеты доходят? — Да/нет. · Сервис отвечает? — Да/нет. Это базовый уровень. И он необходим — без него нельзя работать. Но в критических ИС — а это СЭД, ЭДО, МЭДО, КИИ — этого недостаточно. Потому что мониторинг не видит того, что видит пользователь.
Что мониторинг НЕ видит
Пример. СЭД Правительства региона, 20 000 пользователей. Ситуация: пользователи жалуются, что документы не уходят на другой этап после обработки. CPU в норме. Сервер жив. Сеть отвечает. Всё «зелёное». Что произошло на самом деле: сложный документ застопорил очередь на одной из виртуалок. Пока система жует проблемный документ, все другие задачи не обрабатываются.
Мониторинг видит состояние оборудования, но не видит многое другое. Пользователь видит симптом. Мониторинг его не видит. И это — классическая ситуация в критических ИС.
Три слепые зоны мониторинга в критических ИС
Зона 1. Путь пользователя, а не состояние сервера. Мониторинг проверяет: сервер отвечает. Он не проверяет: пользователь по адресу X может загрузить PDF на 15-й секунде работы в системе, через ViPNet, на конкретной версии браузера, с конкретным драйвером ЭЦП. Между сервером и пользователем — десятки узлов: локальная сеть, сеть организации, сеть провайдера, ViPNet-координатор, ViPNet-клиент, межсетевой экран, балансировщик. Мониторинг сервера не увидит проблему на пути к серверу. Зона 2. Юридически значимое действие, а не техническое событие. Мониторинг видит: файл загружен. Он не видит: файл заменён в подписанном ЭЦП документе, и юридическая сила документа уничтожена. Это не техническое событие, это юридическое событие. И мониторинг его не видит по определению — у него нет юридической модели. Зона 3. Стык сфер, а не одна сфера. Мониторинг настроен на одну сферу: сеть, серверы, приложение. Но в критических ИС проблема — на стыке: сеть + ViPNet + приложение + ЭЦП + юриспруденция. Триггер в Zabbix на «CPU > 90%» — бесполезен, если проблема в маршрутизации на конкретном узле. Триггер на «сервис не отвечает» — бесполезен, если проблема в потере пакетов между сервером и конкретным рабочим местом.
Почему так происходит Мониторинг проектируется по функциям. Сетевики настраивают свои триггеры. Администраторы серверов — свои. Разработчики — свои. Каждый видит свой участок. Но проблема в критической ИС — на стыке. И никто не настраивает триггеры на стык, потому что стык — это ничейная зона.
Это ровно та же проблема, что и с ITIL: функциональная модель разрушает систему, потому что проблема на стыке. Мониторинг — часть этой функциональной модели. Он разбит на функции, как и всё остальное.
Что работает вместо «правильных триггеров» Я не против мониторинга. Я против веры, что мониторинг решит проблему.
В критических ИС мониторинг — это один из инструментов, но не главный. Главный — владелец сквозного процесса, который: 1. Видит путь пользователя целиком — от его рабочего места до сервера, через все узлы. 2. Видит юридический контекст — какие действия в системе несут правовые последствия. 3. Умеет соединять симптомы — от пользовательской заявки до корневой причины на уровне инфраструктуры. 4. Имеет полномочия действовать на стыке — не «передать заявку в ЦОД», а сам разобраться. Мониторинг помогает ему. Но не заменяет его.
Что это значит для ИТ-специалиста Если вы настраиваете Zabbix, Grafana, Prometheus — вы делаете важную работу. Но не ждите, что мониторинг увидит всё. Он не увидит: · проблему на конкретном узле между сервером и пользователем; · проблему на стыке сеть + ViPNet + приложение; · проблему, которая проявляется только у пользователя, а не на сервере. Что делать: не ограничивайтесь «правильными триггерами». Стройте карту пути пользователя — от его рабочего места до сервера. И настраивайте мониторинг на этот путь, а не только на сервер.




· 5 ч
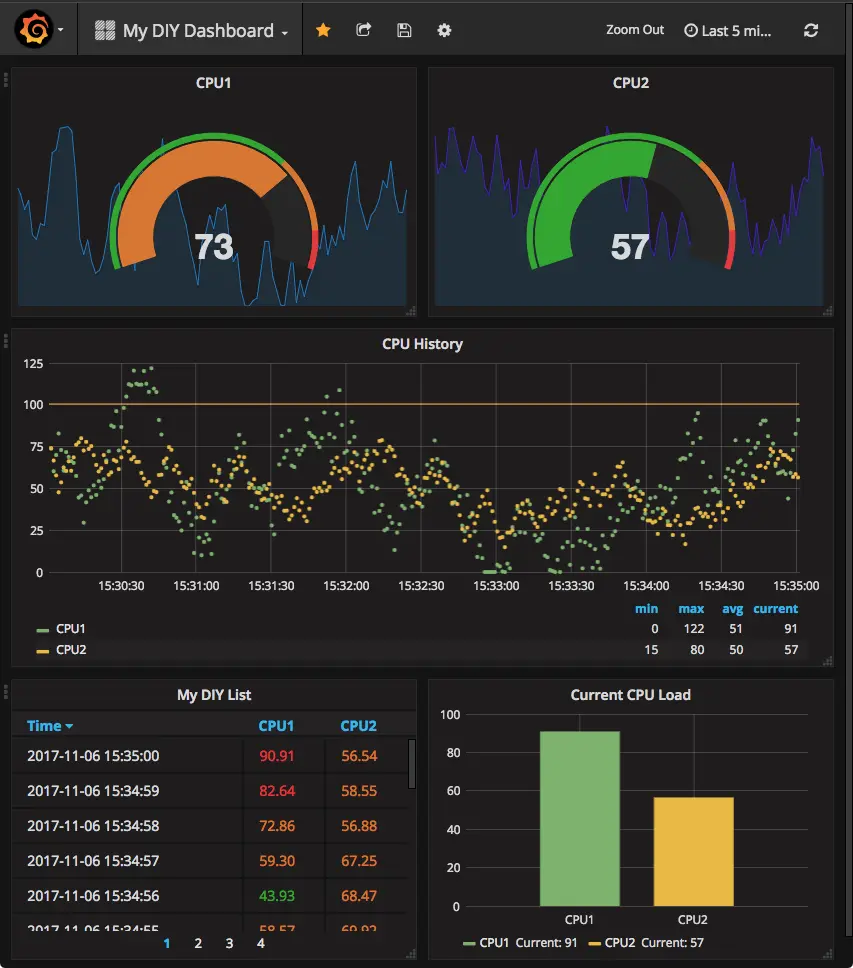
Что-то мало на дашборде информации по загрузке CPU, надо ещё 3-4 панели добавить
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
коммент удалён
· 5 ч
Это рандомный снимок с просторов инета. В моей реальной практике по каждой системе было 20-30 панелей.
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
ответ удалён