Можно ли сравнивать retention без разбивки по когортам?
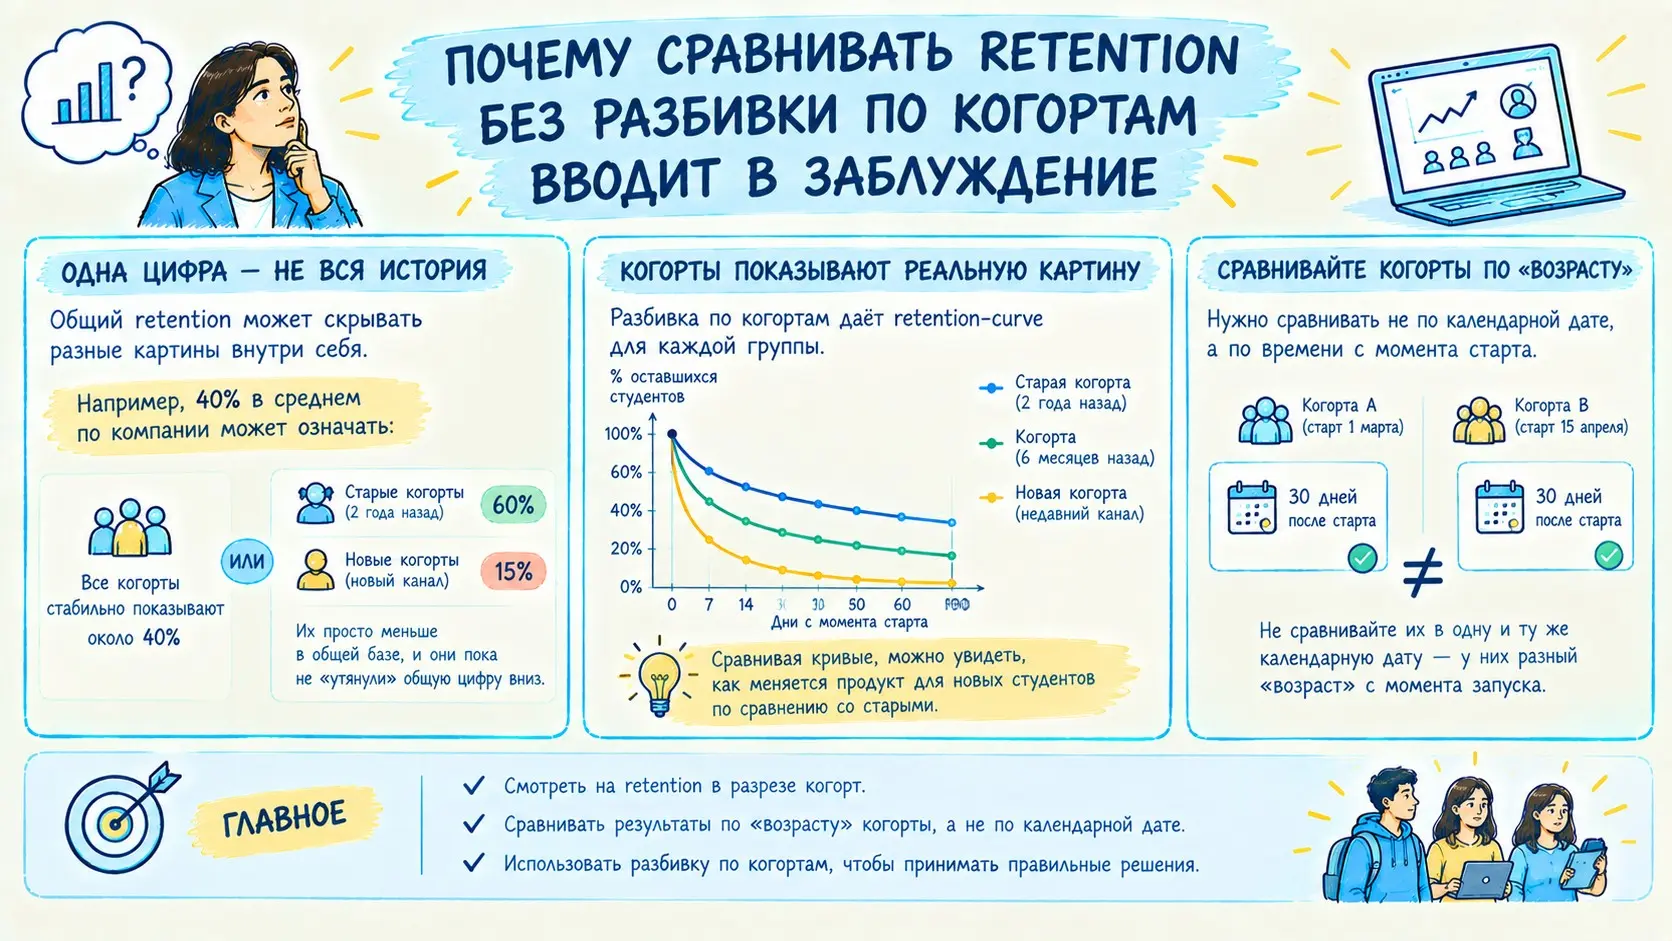
Одна из методологических ошибок при работе с retention — смотреть на общий показатель по всей базе студентов сразу, без сегментации/ без разбивки по когортам (группам, пришедшим в разное время или разными путями). Такой общий показатель может скрывать совершенно разные истории внутри себя.
Пример: если retention в среднем по компании держится на уровне 40%, это может означать, что все когорты стабильно показывают около 40%. А может означать, что старые когорты, набранные два года назад, давно осели на стабильных 60%, а новые когорты, пришедшие через недавно запущенный канал привлечения, показывают всего 15% — и просто ещё не успели «утянуть» общую цифру вниз полностью, потому что их пока меньше в общей базе.
Разбивка по когортам решает эту проблему: вместо одной усреднённой цифры вы получаете retention curve для каждой группы — как процент оставшихся студентов меняется со временем с момента их старта. Сравнивая эти кривые между собой, можно увидеть, улучшается или ухудшается продукт для новых студентов по сравнению со старыми, что усреднённая цифра в принципе показать не способна.
Отдельно стоит сравнивать когорты не по календарной дате, а по «возрасту» — retention когорты через 30 дней после старта нужно сравнивать с retention другой когорты тоже через 30 дней после её старта, а не в одну и ту же календарную дату, когда у них разный «возраст» с момента запуска.