Что я делал на хакатоне МТТЕХ(ч.1)
Недавно принимал участие с командой в хакатоне от МТТЕХ, где мы разрабатывали систему раннего прогнозирования изменений графика движения городского транспорта - это был невероятный спринт. Моя зона ответственности — backend и frontend. Изначально казалось, что задача довольно простая: получить данные о транспорте, передать их модели и показать результат. Но когда начал разбираться в архитектуре, стало понятно, что самое интересное находится между этими точками.
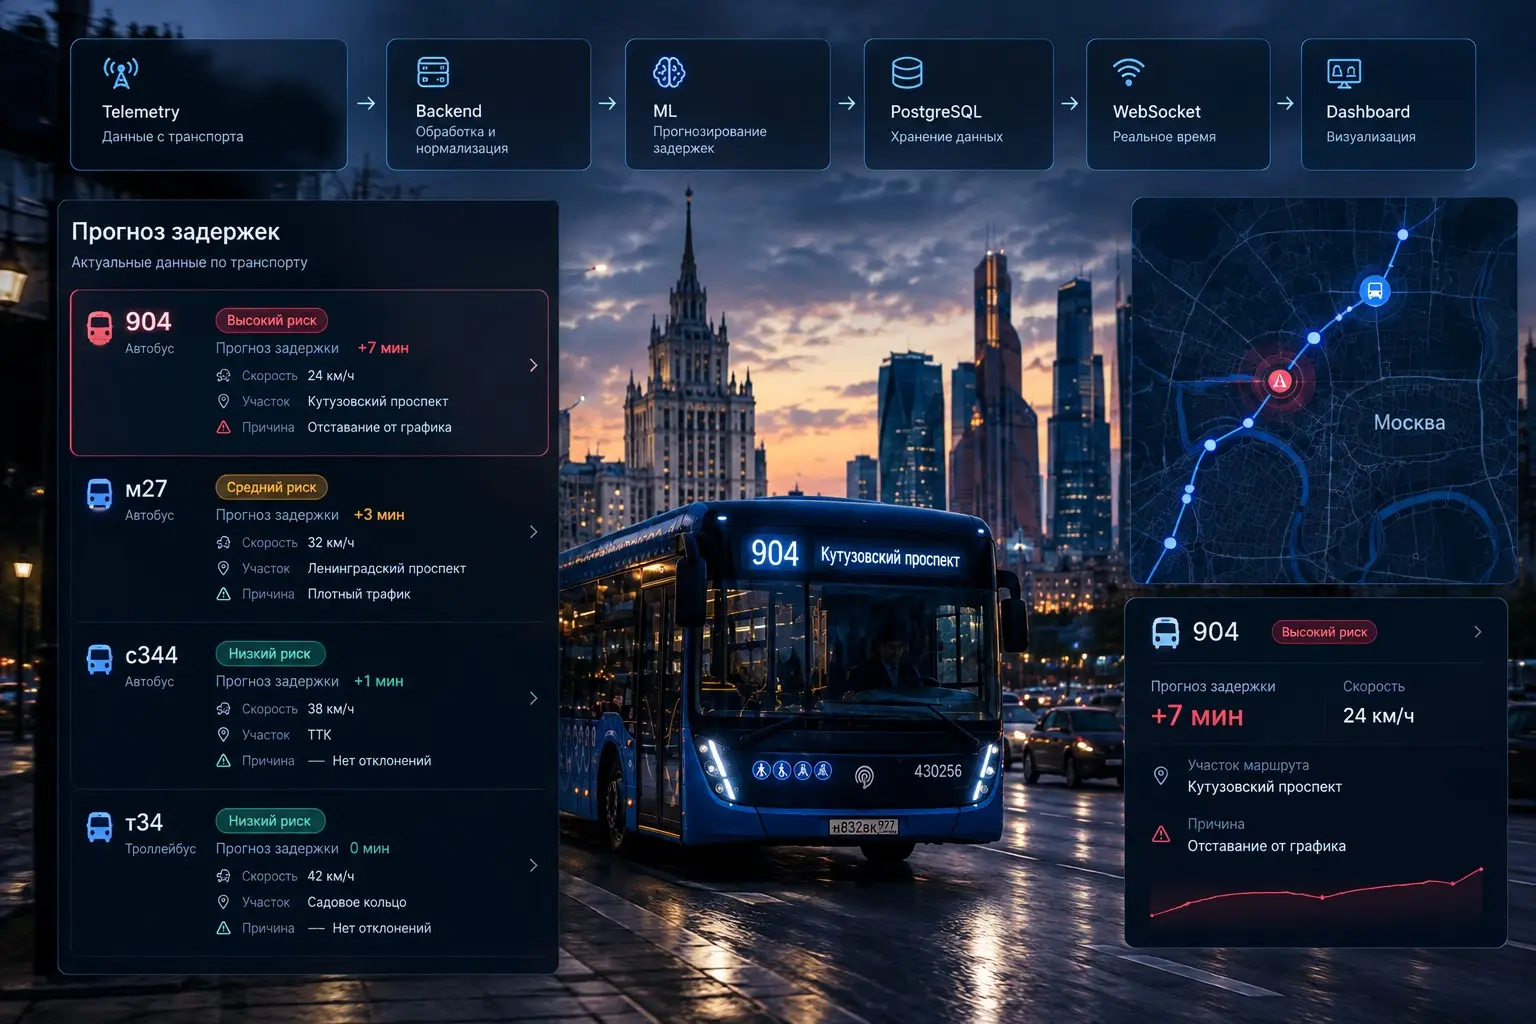
Сейчас общий поток выглядит примерно так: телеметрия → Backend → ML → PostgreSQL → WebSocket → Dashboard Backend получает поток телематических данных от транспорта, разбирает его и формирует актуальное состояние конкретного транспортного средства. Дальше это состояние нужно сопоставить с расписанием и сформировать контекст, который передаётся ML-сервису. ML в нашем случае решает задачу регрессии — прогнозирует задержку транспорта. Качество модели оценивается по MAE относительно фактической задержки.
Со стороны backend при этом появляется довольно много задач: — принимать и обрабатывать поток телеметрии; — хранить историю состояний; — сопоставлять транспорт с расписанием; — формировать данные для ML-инференса; — взаимодействовать с ML-сервисом через API; — сохранять результаты прогнозирования; — передавать актуальные данные на frontend в real-time через WebSocket.
И вот здесь я как раз понял, что мне в backend интереснее всего. Не просто: «Написать endpoint, который возвращает JSON». А разобраться, как данные проходят через всю систему, где формируется состояние, кто за что отвечает, где могут появиться проблемы и как сделать так, чтобы все компоненты нормально взаимодействовали друг с другом. Сейчас проект закончен, постепенно буду рассказывать здесь о том, с какими техническими задачами мы столкнулись и какие решения принимали. Для меня это хороший опыт именно потому, что приходится смотреть на backend не как на отдельный сервис, а как на часть end-to-end системы.