Мы победили в кейс-чемпионате по автоматизации процессов 🏆
…и почему спустя 1,5 года я считаю, что наше решение было дилетантским 😅
В 2025 году Газстройпром проводил кейс-чемпионат, и одним из направлений было «Автоматизация процессов и аналитика данных». Делюсь, как мы решали задачу и что я поняла с высоты сегодняшнего опыта 👇
📌 Дано Техническая документация IT-подразделения компании.
🎯 Задача Разработать ИИ-агента, который поможет оптимизировать работу отделов внутри подразделения.
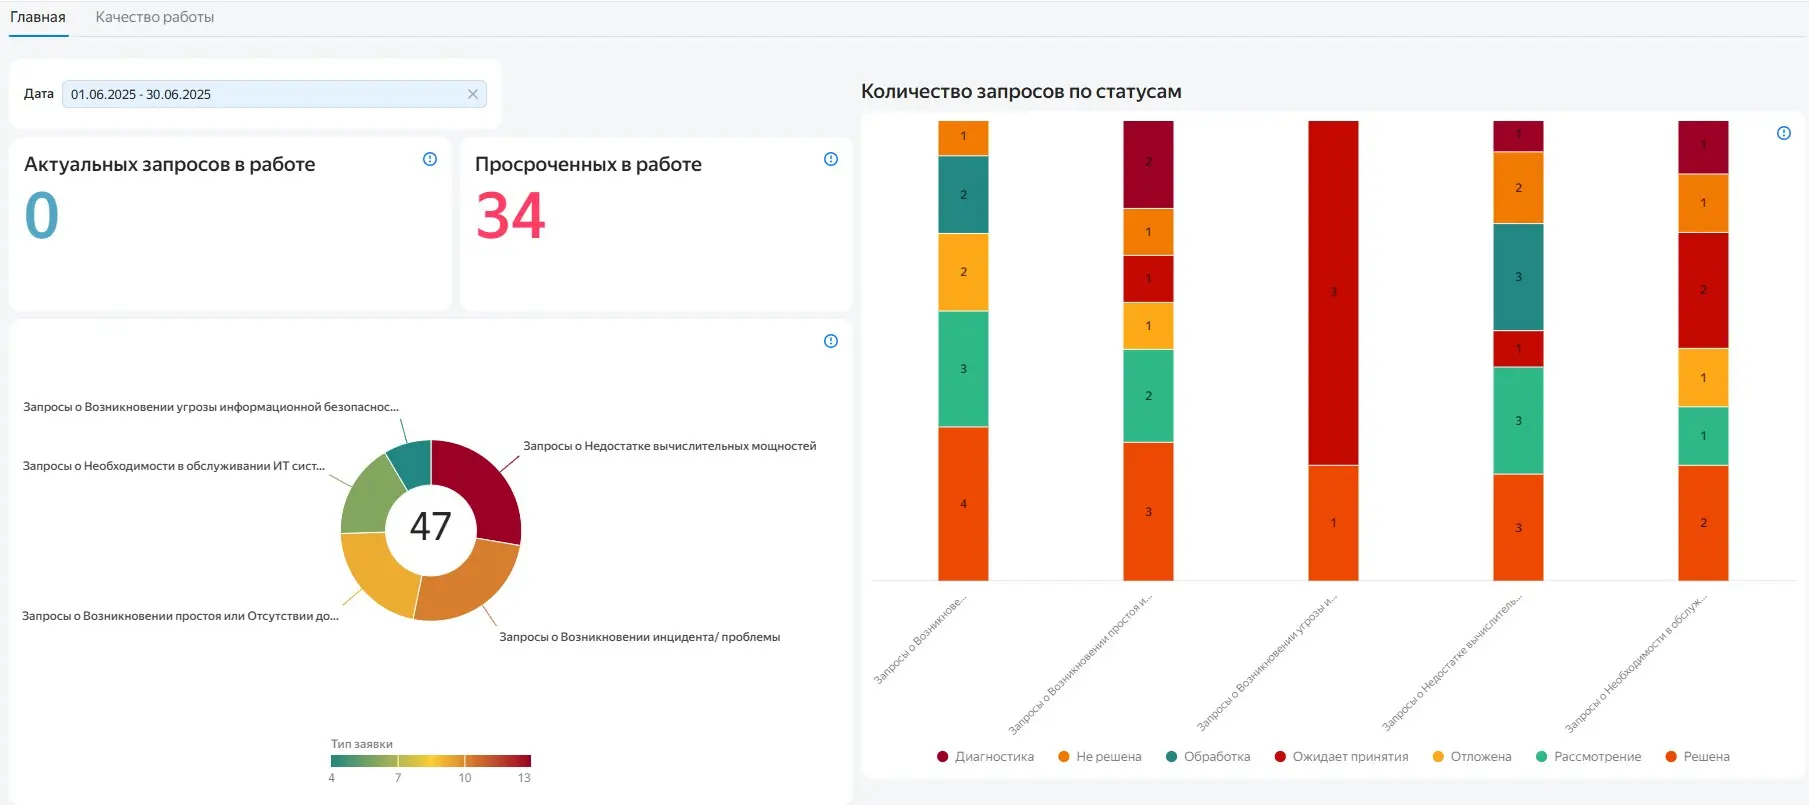
🛠 Что мы сделали 1. Вычленили из документов, как работает каждый отдел и как отделы взаимодействуют друг с другом. 2. Построили BPMN-подобные схемы. 3. Разобрали ситуацию «as is» - нашли узкие места и циклы, предложили способы их устранения и определили, где именно ИИ может помочь. 4. Разработали ИИ-агента, который: 🔗 собирает статусы запросов напрямую из Jira; 📝 в новых заявках по ключевым словам проверяет выбранный для работы отдел - перенаправляет в нужный при необходимости 🔍 ищет дубли среди заявок 📊 выводит их в динамический дашборд (демо я собрала в DataLens, BI-системе от Яндекса); 🚨 находит «зависшие» запросы, где время ожидания ответа было близко к максимуму по SLA, и автоматически отправляет алерт ответственному
🏁 Итог На защите мы показали, что такой подход реально оптимизирует работу. Маршрутизация заявок ИИ ускоряет их решение. Динамический дашборд даёт руководителям прозрачность: видно количество заявок, скорость их обработки, загрузку отделов и места, где запросы застревают чаще всего. Решения можно принимать по данным, а не «по ощущениям». Жюри оценило, и мы победили 🎉
🤔 А теперь давайте честно Спустя время я вижу, что мы продумали общую логику ИИ-агента, но не рабочую систему, которую можно внедрять: 1. Алерты по SLA - это не ИИ. Это стандартное правило «если прошло N часов, отправь уведомление», и оно решается настройкой автоматизации в самой Jira. Настоящий ИИ-слой был бы в прогнозе, считывающем более сложное сочетание факторов: предсказывать, какая заявка вот-вот нарушит SLA, по типу, сложности и загрузке исполнителя. 2. Процессы мы брали из документации, а не из реальности. Документация описывает, как должно быть, а не как есть. Сегодня я бы применила process mining на логах Jira и увидела бы реальные маршруты заявок, петли и возвраты. 3. Не было метрик качества. Мы не замерили baseline и не могли посчитать, на сколько процентов сократится время обработки. Наш вывод «оптимизирует» держался на логике, а не на цифрах. 4. Дашборд. Очень красочный и очень нечитаемый. Много ненужной информации, мелкий шрифт и другие огрехи - надо было исходить из цепочки “какие решения надо принимать -> какая информация для этого нужна”, а наш вариант получился обратный. Тут отдельно хотелось бы извиниться перед BI-разработчиками, которые увидели этот кошмар :')
💡 Вывод: победа в кейсе - это про умение структурировать проблему и убедительно презентовать решение. А про реальную ценность ИИ в процессах я поняла гораздо больше уже после чемпионата. Этим и делюсь 🙂