Вышла лаба от @rzv_de про CDC конвейер из PostgreSQL через Debezium и Kafka Connect в S3!
Как и на других его стендах, доступ к инфраструктуре, UI и материалам в одном окне браузера. Алексей построил лабу по сценарию "что может сломаться в интеграции и как это чинить". После тренировки сможете более уверенно внедрять и обслуживать change data capture интеграции на работе.
Какой опыт получите в процессе
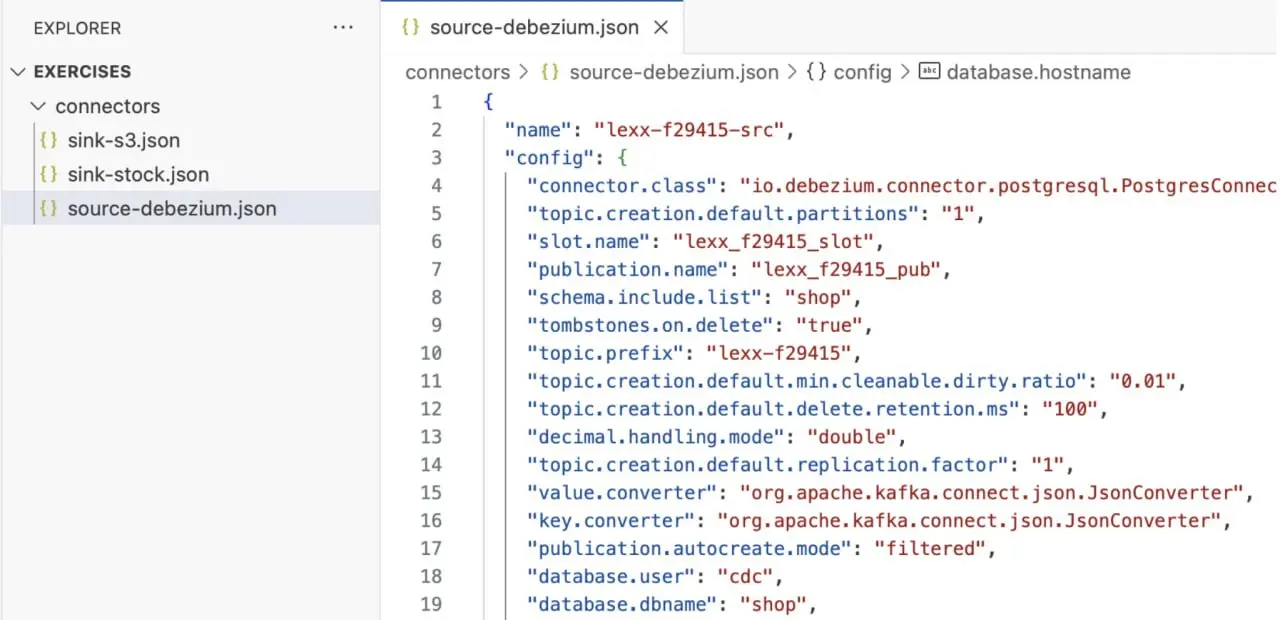
- Составите конфиг коннекторов, в которых на опыте поймёте, зачем нужна каждая строчка
- Зарегистрируете source- и sink-коннекторы через REST API Kafka Connect
- Пройдёте первичную загрузку 20 000 заказов и перейдёте к живому потоку данных с операциями I/U/D
- В процессе несколько раз обновите конфиг коннектора, проследите за результатом изменений "на живую"
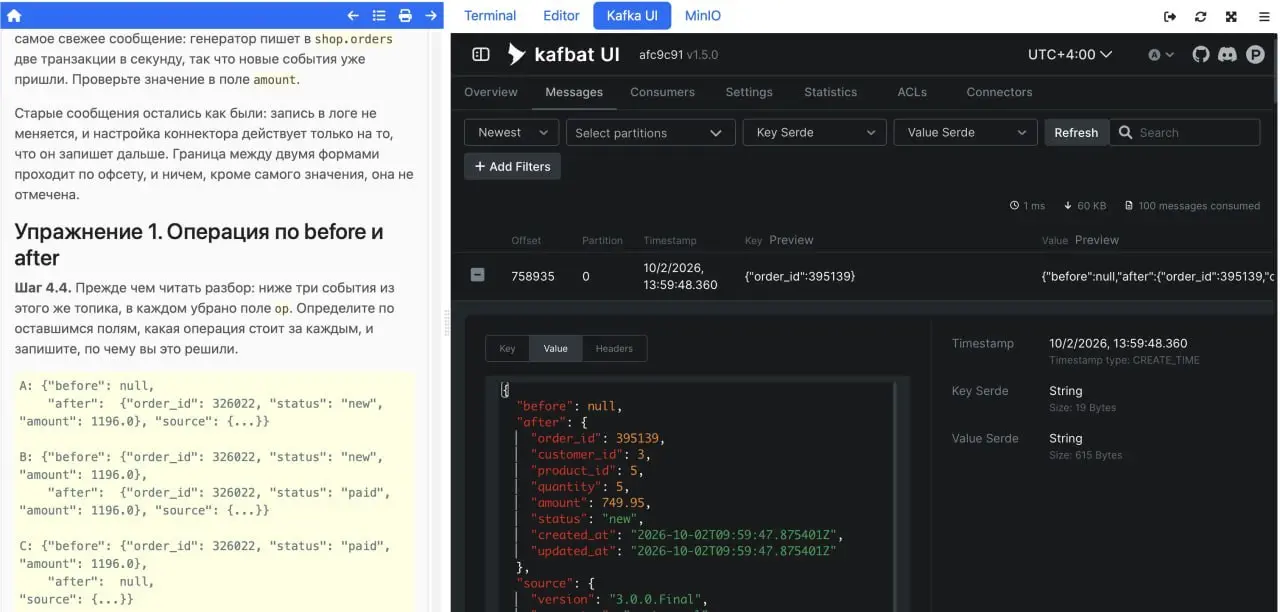
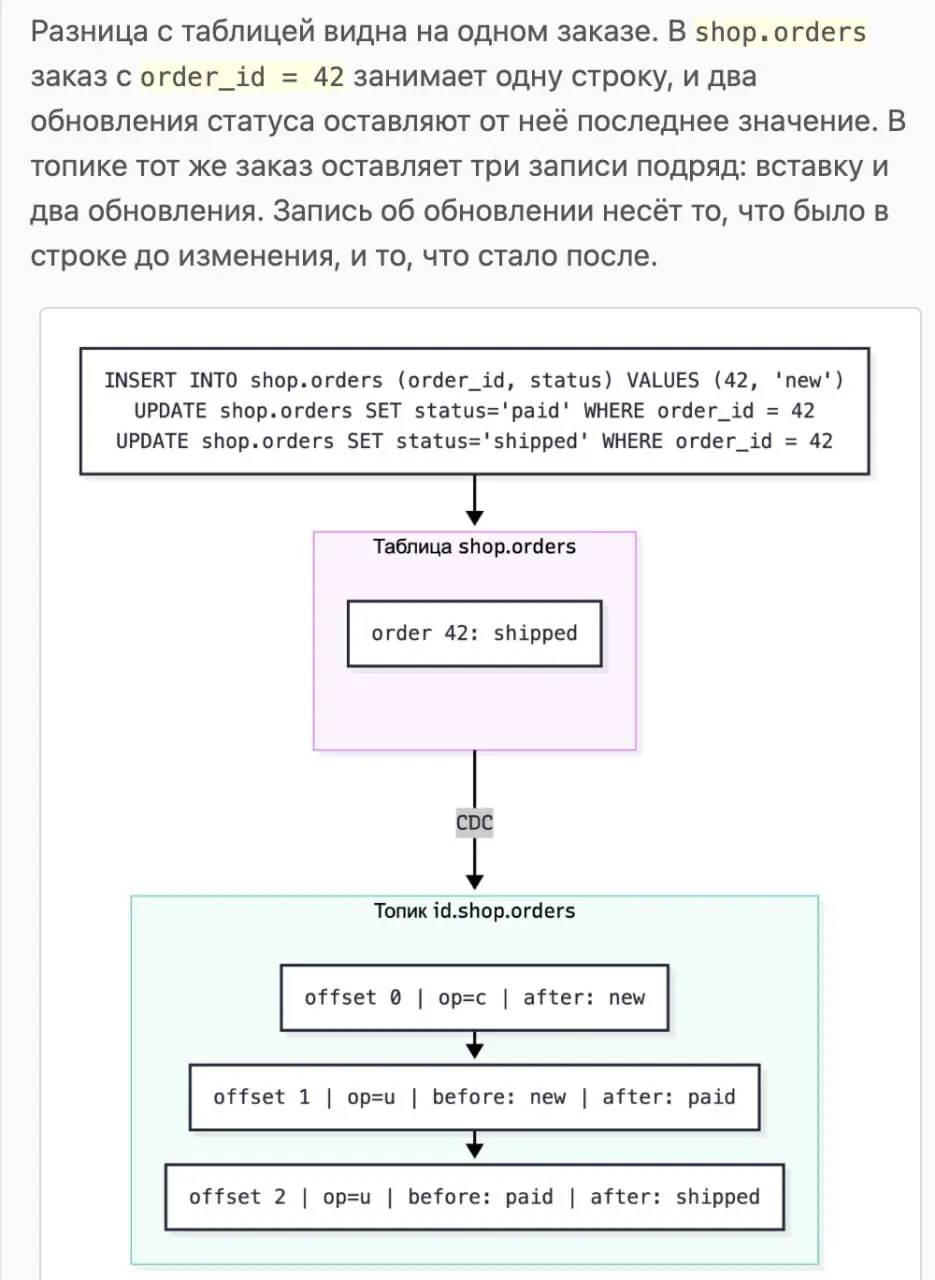
- Научитесь ориентироваться в формате сообщений внутри топика
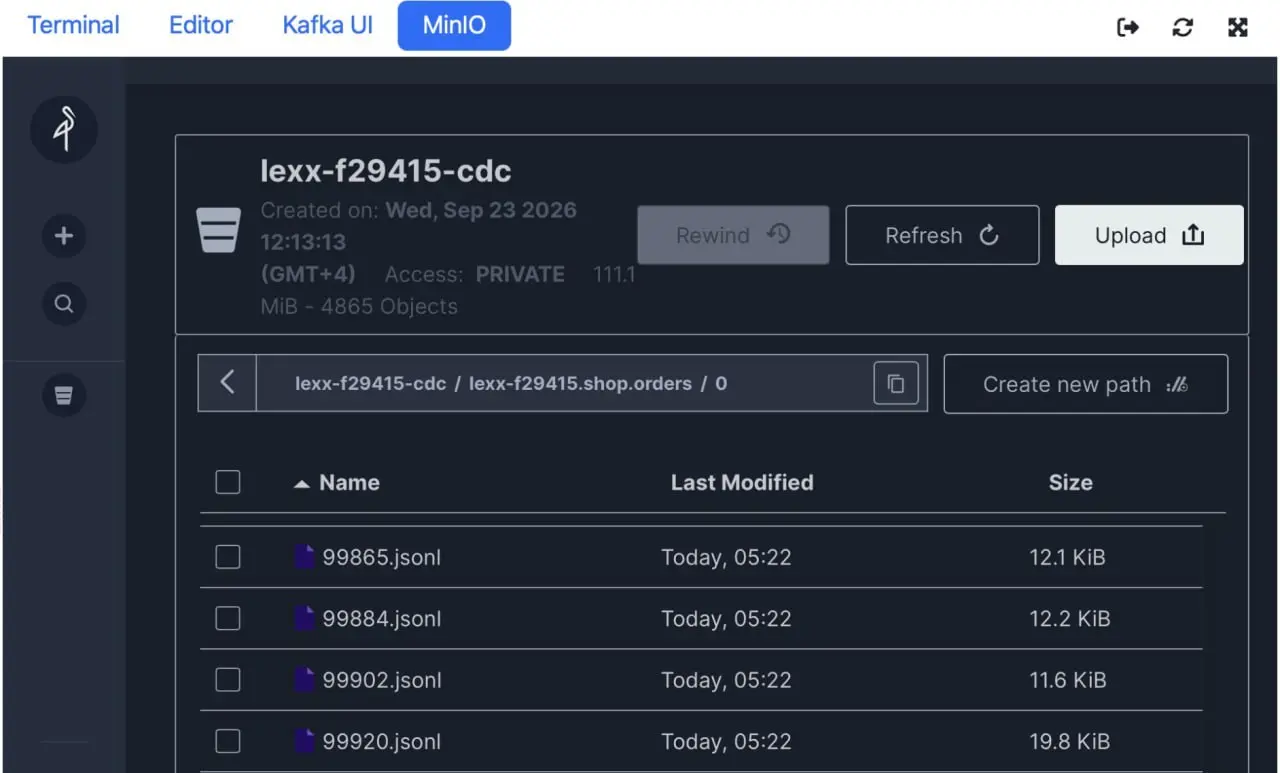
- Попереключаете живой поток на разные форматы выгрузки в S3, JSONL и Parquet
- Научитесь управлять объёмом и количеством файлов на выходе
- Проследите, что и как сломается при остановке и удалении различных частей интеграции
- Научитесь чинить эти поломки
У каждого участника своя выделенная инфраструктура, экспериментируйте свободно! В конце вас ждёт сводная таблица с рекомендациями по диагностике и решению частых проблем.
Кому подойдёт Нужен базовый SQL и опыт с СУБД, например Postgres. Опыт с Kafka не обязателен, есть необходимый минимум теории. Лаба пригодится, если на работе предстоит внедрять CDC, собираетесь переходить на проект с такой интеграцией. Или интересно разобраться, что за зверь этот CDC такой 😁
Прохождение займёт от 4 до 6 часов, доступ открыт 30 дней, материалы останутся в PDF.
p.s. Ещё там есть лабы по Lakehouse (Iceberg, Trino, S3) и разбор ошибок при переходе на шардированный ClickHouse. Рекомендую для подготовки к работе с современным стеком!