Тесты зелёные. Почему сломанный код всё равно проходит?
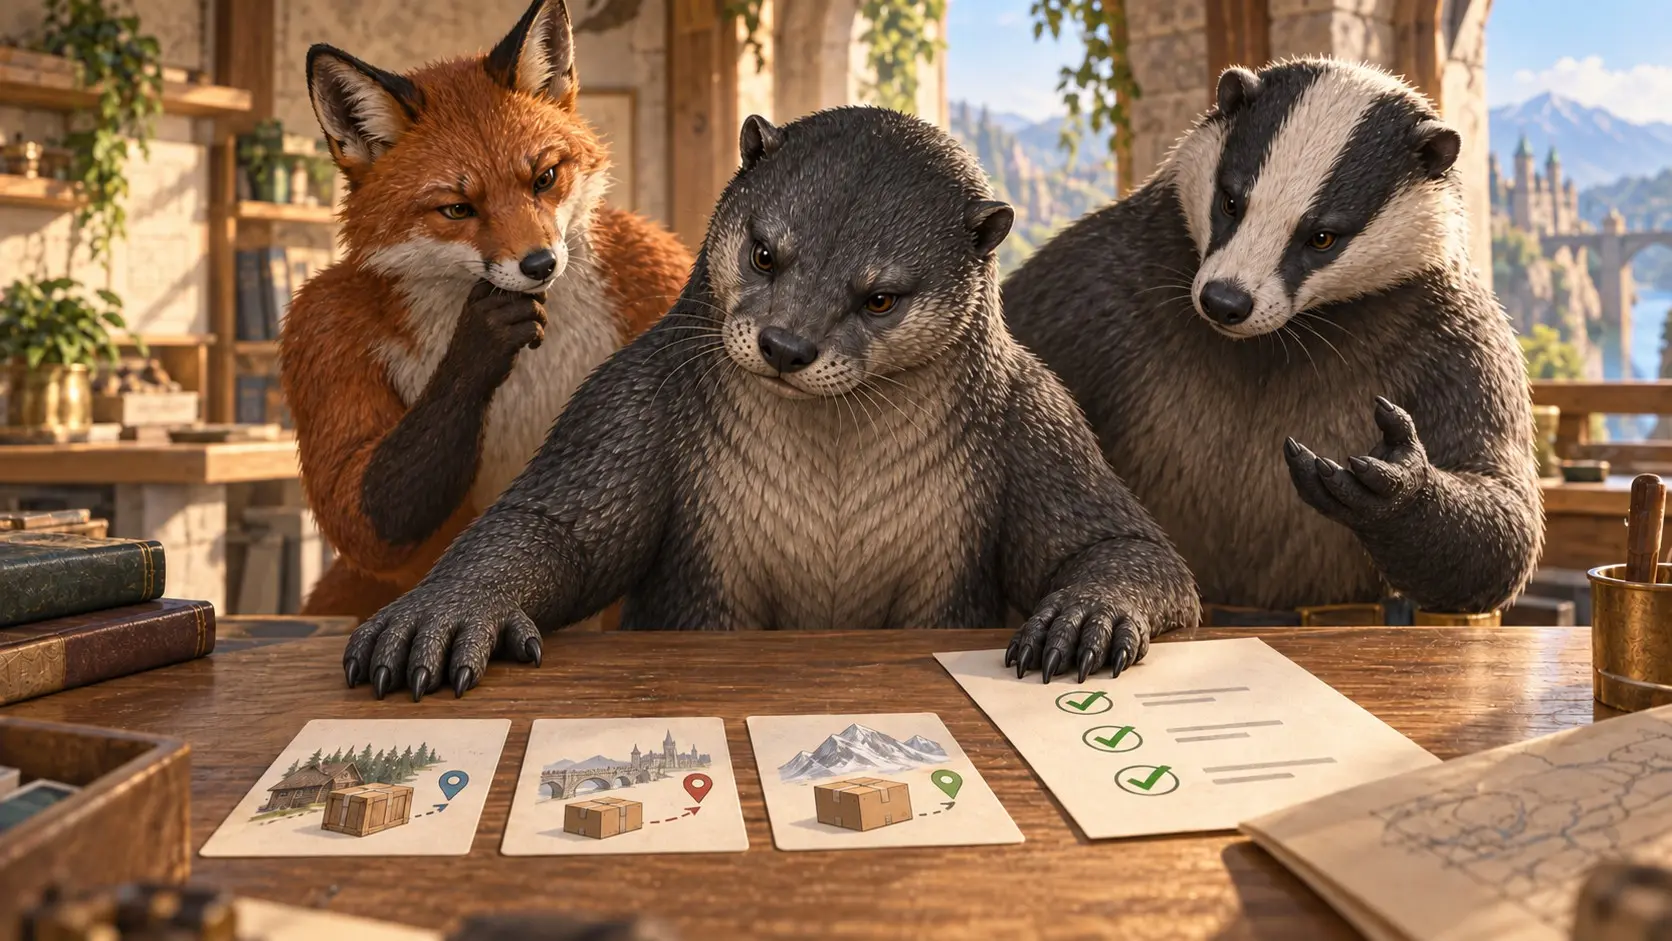
В приложении пункты выдачи должны показываться от ближайшего к дальнему. После изменения сортировки первым оказался самый дальний. Тесты при этом прошли: подходящие пункты в результате есть, закрытые отсеяны, количество соблюдено.
Знакомая ситуация для ревью. Проверка существует, вызывает нужную функцию и перечисляет ожидаемые значения. Но одно из её утверждений использует `unorderedEquals([‘near’, ‘far’])`. Оно проверяет состав и совершенно не интересуется порядком. Функция возвращает `[‘far’, ‘near’]` — утверждение остаётся истинным. Второй тест проверяет `hasLength(2)`: два самых дальних пункта имеют ту же длину списка, что и два ближайших.
Оба теста делают полезную работу. Первый замечает лишний закрытый пункт. Второй — превышение лимита. Проблема возникает, когда их зелёный результат принимают за проверку ещё одного обязательства: «ближайшие первыми». Это обязательство осталось только в описании функции.
Для ArkTelos Lab такой случай собран в небольшом Dart-опыте. У пункта есть расстояние, признак приёма заказов и количество свободных мест. Функция оставляет подходящие записи в пределах радиуса, сортирует их и берёт первые `limit`. Расстояния уже известны; сеть и бронирование здесь не проверяются.
Усиленный тест подаёт три подходящих пункта на 900, 200 и 500 метрах и ожидает `[‘near’, ‘middle’, ‘far’]`; при лимите 2 — `[‘near’, ‘middle’]`. После обратной сортировки тест падает. Ожидание записано из требования, без второй сортировки внутри самого теста.
Тот же вопрос проявился ещё в двух местах. Замена `distanceMeters <= maxDistanceMeters` на `<` прошла исходные тесты: ни одного пункта ровно на границе радиуса там не было. Пример с 4999, 5000 и 5001 метром показал разницу. Удаление `freeSlots > 0` тоже прошло: исходные записи всегда имели свободные места. Пункт с нулём мест заставил новую проверку заметить лишнюю запись.
В матрице из пяти намеренных поведенческих дефектов шесть исходных тестов нашли **2**, двенадцать усиленных — **5**. Покрытие исследуемой функции у обоих наборов одинаковое: **13 из 13 исполняемых строк**. Строка может выполниться, а её результат — остаться без нужного утверждения.
Этот приём называют мутационным тестированием: небольшое изменение кода показывает, на какое нарушение реагируют существующие проверки. Но считать каждое выжившее изменение ошибкой тестов нельзя. Для целого числа `freeSlots > 0` и `freeSlots >= 1` дают один ответ; тест не должен их различать. Синтаксическая ошибка вообще не дала тестам запуститься — это отдельный отказ, а не победа утверждений.
При ревью полезно взять конкретный `expect` и спросить: **какое неисправное поведение всё ещё пройдёт через него?** Для `hasLength(2)` ответ — выбор двух самых дальних. Дальше уже можно решить, требуется ли порядок по продуктовой договорённости и каким входом его проверить. Если порядок не важен, строгое сравнение списка лишь создаст ложное требование.
Пять выбранных дефектов не представляют все ошибки продукта. Опыт не проверял актуальность свободных мест, интерфейс, резервирование и конкурентные заказы. Он показывает границу между выполнением кода и проверкой того результата, ради которого этот код нужен человеку.
Полный разбор с кодом и результатами — в ArkTelos Lab. Исходники опыта позволят повторить изменения. Об экосистеме — ArkTelos. Каналы: Lab RU | Lab EN | ArkTelos RU | ArkTelos EN.