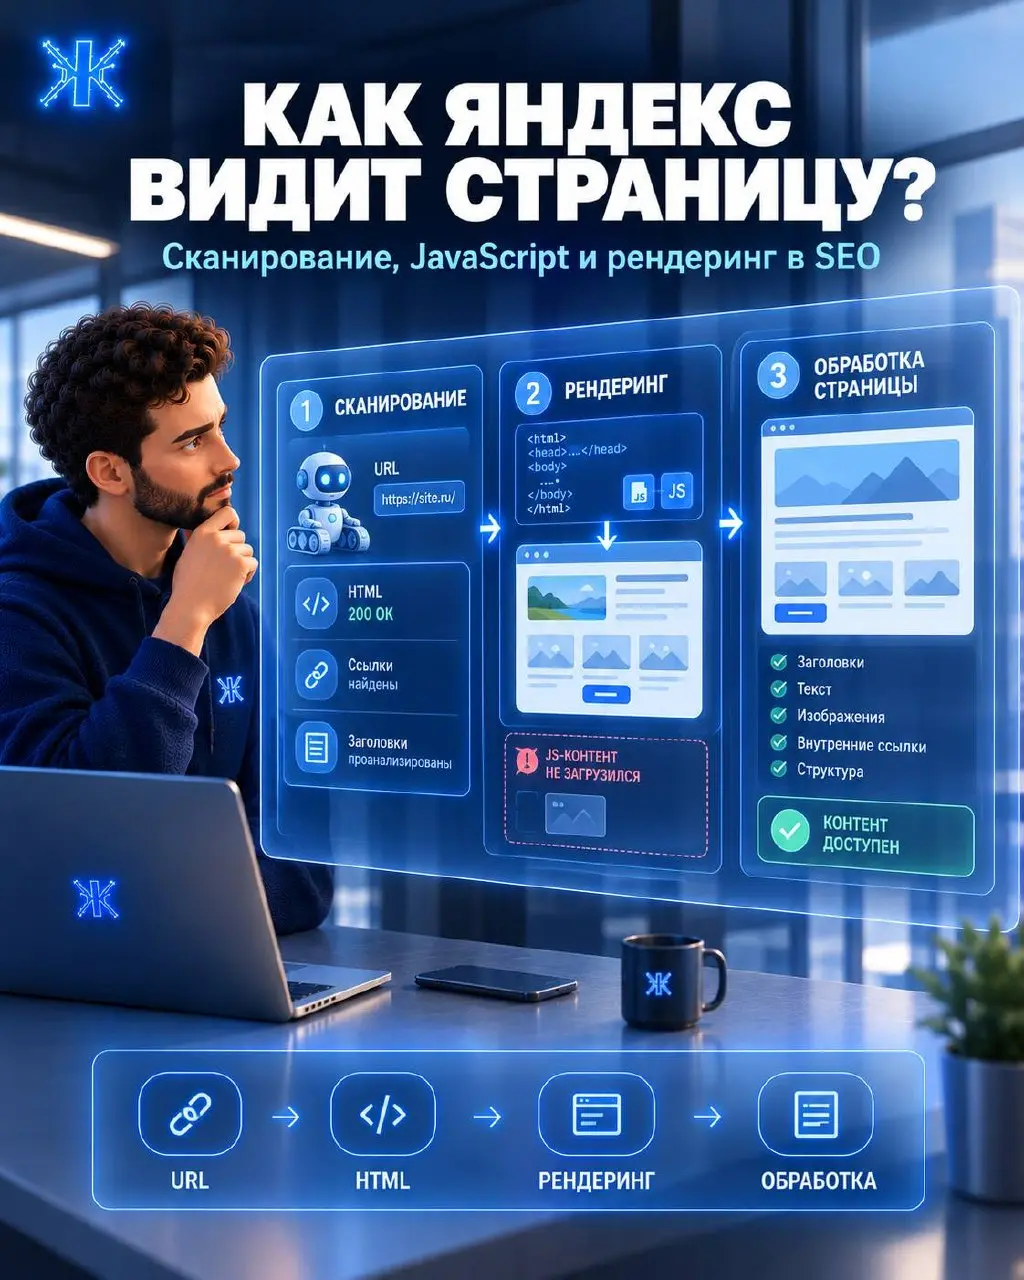
⚡️⚡️⚡️Яндекс может найти страницу, но это ещё не значит, что он увидел её так же, как пользователь.
В SEO важно понимать разницу между сканированием, обработкой HTML и рендерингом JavaScript. Особенно если сайт построен на React, Vue, Angular или использует динамическую подгрузку контента. Разберём, как поисковый робот проходит путь от URL до понимания страницы.
1. Сначала Яндекс узнаёт об URL Поисковик получает адрес страницы из разных источников: • внутренние ссылки сайта; • XML Sitemap; • ссылки с других ресурсов; • ранее известные URL; • другие доступные сигналы обнаружения страниц. Но наличие URL в Sitemap не гарантирует, что страница будет просканирована или попадёт в поиск.
2. Робот проверяет, можно ли сканировать страницу Перед загрузкой содержимого учитываются технические ограничения. Например: • правила robots.txt; • доступность сервера; • HTTP-статус; • редиректы; • ограничения по частоте обращений. Если страница закрыта от сканирования, робот может не получить её содержимое. Важно: robots.txt и noindex решают разные задачи. Robots.txt ограничивает сканирование, а noindex указывает поисковику не включать страницу в индекс, если робот смог прочитать эту директиву.
3. Яндекс получает HTML После обращения к URL робот получает ответ сервера. Для обычной HTML-страницы в исходном коде уже могут находиться: • текст; • заголовки H1-H3; • ссылки; • метатеги; • изображения; • структурированные данные; • основной контент. Если всё важное присутствует в HTML, поисковику проще обнаружить и обработать содержимое. Но что происходит, если страница почти пустая, а контент появляется только после выполнения JavaScript? Тут начинается следующий этап.
4. Рендеринг JavaScript Представим интернет-магазин. В исходном HTML есть только контейнер:
А карточки товаров, заголовки, описания и ссылки формируются JavaScript-кодом. Чтобы увидеть итоговое содержимое, поисковику требуется обработать страницу с выполнением необходимых скриптов. Это и есть рендеринг. Упрощённо: HTML + CSS + JavaScript → итоговое содержимое страницы. И здесь могут возникнуть проблемы: • скрипт не загрузился; • API вернул ошибку; • контент появляется только после действия пользователя; • ссылки создаются некорректно; • важный текст не попал в итоговый DOM; • сервер или сторонний сервис работает нестабильно. В результате пользователь видит полноценную страницу, а поисковый робот может получить неполное представление о ней.
5. После обработки поисковик оценивает содержимое Когда содержимое доступно, Яндекс может анализировать: • тематику и смысл страницы; • основной текст; • заголовки; • внутренние ссылки; • изображения и их атрибуты; • дубли и канонические URL; • технические и другие сигналы качества. Но важно не путать этапы. Сканирование не равно индексации, а индексация не гарантирует высоких позиций. Страница может успешно открываться роботом, но не попасть в поиск или не получать видимость по целевым запросам. Практический пример Допустим, у вас страница услуги: site.ru/seo-prodvizhenie/ Пользователь открывает её и видит: • H1 «SEO-продвижение сайта»; • описание услуги; • преимущества; • стоимость; • форму заявки.
💎Как проверить страницу В Яндекс Вебмастере используйте инструменты проверки URL и диагностики, чтобы изучить доступность страницы и возможные проблемы. Дополнительно проверьте: 1. HTTP-статус и цепочку редиректов. 2. robots.txt и meta robots. 3. Исходный HTML. 4. Итоговый DOM после выполнения JavaScript. 5. Наличие H1, основного текста и внутренних ссылок. 6. Загрузку ресурсов и ответы API. 7. Корректность canonical. 8. Доступность важных страниц через внутреннюю перелинковку. Особенно внимательно проверяйте страницы, которые формируют органический трафик и продажи.
#ЖизньвТрафике #SEO #SEOПродвижение #SEOДляБизнеса #Яндекс #ЯндексВебмастер #ТехническоеSEO #JavaScriptSEO #Индексация #СканированиеСайта #Рендеринг #DigitalMarketing #ИнтернетМаркетинг #Аналитика #ОрганическийТрафик #ПоисковыйТрафик