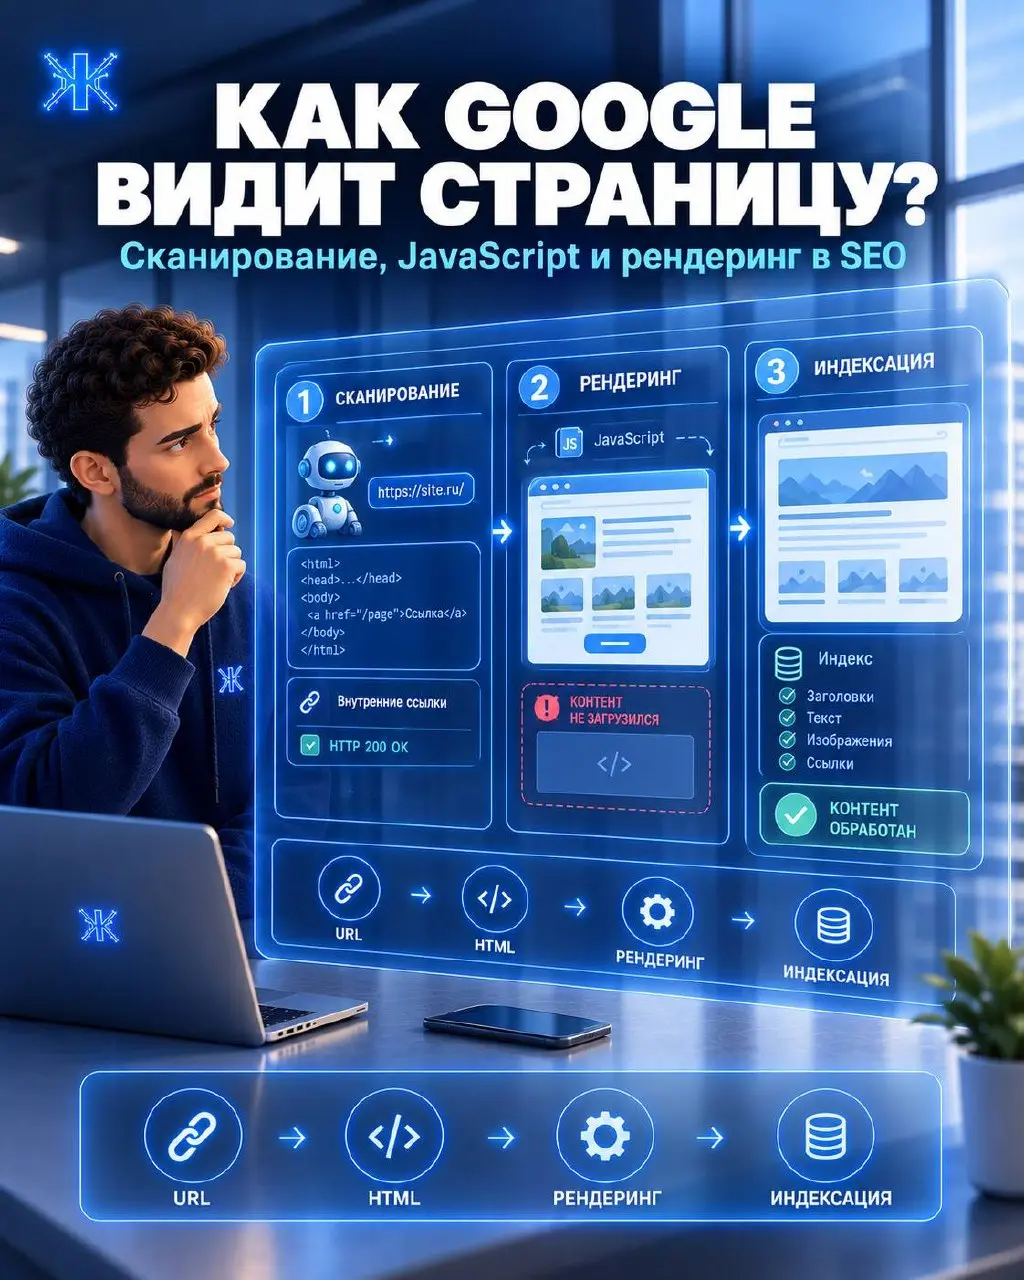
⚡️⚡️⚡️Google может обнаружить страницу, просканировать её, финалим тему индексации
Особенно если сайт активно использует JavaScript, динамическую подгрузку данных и сложную клиентскую архитектуру. Для SEO важно понимать, что Googlebot не просто открывает URL и мгновенно добавляет страницу в поиск. Между обнаружением страницы и её возможным появлением в выдаче есть несколько этапов. Разберём процесс на понятном примере.
1. Обнаружение URL Google узнаёт, что страница существует. Основные источники: • внутренние ссылки; • XML Sitemap; • внешние ссылки; • ранее обнаруженные URL. Например, интернет-магазин создал новую категорию «Ноутбуки для работы». Если на неё ведёт ссылка из каталога, Google может обнаружить URL при обходе сайта. Sitemap тоже помогает находить страницы, но не гарантирует их сканирование или индексацию.
2. Сканирование Googlebot После обнаружения URL Googlebot может обратиться к странице и получить HTTP-ответ. На этом этапе имеют значение: • код ответа сервера; • robots.txt; • редиректы; • доступность сервера; • ограничения частоты запросов; • размер и стабильность ответа.
3. Первичная обработка HTML Представим, что Google получил HTML страницы. Если в исходном коде уже присутствуют: • H1; • основной текст; • ссылки на товары; • метатеги; • изображения; • структурированные данные, то важное содержимое доступно на раннем этапе обработки. Но если исходный HTML содержит только пустой контейнер приложения, ситуация меняется. Например:
А весь контент появляется после выполнения JavaScript. Тогда требуется рендеринг.
4. Рендеринг JavaScript Google использует инфраструктуру рендеринга на базе Chromium, чтобы обрабатывать JavaScript и получать итоговое содержимое страницы. Упрощённо процесс выглядит так: HTML → загрузка ресурсов → выполнение JavaScript → итоговый DOM. На этом этапе могут возникнуть проблемы: • скрипты недоступны; • API возвращает ошибку; • важный контент загружается только после пользовательского действия; • ссылки формируются некорректно; • элементы не появляются в итоговом DOM; • ресурсы блокируются или работают нестабильно. В результате пользователь видит полноценную страницу, а Google может получить неполное содержимое.
5. Обработка и решение об индексации После получения содержимого Google анализирует страницу и оценивает, может ли она быть включена в индекс. Учитываются различные сигналы: • содержание и тематика; • доступность и качество контента; • canonical; • дубли; • внутренние ссылки; • технические ограничения; • другие сигналы поисковой системы. И здесь важно разделять три понятия: Обнаружена ≠ просканирована ≠ проиндексирована. Даже если Googlebot успешно загрузил страницу и отрендерил JavaScript, это не гарантирует её появления в поиске или высоких позиций. Практический пример Допустим, у вас страница услуги: site.ru/seo-prodvizhenie/ Пользователь видит: • H1 «SEO-продвижение сайта»; • описание услуги; • преимущества; • стоимость; • форму заявки. Но часть текста и ссылок появляется только после выполнения JavaScript.
Для диагностики используйте URL Inspection в Google Search Console и тестирование страницы в Google Rich Results Test, если проверяете поддерживаемую разметку. Как улучшить доступность контента для Google• Размещайте критически важный текст в HTML, когда это возможно. • Используйте обычные ссылки с корректными href. • Не делайте важный контент доступным исключительно после клика или другого действия. • Проверяйте ответы API и загрузку ресурсов. • Следите за статусами страниц и редиректами. • Проверяйте отрендеренную версию, а не только исходный код. • Не закрывайте важные ресурсы от робота без необходимости.
#ЖизньвТрафике #SEO #SEOПродвижение #SEOДляБизнеса #Google #Googlebot #GoogleSearchConsole #ТехническоеSEO #JavaScriptSEO #Индексация #СканированиеСайта #Рендеринг #DigitalMarketing #ИнтернетМаркетинг #Аналитика #ОрганическийТрафик #ПоисковыйТрафик