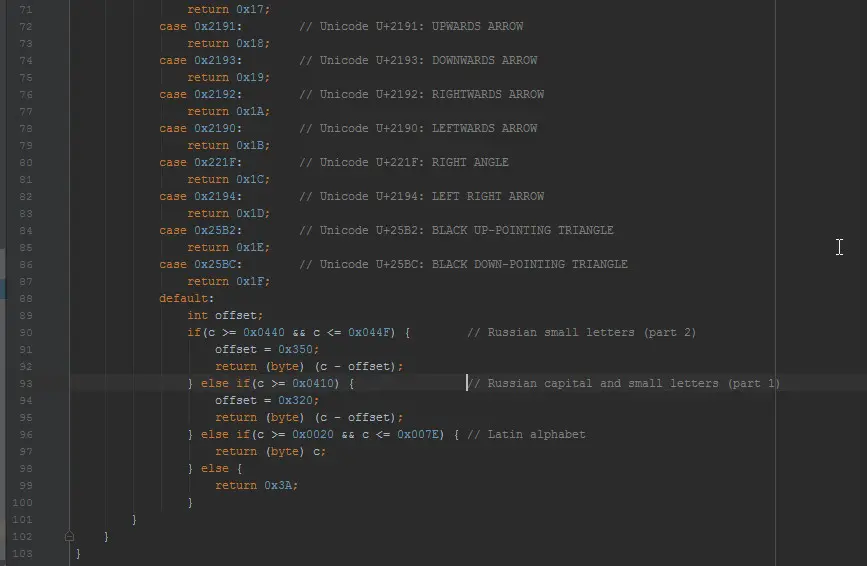
Примерно вот так состоит конвертация символов из кодировки UTF-16, что используется в Java по умолчанию, в CP866.
Конструкция сделана из свичей, где сперва идут колебания значений из таблицы псевдографических символов для Юникода, а затем линейное сравнение с русским и латинским алфавитами на Юникоде при помощи блока if else.
В CP866 часть русского алфавита была поделена на две части - одна часть содержит диапазон чисел от 0x80 до 0xAF и в нем умещаются все заглавные буквы и строчные буквы от “а” до “п”, а другая часть имеет диапазон чисел от 0xE0 до 0xEF и оставшиеся буквы от “р” до “я”.
Заглавные и строчные буквы “ё” были вынесены отдельно, после строчной буквы “я”.
Именно так устроена кодировка с поддержкой русского языка в DOS-подобных операционных системах.