


🔍 Как превратить векторный поиск в часть распределённой базы данных?
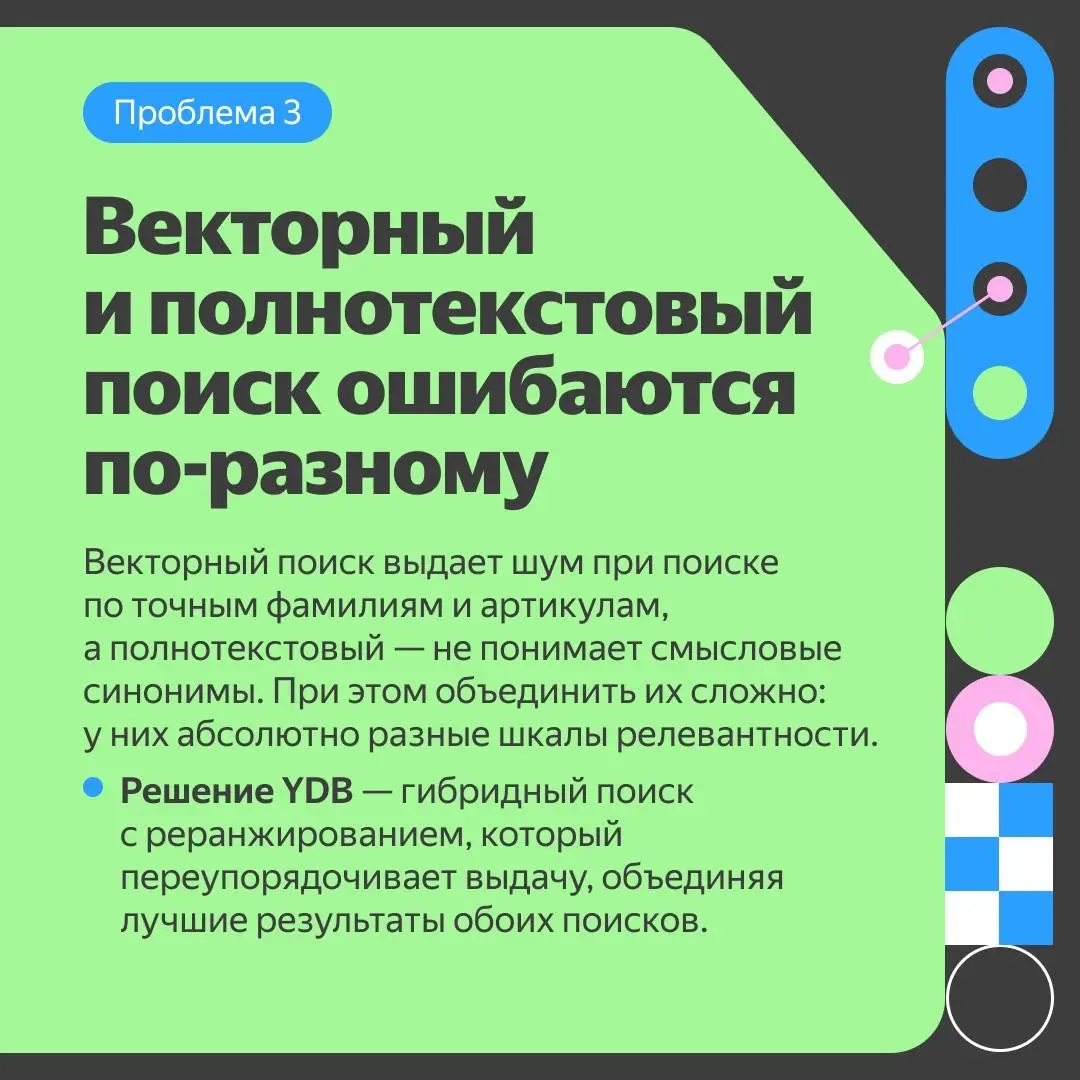
Мы внедрили гибридный поиск в YDB — и стали первой СУБД в России, в которой он работает в распределённой архитектуре. Гибридный поиск объединяет два подхода: поиск по ключевым словам и поиск по смыслу. Это позволяет находить не только точные совпадения, но и документы, близкие по смыслу к запросу.
А дальше начинается самое интересное: как заставить такой поиск работать на тысячах узлов, переживать обновления, внезапный рост нагрузки, и при этом не ломать транзакции?
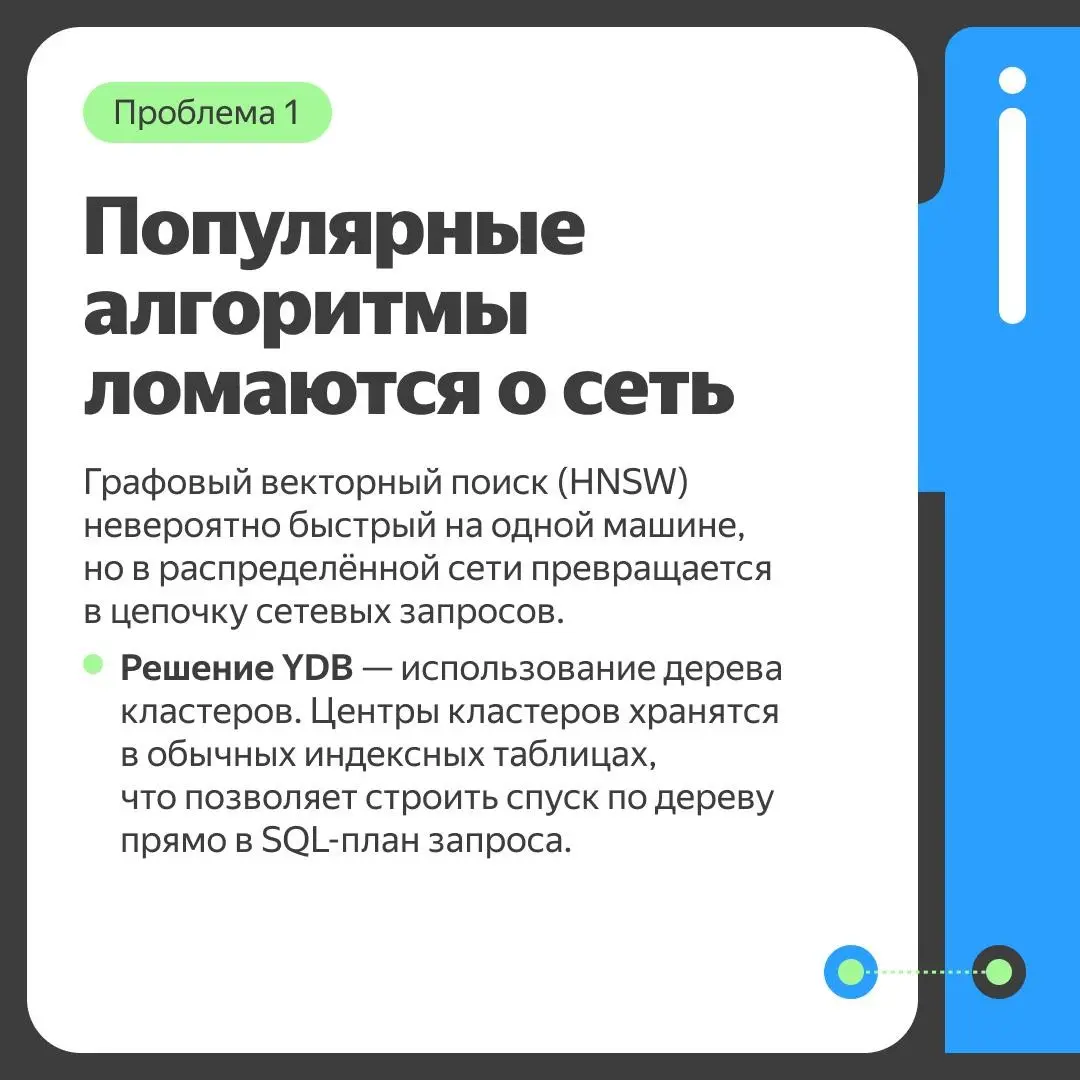
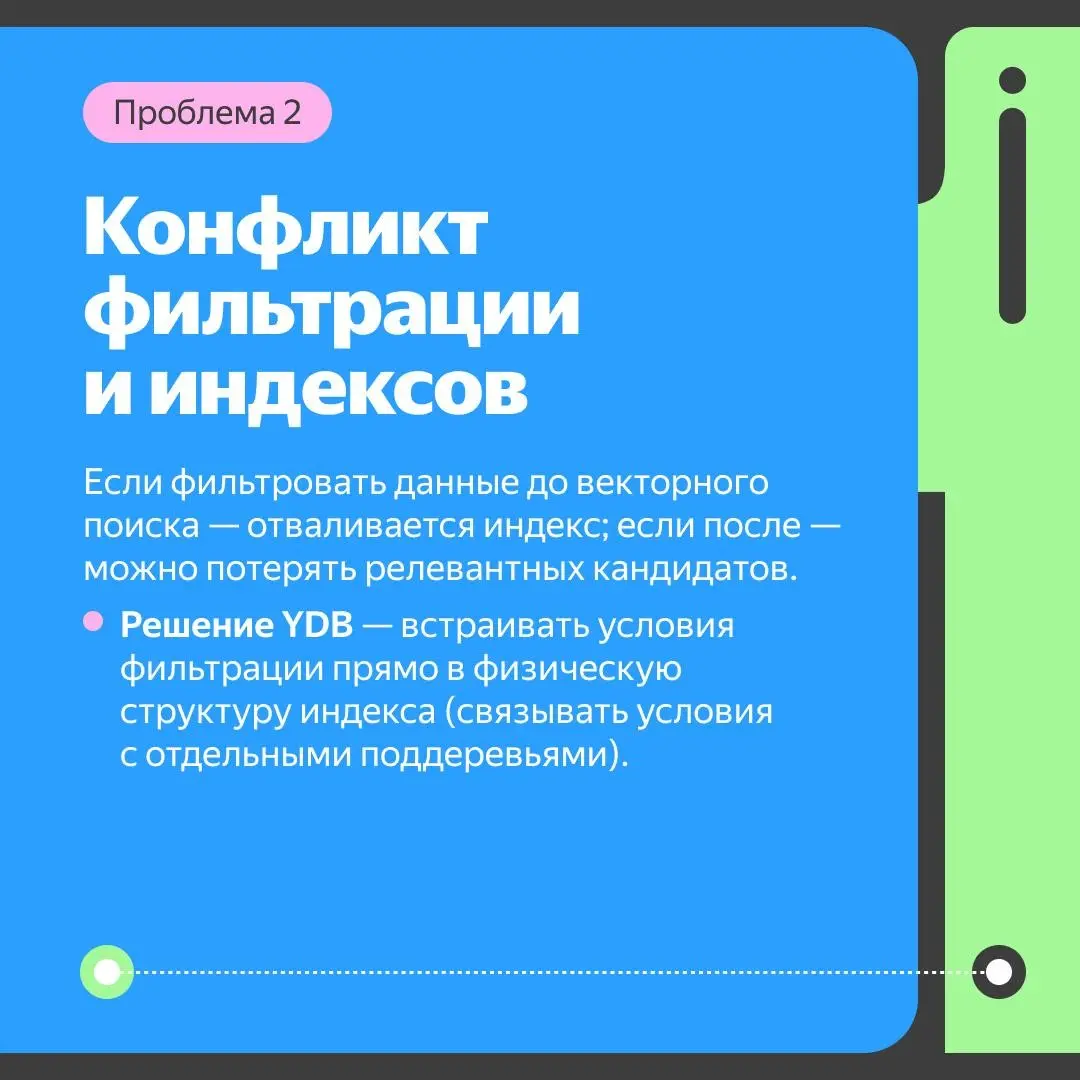
Привет! На связи Александр Зевайкин, руководитель службы разработки, я разобрал три ключевые инженерные проблемы, с которыми мы столкнулись при внедрении поиска, и показал наши архитектурные решения.
➡️ Полный разбор архитектуры, компромиссов и работы алгоритмов читайте в статье или смотрите в докладе.
















· 13 ч
Отличный и понятный разбор. Проблема объединения точного поиска по цифрам и смыслового поиска по текстам сейчас действительно актуальна. Здорово, что теперь база данных умеет делать это сама, без необходимости писать сложный код на бэкенде.
В субботу на хакатоне мы с командой как раз использовали этот serverless-шаблон Яндекса для создания ИИ-маршрутов по музею. Система отработала отлично и выдала стабильный результат, несмотря на жесткий дедлайн. Спасибо за подробное описание технологии!
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
коммент удалён