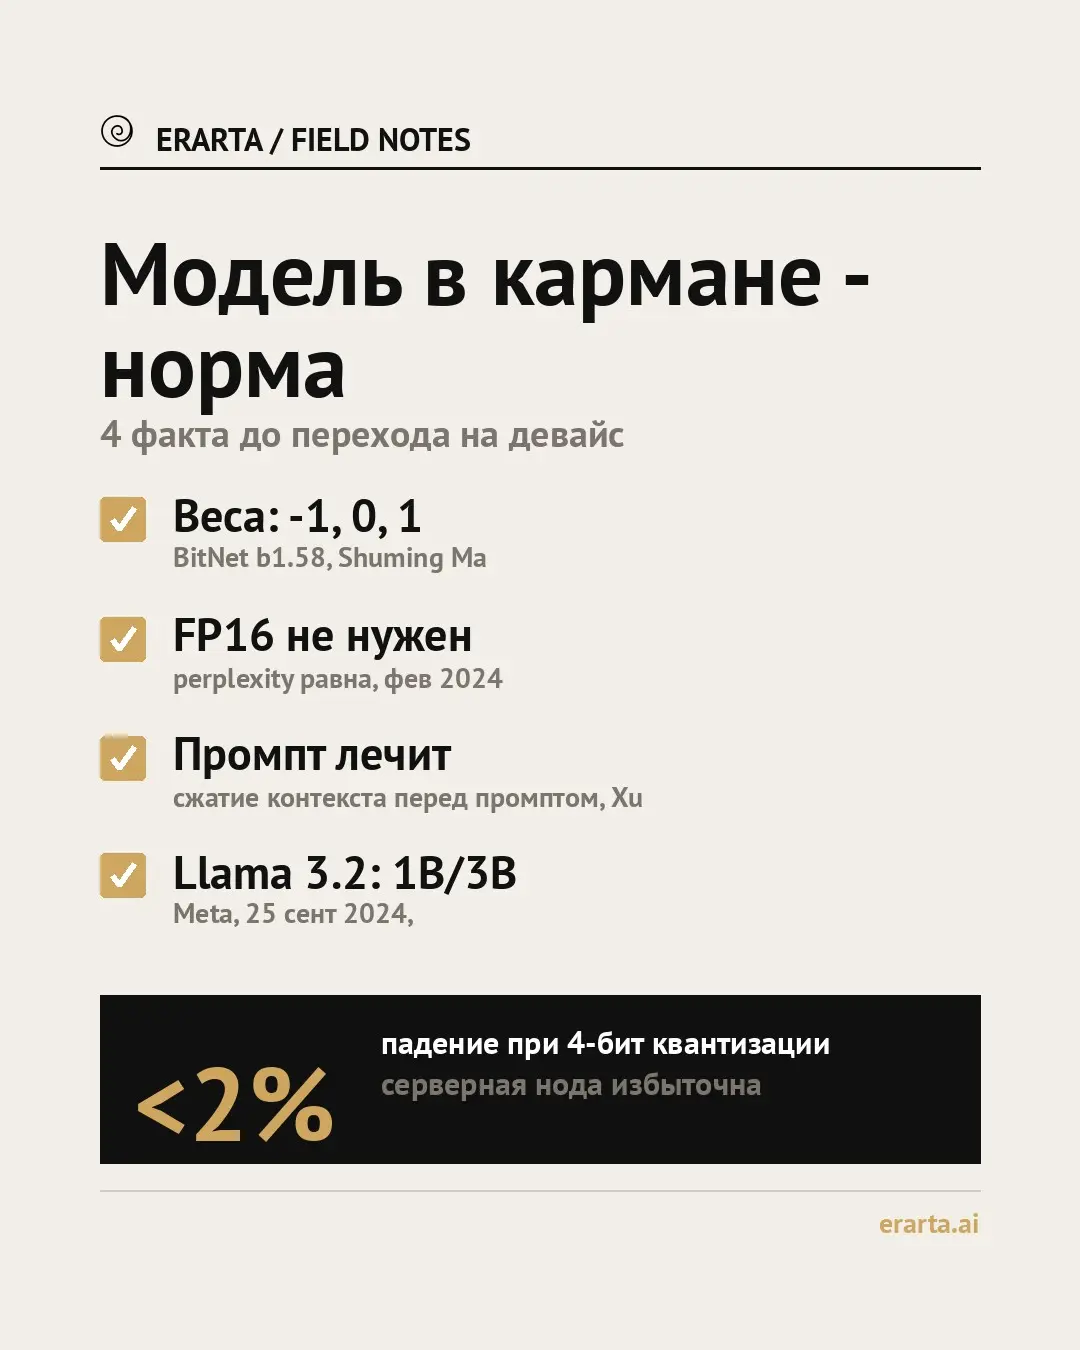
В феврале 2024 года команда Microsoft Research под руководством Shuming Ma представила BitNet b1.58 — модель, где каждый вес принимает только три значения: -1, 0, 1. Она сравнялась с полноразмерными FP16-трансформерами по perplexity и качеству на прикладных задачах, но при этом показала кратное преимущество по latency, памяти, пропускной способности и энергопотреблению.
Принято думать, что on-device LLM — это урезанные игрушки, не готовые к проду. На деле всё иначе: квантизация дошла до уровня, когда потери качества полностью компенсируются архитектурой.
Как это работает по шагам: 1. Агрессивная квантизация весов до тернарных значений убирает необходимость в умножениях с плавающей точкой. 2. Сжатую модель дополняют обучаемыми промптами. Подход «compress, then prompt», описанный Zhaozhuo Xu и соавторами, показал, что soft prompt восстанавливает качество ответов там, где сжатие давало просадку. 3. Фреймворки вроде MLX, Core ML и WhisperKit позволяют крутить такие модели прямо на девайсе, без походов на сервер.
И это уже устойчивый тренд. 25 сентября 2024 года Meta выпустила Llama 3.2 с моделями на 1B и 3B параметров, спроектированными специально для on-device запуска — через llama.cpp, MLC и Transformers.js. Смартфон стал полноценной платформой для инференса.
Для продуктовых команд вывод очевиден: в 2026 году делать ставку только на серверный inference — значит сознательно переплачивать за сетевые задержки и зависеть от коннекта. Платформа erarta.ai уже учитывает этот сдвиг, закладывая пайплайны с прицелом на mobile AI.
Простой тест для инженера: возьмите текущую рабочую модель, сожмите её до 4 бит и проверьте метрики на своих бенчмарках. Если просадка меньше 2% — отдельная серверная нода под эту задачу вам не нужна.
Фокус инженеров по инференсу смещается: от управления тяжелыми кластерами к оптимизации того, что должно помещаться в кармане пользователя.