OpenAI Whisper на CPU
Делая RAG-систему для одного клиента, столкнулся с невозможностью использовать вычисления на CUDA для Whisper из-за того, что клиент арендовал сервер в формате 1U, с невозможностью поставить GPU.
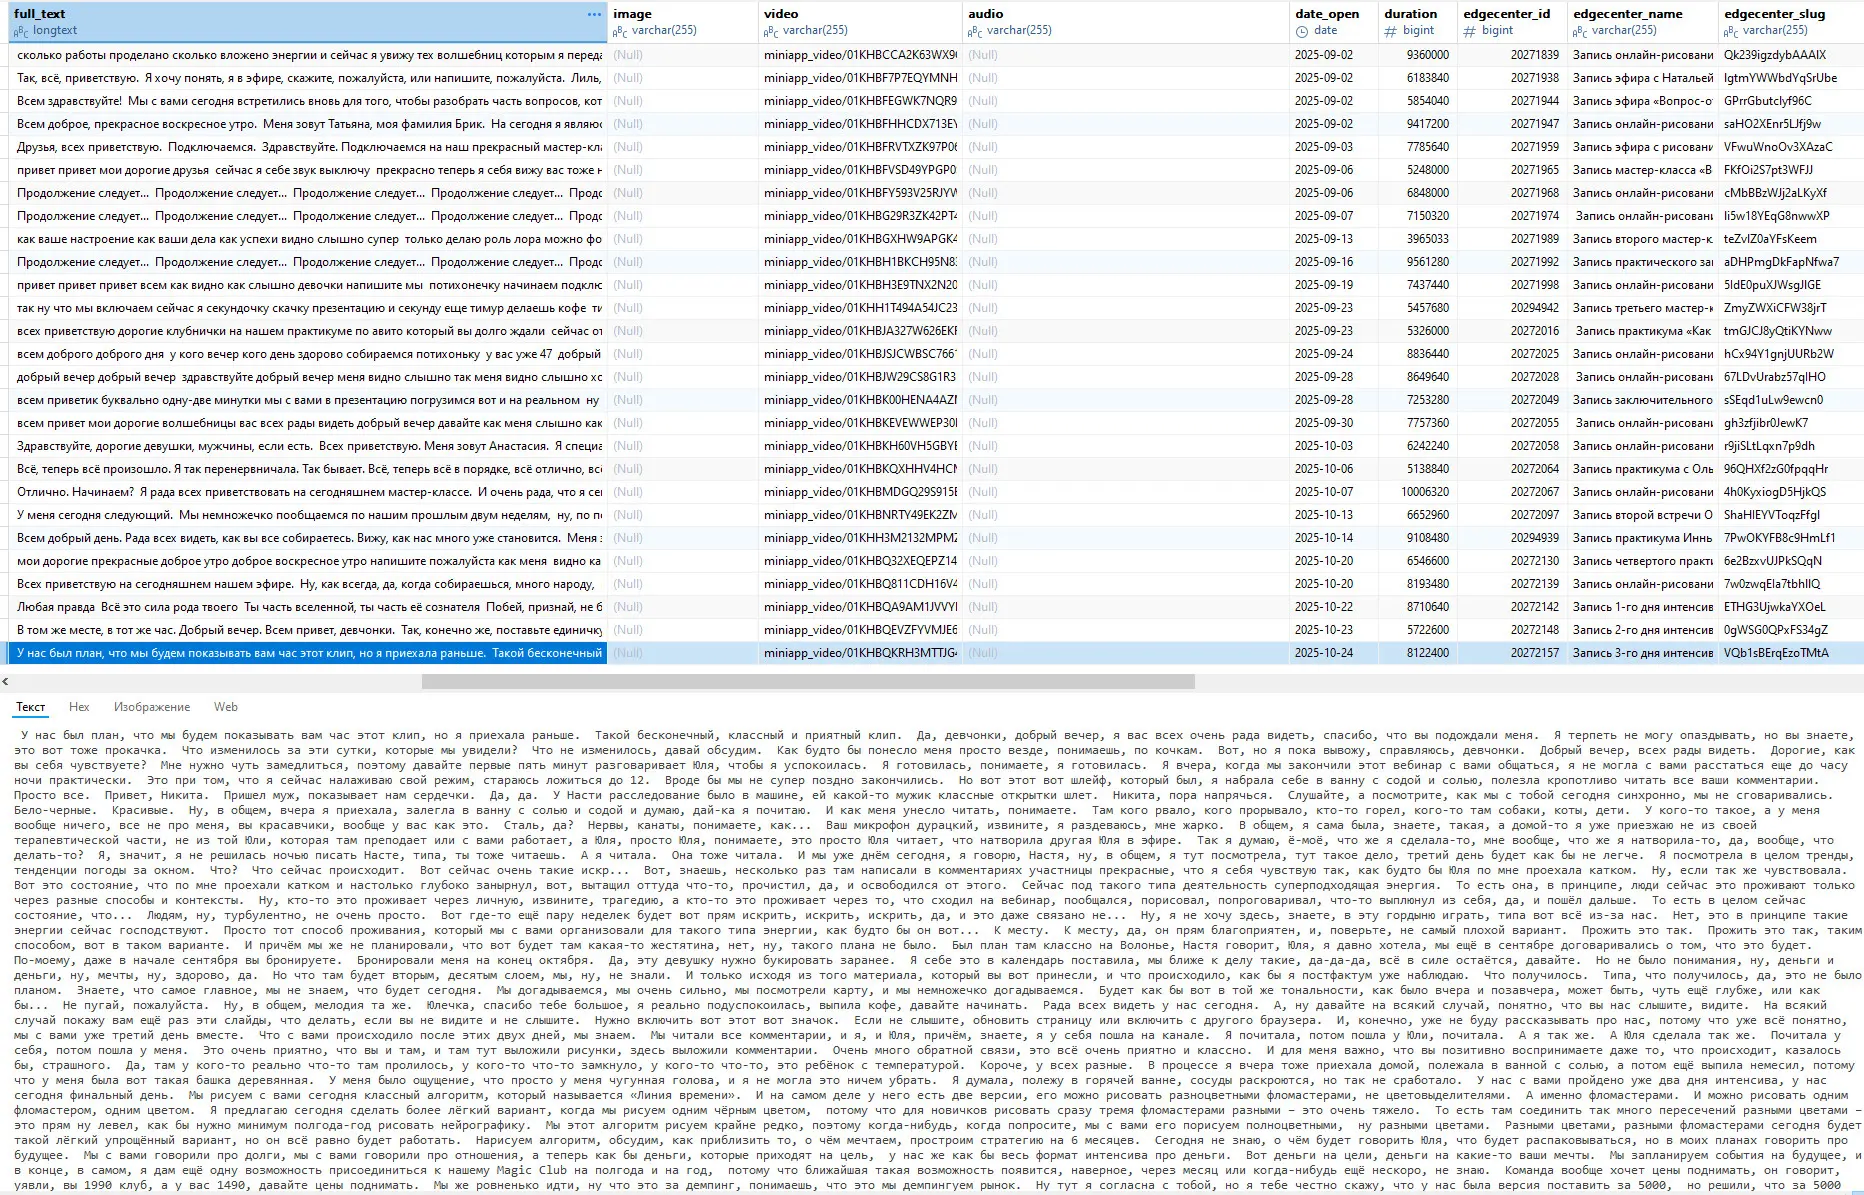
Задача - распознать в текст имеющуюся библиотку видео + сделать автораспознавание вновь загруженных видео.
Второй сервер клиент брать пока не хочет, т.к. система делается экспериментально для данной организации, и пока непонятно, насколько реально они это будут использовать.
Задача - обойтись имеющимися мощностями.
Ключевая проблема в том, что OpenAI Whisper работает экстремально медленно на CPU, если использовать для распознавания библиотеку large-v3
А medium и base-варианты допускают очень много опечаток для русской речи.
Неплохой вариант в этой ситуации - использовать FasterWhisper.
Библиотека оптимизирована под вычисления на CPU, используя алгоритмы квантования (в настройках указать режим int8 при вызове)
И в остальном - это порт оригинального OpenAI Whisper, я проверял итоговые результаты распознавания на нескольких видео, отличий не нашел.
Важно: НЕ использовать библиотеку large-v3-turbo, в ней всего 809 млн. параметров vs 1.55 млрд в large-v3, и это даёт опечатки в результате (проверено)
По итогу, FasterWhisper распознает 2хчасовое видео на CPU примерно за 5 часов.
Сильно быстрее, чем оригинальный от OpenAI (у того, думаю, ушло бы несколько суток, я так и не дождался завершения)
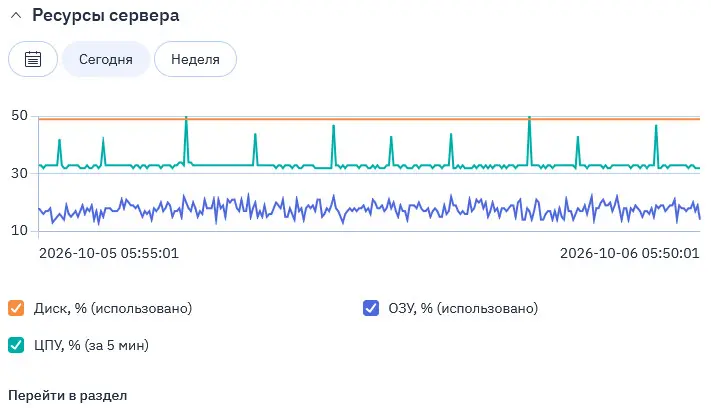
CPU клиента - 2 x Xeon Silver 4314 2.40 ГГц, больше чем на 50% Whisper его не нагружает, и вполне хватает обрабатывать все обычные задачи сервера + распознавать видео
Хороший вариант в ситуации, когда видео не очень много, и не хочется тратиться на GPU.