«Подтвердите, что вы не робот»: как нас заставили бесплатно оцифровать миллионы книг и натренировать беспилотники
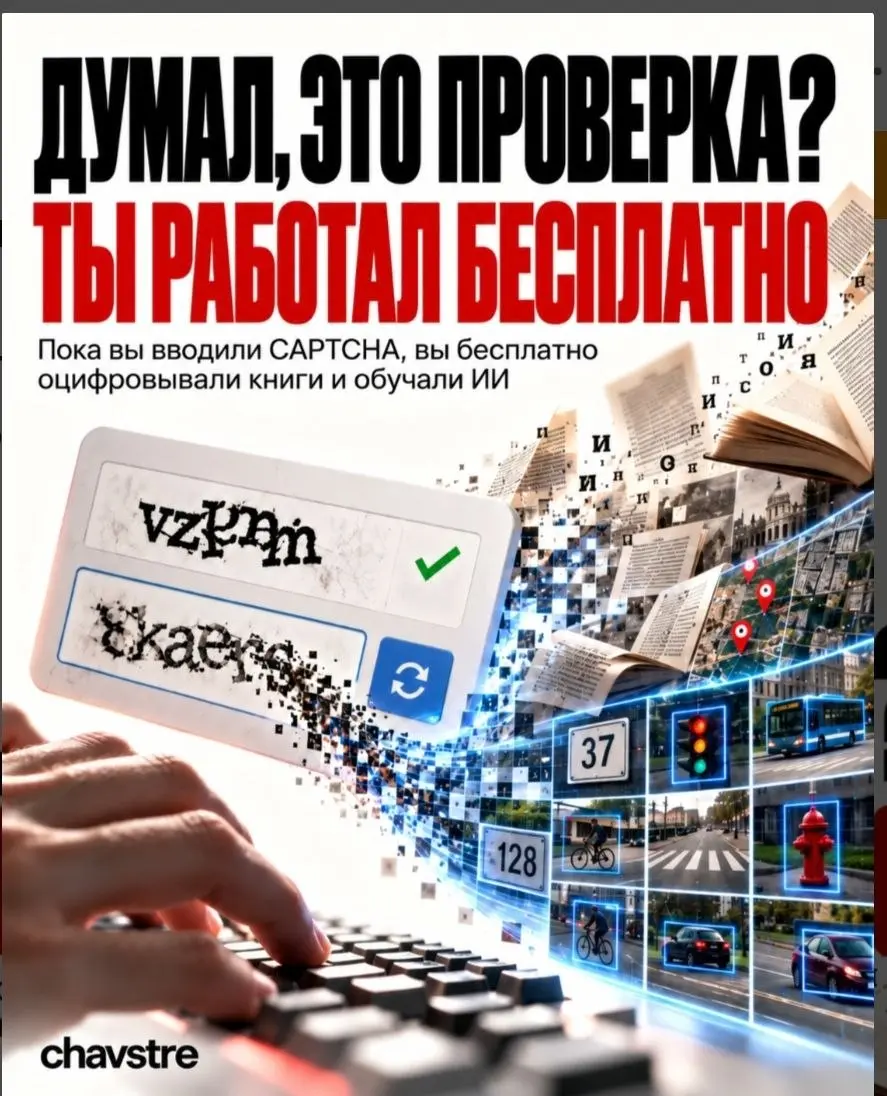
Помните старый интернет конца нулевых и эти невыносимо раздражающие окна проверки, где нужно было вводить два перекошенных, нечитаемых слова с экрана? - пишет RumBApp.
Каждый раз, когда вы психовали, щурились в монитор и чертыхались из-за опечатки, происходила одна вещь: вы бесплатно работали на крупнейшие корпорации мира. И второе слово в этом окне было нужно вовсе не для защиты сайта.
В начале 2000-х профессор Университета Карнеги — Меллона Луис фон Ан помог создать первую версию CAPTCHA, чтобы защитить сайты от спам-ботов. Идея выстрелила, но к 2007 году ученый ужаснулся масштабам: каждый день пользователи по всей планете вбивали около 200 миллионов капчей.
Фон Ан посчитал: в среднем человек тратит на разгадывание букв 10 секунд. В сумме человечество сжигало около 500 000 часов чистого времени и внимания ежедневно на совершенно бессмысленную ерунду.
Тогда ученому пришла в голову идея краудсорсинга века: а что, если эту колоссальную вычислительную силу людей направить на реальную задачу? Так родилась система reCAPTCHA.
Фокус крылся в том, почему слов всегда было именно два:
1. Первое слово система знала заранее. Это было контрольное слово. Если вы вводили его правильно, алгоритм ставил галочку: «Окей, перед нами живой человек, а не скрипт».
2. Второе слово компьютер НЕ ЗНАЛ.
В это время библиотеки и архивы массово переводили бумажные фонды в цифровой формат. Оптические сканеры (OCR) легко считывали свежую печать, но намертво спотыкались о старые фолианты, выцветшие чернила, помятые страницы и пятна от кофе. Машина не могла понять, что там написано.
И тогда эти нераспознанные «проблемные» фрагменты текста начали пачками нарезать на картинки и подсовывать пользователям в виде того самого второго слова.
Работало это по принципу перекрестной проверки: если одно и то же неразборчивое слово десять случайных людей из разных точек планеты расшифровывали одинаково (например, «morning»), система считала слово распознанным и вносила его в цифровую книгу.
Результаты поражали: миллионы людей, сами того не подозревая, вручную расшифровывали сложнейшие тексты с точностью 99,1%, обходя самые продвинутые суперкомпьютеры своего времени.
Через reCAPTCHA был целиком оцифрован гигантский бумажный архив газеты The New York Times с 1851 по 1980 год, а также миллионы редких томов для проекта Google Books.
В 2009 году Google купил компанию Луиса фон Ана за десятки миллионов долларов (к слову, позже этот же гениальный изобретатель создал Duolingo).
А когда печатные книги наконец закончились, Google нашел нам новую «работу».
Помните, как внезапно вместо слов из книг нам стали показывать странные размытые таблички с номерами домов? Это были фотографии со съемочных машин Google Street View, где искусственный интеллект не мог разобрать номер здания на заборе. Миллионы людей по всему миру бесплатно разметили для Google карты городов.
А затем появились те самые ненавистные сетки 3х3: «Выберите все светофоры, пожарные гидранты, пешеходные переходы и автобусы».
Книги кончились. Карты разметили. Теперь человечество бесплатно занимается обучением нейросетей для беспилотных автомобилей Waymo, объясняя машинному зрению, как в тумане и под дождем отличить дорожный знак от фонарного столба.
Каждый раз, доказывая бездушной машине, что вы не робот, вы просто учите робота быть человеком.