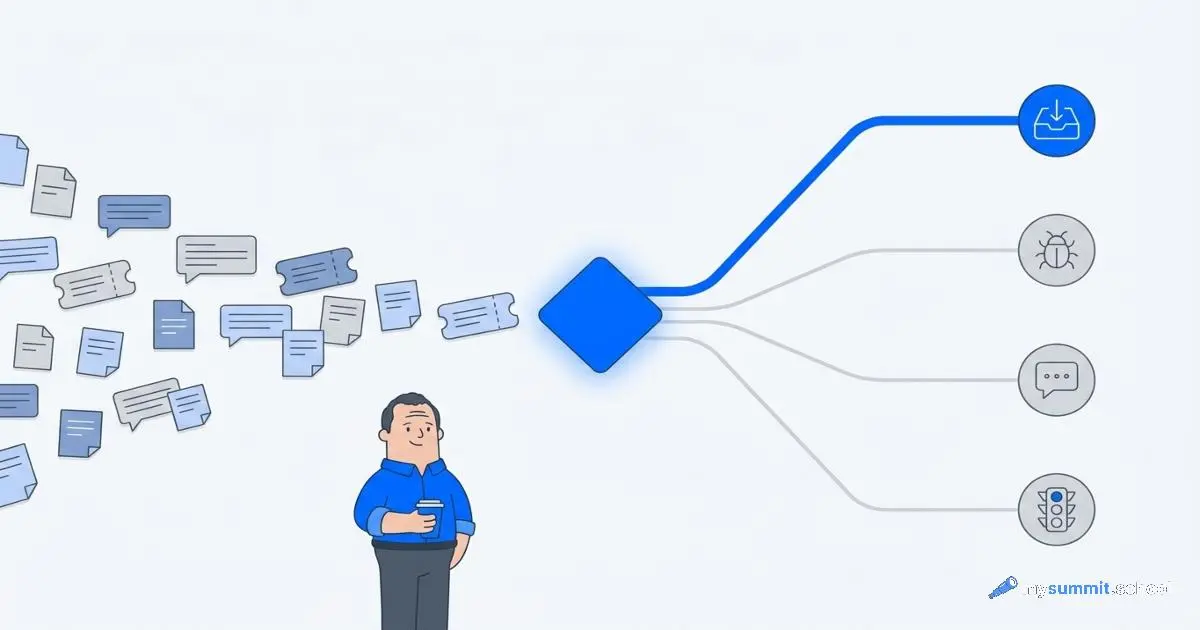
Посмотрел доклад про Jev – модель, которая на вход берет обычный текст, а на выходе отдает решение: оценку, класс, вероятность или вызов функции. Текста она не генерирует вообще.
Главная мысль доклада подкупает простотой. Думать про такую модель предлагают как про if/else в коде. Везде, где в программе стоит условие или switch, можно описать возможные ветки, и модель выберет нужную по фразе на естественном языке. Стоит это копейки: автор потратил 73 цента за 23 прогона во время разработки. А на разборе шахматной партии модель отработала в 10 раз быстрее обычной LLM и не потеряла в точности.
Но доклад для разработчиков. Мне было интересно другое: где в работе менеджера живут те самые if/else? Кажется, их достаточно много: • входящие запросы от других команд: чей это вопрос и кому его отдать • баги и инциденты: какой приоритет и чья зона • комментарии из опроса вовлеченности: на что жалуются и насколько остро • тикеты в бэклоге: готов ли тикет к работе по нашим же критериям • статусы проектов: зеленый, желтый или на самом деле красный
И тут работает идея, которую автор называет "эффективной неэффективностью". Сейчас мы проверяем выборку: пару тикетов на груминге, десяток комментариев из опроса, статус со слов тимлида. Когда одно решение стоит доли цента, можно проверить все. Перебор становится проще аккуратного отбора.
При этом автор прямо говорит, где такая модель не нужна: креатив, открытый анализ, задачи без заранее известных вариантов ответа. То есть примерно половина работы менеджера 🙂
Поэтому рекомендую посмотреть доклад: https://www.youtube.com/watch?v=dAIIaepNhQM. Подозреваю, что решений с заранее известными вариантами ответа в неделе любого менеджера больше, чем хочется признавать.