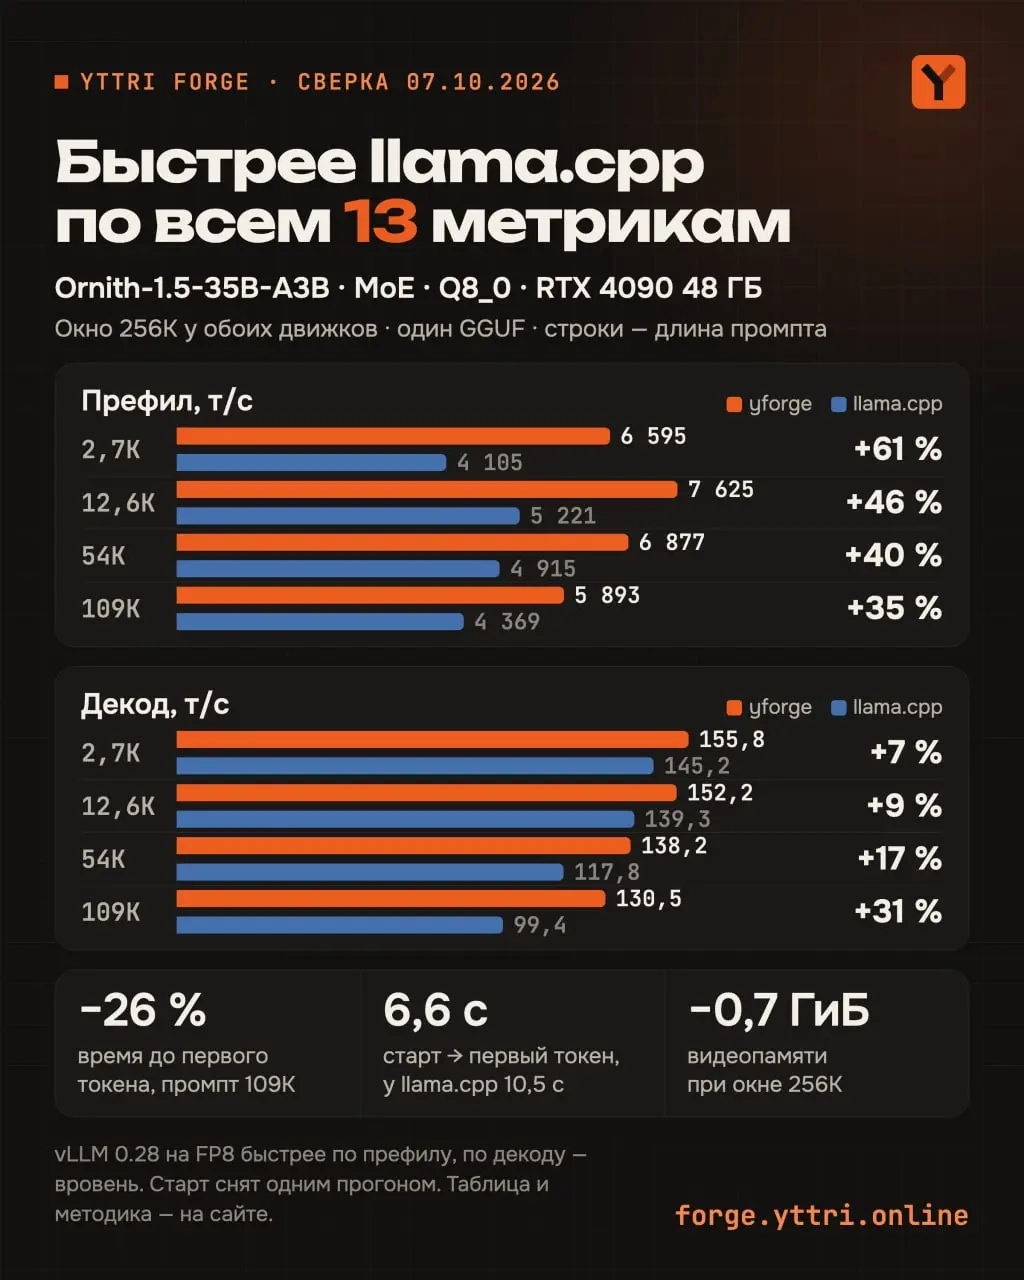
Обновил сайт Yttri Forge: новые результаты на MoE-модели. Мой yforge обошёл llama.cpp по всем 13 метрикам.
Модель Ornith-1.5-35B-A3B Q8_0, стенд RTX 4090 48 ГБ. У обоих движков один и тот же GGUF и окно 256K, как в проде.
Префил у yforge быстрее на 35–61 %. Отрыв по декоду растёт с длиной контекста: на самом длинном промпте +31 %.
По времени ядер движки шли вровень, но декод у yforge поначалу отставал: время съедал сэмплер. Перевёл отбор top-k с пула потоков на последовательный проход, и yforge вышел вперёд.
На сайт добавил и сравнение с vLLM 0.28 на официальной FP8. По префилу vLLM быстрее - считает его в FP8 на тензорных ядрах, а по декоду вровень.
Сайт: https://forge.yttri.online/
Исходники движка: https://github.com/askidmobile/yttri-forge
Скрипты замеров: https://github.com/askidmobile/qwen36-server/tree/main/scripts/bench/ornith-35b