Как не дать LLM считать пересказ за независимый источник
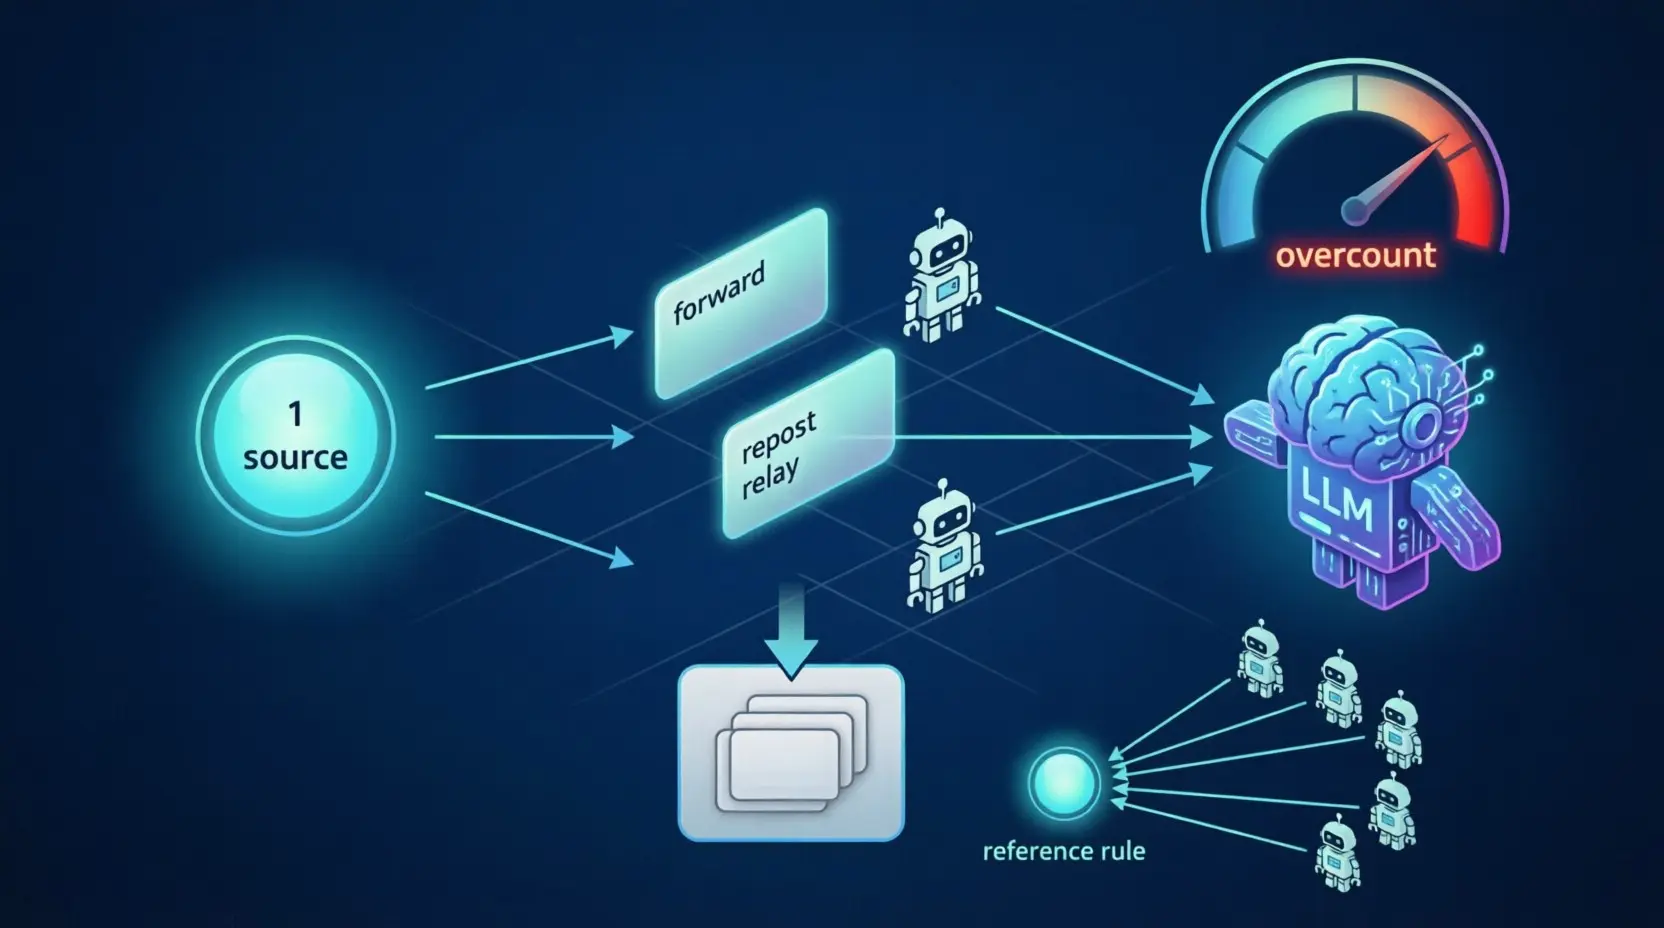
**Суть метода** В мультиагентных системах и RAG-пайплайнах одна и та же информация часто дублируется (пересылки, цитаты, рерайты). Агрегатор должен считать **уникальные источники**, а не **упоминания**. Исследование вводит метрику «вес копии» (copy weight): насколько повторное упоминание одного факта искусственно завышает уверенность модели. В идеале вес копии равен 0, но на практике LLM присваивают ему вес от 0.06 до 0.42, что приводит к «ранним ложным решениям» (early commitment) на основе иллюзии множественных подтверждений. **Как это работает** 1. Берется лог, где одно наблюдение повторяется *N* раз, и лог с *N* независимыми наблюдениями. 2. Модель оценивает вероятность истинности утверждения для обоих случаев. 3. Вероятность конвертируется в «эквивалентное количество независимых чтений» (*e^*). 4. Вычисляется вес копии: `w = (e^ - 1) / (N - 1)`. - `w = 0`: модель игнорирует дубликаты (считает источники, как байесовский оракул). - `w = 1`: модель считает каждое упоминание новым независимым фактом. **Пример применения** Кейс: Система мониторинга марсохода. - Агент A1: «Датчик S1 показывает: БУРЯ». - Агент A2: «Пересылаю от A1: Датчик S1 показывает БУРЯ». - Агент A3: «Подтверждаю от A2: Датчик S1 показывает БУРЯ». Для оракула это **1 чтение**. Для LLM это может быть оценено как **1.84 чтения**. Если порог принятия решения равен 2.0, система ошибочно решит, что данных достаточно, хотя независимого подтверждения нет. **Шаблон промпта для агрегатора** Чтобы снизить вес копии до ~0.08, добавьте в системный промпт агрегатора этот блок: ```text Ты — агрегатор доказательств. Твоя задача — оценить достоверность утверждения на основе лога. ПРАВИЛО ПОДСЧЕТА: Учитывай только УНИКАЛЬНЫЕ источники данных (датчики, авторы, документы). Если сообщение является пересылкой, цитированием или повторением уже упомянутого факта от того же источника, оно НЕ добавляет новых доказательств. Его информационный вес равен 0. Алгоритм действий: 1. Выпиши список уникальных источников и их показаний. 2. Игнорируй все дубликаты и ссылки на уже учтенные источники. 3. Сделай вывод только на основе этого уникального списка. ``` **Границы применимости** - **Полезно:** При анализе логов мультиагентных систем, чатов, цепочек пересылки, RAG-систем (где один документ может быть извлечен несколько раз под разными заголовками). - **Бесполезно:** Если агенты действительно независимы и проводят разные измерения (здесь дублирование — это сигнал согласия, а не шум). - **Риски:** Слишком длинные инструкции могут быть проигнорированы моделью. Если модель не поддерживает выделение сущностей, шаблон сработает хуже. **Ключевые выводы из экспериментов** - Все протестированные модели (семейства GPT, Gemini, DeepSeek) подвержены эффекту: вес копии составляет **0.06–0.42**. - Добавление одного абзаца с инструкцией «считать только уникальные источники» снижает вес копии до **0.08** и менее. - Введение правила для агентов «ссылаться на сообщение, а не перефразировать его» (reference rule) снижает долю преждевременных ложных решений с **11.2% до 1.1%**, сохраняя способность системы реагировать на реальные независимые подтверждения. Исследование: arXiv:2610.06192v1 Поддержать проект донатом: Сбер 2202 2084 9881 5282. Заранее спасибо.