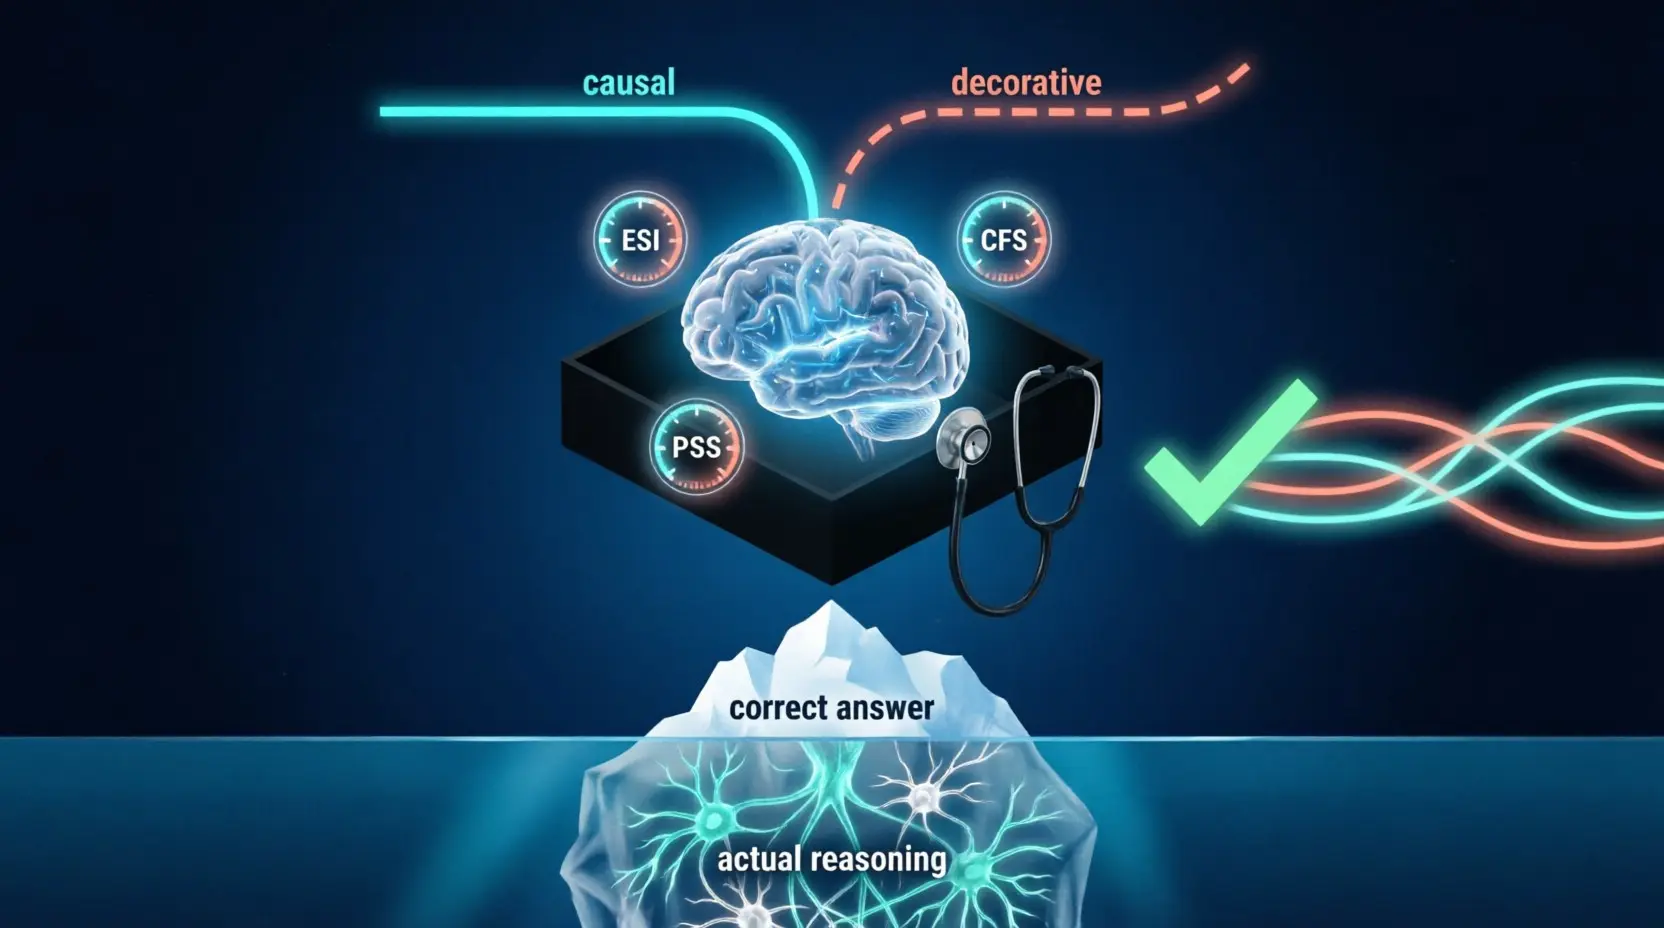
Реальны ли причины, которые называет LLM
**Суть метода** Правильный ответ LLM не гарантирует, что модель действительно использовала указанные в объяснении аргументы для его получения. Исследование доказывает: точность, согласованность и консенсус моделей — ложные индикаторы надежности рассуждений. Модель может угадать ответ, а объяснение сгенерировать постфактум, не отражая реальный механизм принятия решения. **Как это работает (алгоритм проверки)** Для оценки **верности рассуждений (faithfulness)** применяются три легкие поведенческие метрики: 1. **Explanation Stability Index (ESI)**: повторный запрос того же вопроса. Оценивает стабильность аргументов в объяснениях при множественной генерации. 2. **Causal Faithfulness Score (CFS)**: тест на причинность. Из объяснения извлекаются ключевые концепции. Затем они удаляются (абляция) или инвертируются в контексте. Если итоговый ответ модели не меняется, значит, эти концепции не влияли на решение, а были «придуманы» для оправдания. 3. **Perturbation Stability Score (PSS)**: устойчивость к перефразированию. Меняем формулировку запроса без смены смысла. Если аргументация радикально меняется, надежность низкая. **Ключевые выводы из экспериментов** - Только **23,3%** упомянутых в объяснениях концепций были причинно необходимыми для ответа. - Парадокс: правильные ответы имели **более низкий** CFS, чем неправильные (0,212 против 0,398). Модель чаще «подгоняет» объяснение под верный ответ. - Согласованность ответов отрицательно коррелирует с качеством рассуждений (r = -0,466). - Две модели могут дать одинаковый правильный ответ, но обосновать его совершенно разными (пересечение всего **8,8%**) концепциями. **Пример применения: Проверка юридического или медицинского совета** Допустим, LLM советует «не подписывать договор» и указывает причину: «отсутствие пункта о форс-мажоре». 1. *Запрос 1*: «Проанализируй договор. Есть ли риски?» → LLM: «Риск высок, так как нет пункта о форс-мажоре». 2. *Абляция (CFS)*: Мы искусственно добавляем в контекст идеальный пункт о форс-мажоре и спрашиваем снова. 3. *Запрос 2*: «Проанализируй договор (с форс-мажором). Есть ли риски?» → Если LLM всё равно говорит «Риск высок» или меняет причину на другую, значит, первоначальное объяснение было ложным (постфактум). **Шаблон промпта для проверки CFS (Абляция концепции)** ```text Твоя задача — проверить логическую связь между фактом и выводом. Исходный вывод: [ВСТАВИТЬ ВЫВОД МОДЕЛИ] Ключевая причина из объяснения: [ВСТАВИТЬ КОНЦЕПЦИЮ, например, "отсутствие пункта Х"] Теперь представь гипотетическую ситуацию, где эта причина НЕВЕРНА или УСТРАНЕНА: [ОПИСАНИЕ СИТУАЦИИ, где пункт Х присутствует или фактор изменен на противоположный]. Вопрос: При этом новом условии, изменится ли исходный вывод? 1. Если да, объясни почему (это признак высокой причинной верности). 2. Если нет, и ты находишь новую причину, укажи это прямо (это признак низкой причинной верности исходного объяснения). ``` **Границы применимости** - **Полезен**: В высокорисковых областях (медицина, право, финансы, аудит кода), где критична интерпретируемость и возможность проверить цепочку рассуждений. - **Бесполезен**: Если нужен только конечный результат (бинарная классификация, суммаризация) без строгих требований к объяснимости. - **Риски**: Метод поведенческий, он проверяет чувствительность выхода, а не внутренние веса модели (не является механистической интерпретируемостью). Грубая автоматическая абляция может исказить исходный контекст так, что задача станет некорректной, что даст ложноотрицательный результат. Исследование: 2609.32817 Поддержать проект донатом: Сбер 2202 2084 9881 5282. Заранее спасибо.