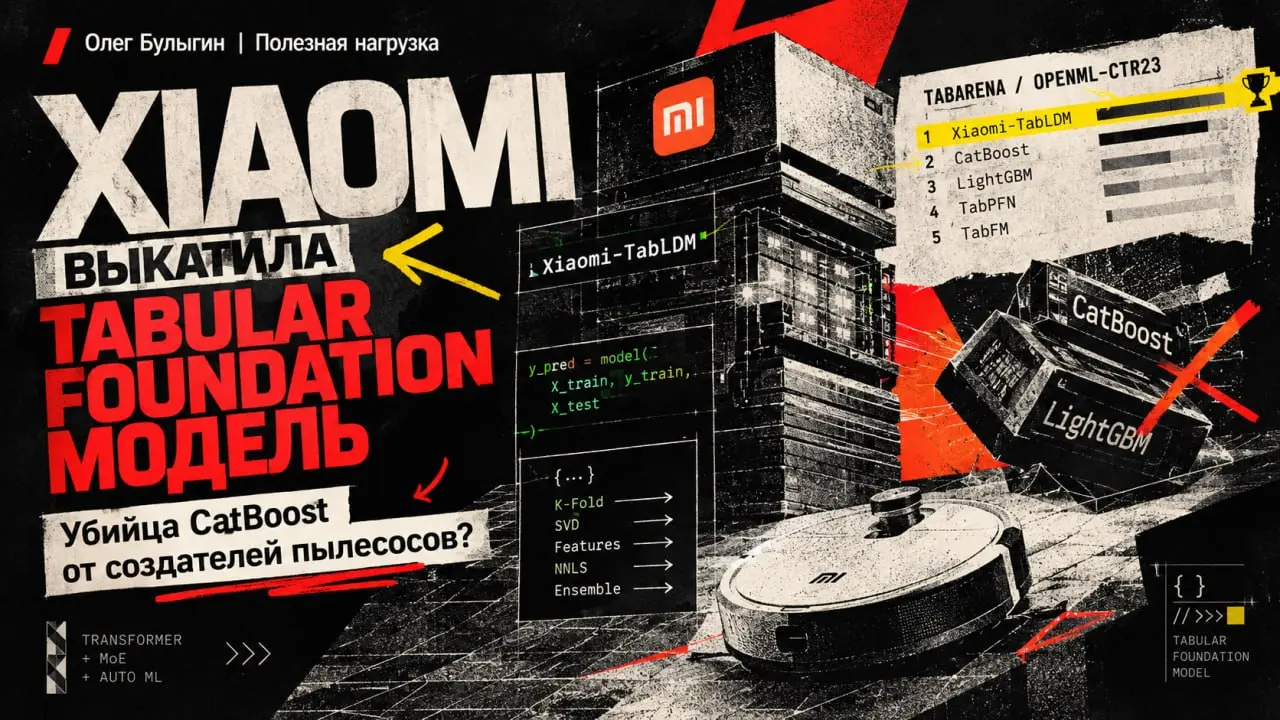
Xiaomi выкатила tabular foundation модель. Убийца CatBoost от создателей пылесосов? 📱⚡️
Xiaomi выкатила в открытый доступ Xiaomi-TabLDM — табличную foundation-модель, которая якобы затыкает за пояс CatBoost, LightGBM и предыдущие попытки в табличный deep learning (TabPFN, TabFM). Модель действительно мощная и берет призовые места на бенчмарках TabArena и OpenML-CTR23. Но если залезть под капот репозитория, выясняется занятная вещь: перед нами не просто «одна большая умная нейросеть», а ядреный соревновательный AutoML-пайплайн, завернутый в обертку инференса трансформера с MoE.
Что накрутили в архитектуре 🏗
Для тех, кто пропустил эволюцию табличных сеток: TabLDM работает по принципу контекстного обучения (ICL). Вы вызываете стандартный для scikit-learn метод clf.fit(X_train, y_train), но модель не обучает веса. Она просто готовит входные данные. На инференсе и обучающая выборка, и тестовые объекты скармливаются в трансформер за один проход: y_pred = model(X_train, y_train, X_test). Весь опыт модель получила заранее на претрейне — причем Xiaomi учила ее исключительно на синтетических данных, сгенерированных структурными каузальными моделями (SCM).
Регрессия, кстати, предсказывает не одно число, а сразу 999 квантилей, которые потом сглаживаются сплайнами и обобщенным распределением Парето (GPD) через оценщик Пикандса для моделирования тяжелых хвостов. По хардкору, крч.
Грязный секрет бенчмарков: возвращение на Kaggle 🕵️♂️
А теперь смотрим на то, за счет чего модель на самом деле выбивает высокие скоры на бенчмарках.
В коде есть флаг enhance_candidates=True (включен по умолчанию). Когда вы вызываете fit(), библиотека втихую запускает внутри себя: — Стратифицированный K-Fold кросс-валидацию; — Генерацию пачки представлений датасета: перемешивание признаков через латинские квадраты, квантильные трансформации, Gaussian Rank нормализацию; — Автоматическое вычисление SVD-компонент и генерацию попарных произведений числовых признаков; — Сбор out-of-fold предсказаний по всем этим группам кандидатов; — И вишенка на торте: решение задачи неотрицательных наименьших квадратов (scipy.optimize.nnls) для подбора оптимальных весов ансамбля!
То есть модель буквально берет классические приемы с Kaggle десятилетней давности, автоматизирует их и выдает взвешенный ансамбль. Плохо ли это? Нет, это чертовски эффективно с точки зрения метрик. Но называть это «чистым предиктом одной нейросети» — лукавство. Это полноценный ансамблевый комбайн на этапе инференса.
💼 Катить ли это в прод?
Если у вас табличка на 1 000 – 3 000 строк, где лень крутить Optuna и подбирать пайплайн нормализации — TabLDM выдаст околосотовое качество из коробки прямо в один predict().
Но если у вас в проде крутятся 200 000+ строк, никакой кластер H100 с FlashAttention вас не спасет от чудовищных накладных расходов. Пока трансформер будет задыхаться от сложности контекста и роутинга экспертов, CatBoost или LightGBM на обычном CPU досчитают за две секунды и займут свои пару мегабайт памяти.
Хорошая игрушка для быстрых бейзлайнов и датасетов скромного размера. Но градиентный бустинг на пенсию пока не собирается.