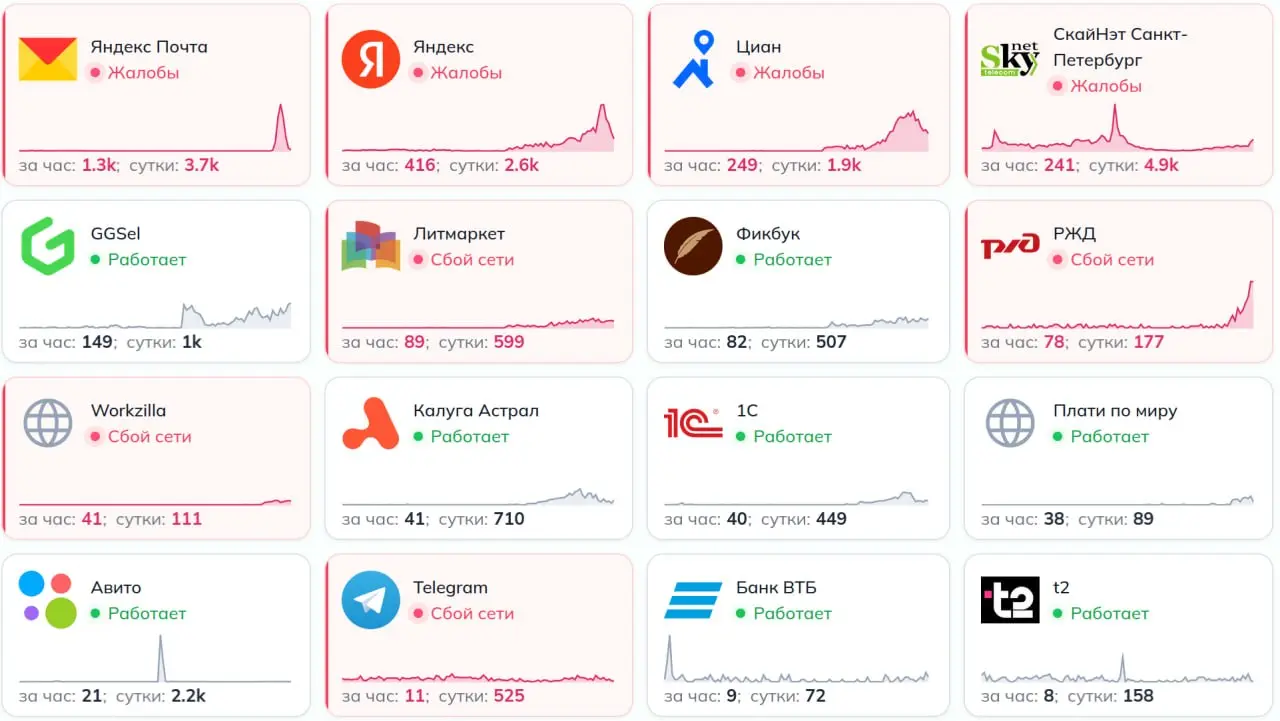
В дата-центре Яндекса в Сасово в результате атаки БПЛА произошел пожар, затронувший часть инфраструктуры. Пострадавших нет, профильные службы на месте устраняют последствия. Работа дата-центра полностью остановлена, часть сервисов Яндекса может быть недоступна для пользователей. Помимо того, что видно на радаре downdetector ещё есть проблемы у сайтов ряда девелоперов, ГК Астрал и mymeet.ai. Говорят, ещё сайт Шереметьево лежал, но уже починили.
Коллегам из Яндекса - удачи, крепких нервов и сил. Надеюсь, последствия пожара будут устранены быстро, и зона вернётся в строй.
Ну и нельзя не сказать про #drp (можно, кстати, поискать по этому тэгу другие мои посты на эту тему).
1. DRP - это не "две копии прода". Это план на случай, когда "всё очень плохо". И главное, от чего нужно отталкиваться - какое время простоя допустимо для вашего бизнеса. И да, я знаю, что "ноль" - это любимый ответ, но если бизнес готов за этот "zero downtime" заплатить - почему нет? Но обычно не хотят, и получается договориться на более приемлемое время.
2. DRP должен быть актуальным и регулярно проверяться. Иначе это не план, а просто бумажка. Поэтому учения (переключение нагрузки, восстановление из бэкапов) - наше всё.
3. Если у вас не хватает компетенций, или вы просто не знаете, как подойти к этому снаряду - обратитесь к профессионалам. Например к AdminDivision или Володе Федоркову. Они этим давно и плотно занимаются, рекомендую.
4. Архитектура вашего приложения должна быть распределённой. В самом лайтовом сценарии - храните бэкапы отдельно от прода. Используйте разные дата-центры, разные облака. Точки присутствия на разных концах Москвы - это хорошо, но Москва и СПб - ещё лучше. И дело тут не столько в прилётах разного плохого, сколько в повышении шансов на выживаемость. Потому что сломаться-то может даже не у вас, но ваш сервис будет недоступен для клиентов, и потери будут тоже вашими.
@snakeslair #thereisnoclouds
В этом посте были ссылки, но мы их удалили по правилам Сетки